
مقالات و اخبار تکنولوژی
سرور HGXH100 Platform: راهنمای کامل ساخت سرور AI سفارشی


- نویسنده: تیم فنی زیرساخت
- بازبینی فنی: تیم تحقیق و توسعه (R&D) سختافزار
- آخرین بهروزرسانی: 14 دی 1404
- زمان مطالعه: حدود ۱۸ دقیقه
- منابع و مراجع:
- مستندات فنی پلتفرم NVIDIA HGX H100 و وایتپیپرهای معماری Hopper
- استانداردهای Open Compute Project (OCP) برای طراحی سرور
- دادههای عملکردی بنچمارکهای MLPerf و HPL-AI
پاسخ سریع» (Quick Answer): سرور HGX H100 چیست و چه تفاوتی با DGX دارد؟
پلتفرم HGX H100 یک راهکار مدولار و مرجع از NVIDIA است که به عنوان قلب تپنده سرورهای هوش مصنوعی عمل میکند. برخلاف سیستمهای آماده DGX که یک محصول کامل و بسته هستند، HGX به سازمانها و سازندگان سرور (OEM) اجازه میدهد تا یک سیستم سفارشی با ۸ پردازنده گرافیکی H100، حافظه ۶۴۰ گیگابایتی و ارتباطات NVLink نسل چهارم بسازند. این پلتفرم برای کسانی مناسب است که نیاز به انعطاف در انتخاب CPU (اینتل یا AMD)، نوع حافظه، ذخیرهسازی و سیستم خنککننده متناسب با دیتاسنتر خود دارند.
نکات کلیدی برای تصمیمگیری: اگر به دنبال راهاندازی سریع و بدون دردسر هستید و بودجه کافی دارید، سیستمهای آماده DGX بهترین گزینهاند. اما اگر میخواهید هزینهها را تا ۳۰٪ کاهش دهید (صرفهجویی حدود ۱۵۰ هزار دلار در هر نود) و زیرساخت فعلیتان نیازمند تطبیق خاصی است (مثلاً معماری خاص شبکه یا کولینگ مایع)، ساخت سرور مبتنی بر HGX H100 منطقیتر است. توجه داشته باشید که مسیر HGX نیازمند دانش فنی بالا برای یکپارچهسازی، تأمین قطعات و مدیریت حرارت ۵.۶ کیلوواتی این سیستم است.
مقدمه: نیاز صنعت به راهحلهای منعطف
در دنیای امروز که هوش مصنوعی به رقابت اصلی شرکتهای فناوری تبدیل شده، داشتن زیرساخت محاسباتی قدرتمند دیگر یک انتخاب نیست بلکه یک ضرورت است. هر روز شرکتهای بیشتری متوجه میشوند که برای رقابت در عرصه AI، نیاز به سختافزاری دارند که بتواند مدلهای زبانی عظیم را آموزش دهد، استنتاج سریع انجام دهد و محاسبات علمی پیچیده را به انجام برساند. اما مسیر این سرمایهگذاری همیشه واضح نیست و سوالات زیادی پیش میآید: آیا باید یک سیستم آماده مانند DGX H100 خریداری کنیم یا بهتر است سرور سفارشی بسازیم؟ کدام راهحل از لحاظ هزینه مقرونبهصرفهتر است؟ چگونه میتوانیم سیستمی بسازیم که دقیقاً با نیازهای خاص ما همخوانی داشته باشد؟
پاسخ به این سوالات در درک یک محصول کلیدی NVIDIA نهفته است: سرور HGX H100. این پلتفرم که به نوعی پل ارتباطی بین فناوریهای پیشرفته NVIDIA و نیازهای متنوع صنعت است، امکانی بینظیر را فراهم میکند. HGX H100 در واقع یک baseboard مرجع است که شامل هشت GPU H100، سوئیچهای NVLink و زیرساخت ارتباطی با پهنای باند بالاست، اما بر خلاف سیستمهای DGX که بهصورت کامل و آماده عرضه میشوند، HGX به سازندگان سرور (OEM ها) این امکان را میدهد که سیستمهای سفارشی خود را بر اساس نیازهای خاص مشتریان طراحی کنند.
این رویکرد مدولار مزایای متعددی دارد. اول اینکه، شرکتها میتوانند پردازنده CPU مورد نظر خود را انتخاب کنند؛ برخی ممکن است AMD EPYC را ترجیح دهند، برخی دیگر Intel Xeon. دوم اینکه، میتوان حافظه RAM، ذخیرهساز، شبکه و سایر اجزا را دقیقاً متناسب با کاربرد خود پیکربندی کرد. سوم اینکه، امکان یکپارچهسازی با زیرساخت موجود مرکز داده وجود دارد؛ شاید شما قبلاً سیستم خنککاری خاصی داشته باشید یا معماری رکهای خود را بر اساس استانداردهای خاصی طراحی کرده باشید. با HGX، میتوانید سروری بسازید که کاملاً با این زیرساخت هماهنگ باشد، بدون اینکه مجبور شوید تمام سیستمهای خود را تغییر دهید.
در این مقاله جامع، قصد داریم به تمام جنبههای پلتفرم سرور HGX H100 بپردازیم. از معماری فنی آن گرفته تا مقایسه با سیستمهای DGX، از فرآیند یکپارچهسازی تا محاسبه هزینهها، و از چالشهای احتمالی تا بهترین شیوههای پیادهسازی. اگر شما مدیر IT هستید که به دنبال بهترین راه برای ساخت زیرساخت AI سازمان خود است، یا مهندسی که میخواهد یک سرور AI سفارشی طراحی کند، یا حتی تصمیمگیرندهای که باید بین خرید DGX یا ساخت سیستم با HGX انتخاب کند، این مقاله همه چیزی که نیاز دارید را در اختیارتان قرار میدهد.
HGX Baseboard چیست؟ معماری قلب سیستم
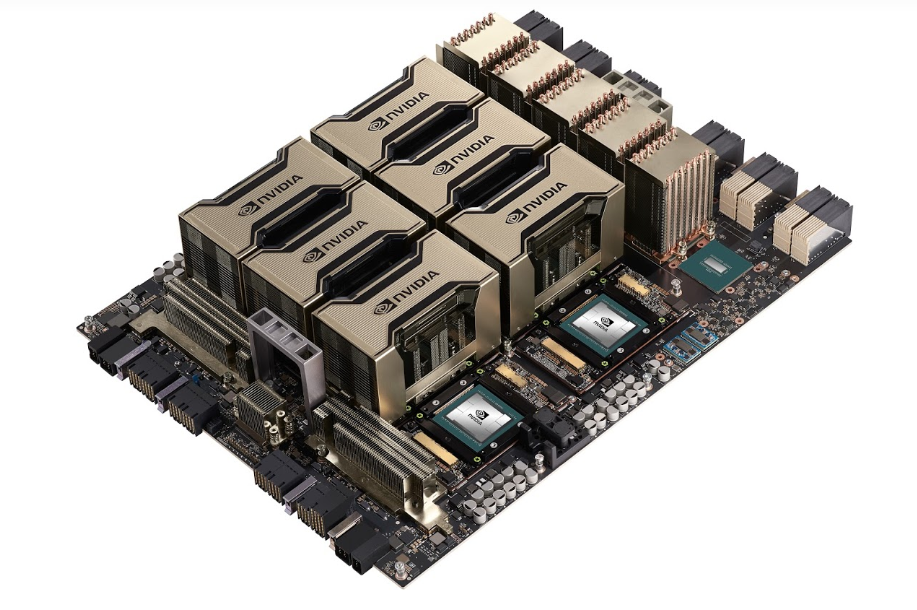
برای درک کامل پلتفرم سرور HGX H100، ابتدا باید با مفهوم baseboard آشنا شویم. در اصطلاح ساده، baseboard یک برد مدار چاپی (PCB) بزرگ است که تمام اجزای حیاتی محاسبات GPU-محور را در خود جای داده است. اما HGX baseboard چیزی بسیار فراتر از یک برد الکترونیکی معمولی است؛ این یک اکوسیستم یکپارچه محاسباتی است که NVIDIA با دقت بالایی طراحی کرده تا بهترین عملکرد ممکن را از GPU های H100 بیرون بکشد.
سرور HGXH100 baseboard در دو پیکربندی اصلی عرضه میشود: نسخه 4-GPU و نسخه 8-GPU. نسخه 8-GPU که محبوبترین انتخاب برای کارهای AI سنگین است، شامل هشت ماژول H100 SXM5 میشود که هرکدام 80 گیگابایت حافظه HBM3 دارند، یعنی در مجموع 640 گیگابایت حافظه GPU. اما آنچه این baseboard را واقعاً استثنایی میکند، نحوه ارتباط این GPU ها با یکدیگر است. در قلب این معماری، چهار تراشه NVSwitch نسل سوم قرار دارند که بهعنوان یک فابریک ارتباطی کامل عمل میکنند.
هر GPU در HGX H100 میتواند از طریق NVLink نسل چهارم با سرعت 900 گیگابایت بر ثانیه با هر GPU دیگری ارتباط برقرار کند. این یعنی هیچ گلوگاهی در ارتباط بین پردازندهها وجود ندارد؛ یک توپولوژی کاملاً متصل (fully-connected topology) که به هر GPU امکان میدهد مستقیماً با هفت GPU دیگر صحبت کند بدون اینکه نیازی به عبور از واسطه باشد. این معماری برای کارهای توزیعشده مانند آموزش مدلهای زبانی بزرگ که نیاز به تبادل مداوم داده بین GPU ها دارند، حیاتی است. در یک سناریوی آموزش مدل GPT با صد میلیارد پارامتر، هر GPU باخشی از وزنهای مدل را نگه میدارد و باید مرتباً gradient ها را با دیگر GPU ها هماهنگ کند. با NVSwitch، این هماهنگسازی با حداقل تأخیر انجام میشود.
علاوه بر GPU ها و NVSwitch، HGX baseboard شامل واحدهای مدیریت حرارت، کنترلکنندههای توان، و رابطهای ورودی/خروجی برای اتصال به بقیه سیستم است. برد دارای کانکتورهای PCIe Gen5 برای ارتباط با CPU، اسلاتهای حافظه، و شبکه میزبان است. همچنین یک واحد BMC (Baseboard Management Controller) تعبیه شده که امکان مانیتورینگ از راه دور، مدیریت توان و عیبیابی را فراهم میکند. این سطح از یکپارچگی یعنی سازندگان سرور دیگر نیازی ندارند نگران طراحی مدارهای پیچیده ارتباطی GPU باشند؛ تمام این کار توسط NVIDIA انجام شده و آنها فقط باید baseboard را در شاسی و سیستم خنککاری خود تعبیه کنند.
HGX baseboard همچنین با استاندارد Open Compute Project (OCP) سازگار است. NVIDIA مشخصات فیزیکی HGX را به جامعه OCP اهدا کرده که به معنای این است که هر سازندهای میتواند براساس این طرح مرجع، سیستمهای سازگار بسازد. این رویکرد باز باعث شده که انعطافپذیری بیشتری در صنعت ایجاد شود و سازندگان مختلف بتوانند نوآوریهای خود را به این پلتفرم اضافه کنند. برای مثال، برخی سازندگان سیستمهای HGX با خنککاری مایع مستقیم (direct liquid cooling) ساختهاند که اجازه میدهد تراکم بالاتری از GPU ها در رک نصب شود، در حالی که برخی دیگر بر روی خنککاری هوایی تمرکز کردهاند که نصب و نگهداری آسانتری دارد.
ماشینحساب انتخاب زیرساخت AI
هدف اصلی دیتاسنتر شما چیست؟
وضعیت زیرساخت کولینگ و تیم فنی شما چگونه است؟
مقیاس پروژه (تعداد سرور مورد نیاز)؟
این محاسبه بر اساس قیمتهای جهانی و دیتای فنی مقاله است.
DGX vs HGX: دو مسیر متفاوت برای یک هدف

یکی از سوالاتی که اغلب از ما در سوان تک پرسیده میشود این است: «تفاوت DGXسرور و سرور HGX چیست و کدام را باید انتخاب کنیم؟» برای پاسخ به این سوال، باید ابتدا استراتژی NVIDIA را در بازار درک کنیم.
NVIDIA DGX یک سیستم کامل و یکپارچه است که مستقیماً توسط NVIDIA طراحی، ساخته و پشتیبانی میشود. وقتی یک DGX H100 خریداری میکنید، یک کارتن جامع دریافت میکنید که شامل سختافزار، نرمافزار، سیستمعامل DGX OS، ابزارهای مدیریتی و پشتیبانی مستقیم از NVIDIA است. این سیستمها از قبل تست شدهاند، بهینهسازیهای نرمافزاری روی آنها انجام شده و اساساً آماده استفاده هستند. فقط کافی است پلاگین کنید و کارتان را شروع کنید. DGX برای سازمانهایی طراحی شده که میخواهند سریع وارد عمل شوند، نمیخواهند وقت خود را صرف یکپارچهسازی سیستم کنند، و ترجیح میدهند از یک راهحل تضمینشده و پشتیبانیشده استفاده کنند. برای محققان دانشگاهی، استارتاپهای AI، یا بخشهای R&D شرکتهای بزرگ که میخواهند سریع روی الگوریتمهای خود کار کنند، DGX انتخابی عالی است.
از طرف دیگر، سرور HGX یک پلتفرم مرجع است، نه یک محصول نهایی. NVIDIA این baseboard را به سازندگان سرور (OEM) مانند Dell، HPE، Lenovo، Supermicro، ASUS و دیگران میفروشد تا آنها بتوانند سیستمهای سفارشی خود را بسازند. این یعنی شما مستقیماً نمیتوانید یک «HGX H100» از NVIDIA بخرید، بلکه باید یک سرور مبتنی بر HGX از یکی از شرکای OEM خریداری کنید یا خودتان با استفاده از این baseboard، سیستم سفارشی بسازید. مزیت اصلی HGX در انعطافپذیری آن است. شما میتوانید انتخاب کنید که از چه پردازنده CPU استفاده شود، چه مقدار RAM نصب شود، چه نوع ذخیرهسازی (NVMe، SAS، یا ترکیبی)، چه کارتهای شبکه (InfiniBand، Ethernet با سرعت بالا)، و حتی چه سیستم خنککاری (هوایی یا مایع) استفاده شود.
بیایید با یک مثال ملموس این تفاوت را روشنتر کنیم. فرض کنید یک شرکت بزرگ تولیدی دارید که میخواهید یک کلاستر AI برای بهینهسازی خط تولید بسازید. شما قبلاً یک مرکز داده با معماری مبتنی بر AMD EPYC دارید و تمام ابزارهای مدیریتی و مانیتورینگ شما برای این پلتفرم تنظیم شده است. اگر DGX بخرید که با پردازنده Intel یا Grace-Hopper عرضه میشود، باید یا زیرساخت مدیریتی جدیدی بسازید یا با ناهماهنگیها کنار بیایید. اما اگر از HGX استفاده کنید، میتوانید از یک OEM بخواهید که برایتان سروری بسازد که دقیقاً با معماری موجود شما سازگار باشد: پردازنده AMD EPYC نسل چهارم، حافظه DDR5 با ظرفیت دلخواه، ذخیرهساز NVMe که با سیستم مدیریت ذخیرهساز فعلی شما یکپارچه است، و کارت شبکه که با سوئیچهای موجود شما کار میکند.
یکی دیگر از تفاوتهای مهم در نرمافزار و پشتیبانی است. DGX با سیستمعامل اختصاصی DGX OS عرضه میشود که یک توزیع Ubuntu سفارشیسازیشده است که NVIDIA برای آن بهینهسازیهای خاصی انجام داده. همچنین شامل NVIDIA Base Command که یک ابزار مدیریت کلاستر است، و دسترسی به NVIDIA NGC که یک رجیستری از کانتینرهای بهینهشده برای کارهای AI و HPC است. این ابزارها بهطور یکپارچه با هم کار میکنند و تجربه کاربری روانی ارائه میدهند. در مقابل، سیستمهای مبتنی بر HGX معمولاً با سیستمعاملهای استاندارد مانند Ubuntu Server، Red Hat Enterprise Linux یا SUSE Linux عرضه میشوند، و شما باید خودتان driver های CUDA، کتابخانههای cuDNN، و فریمورکهای یادگیری ماشین را نصب و پیکربندی کنید. این کار البته نیاز به دانش فنی بیشتری دارد، اما در عوض کنترل کاملتری به شما میدهد.
از لحاظ قیمت، تفاوت قابلتوجهی وجود دارد. یک سیستم DGX H100 کامل با هشت GPU حدود 500,000 دلار قیمت دارد. این شامل سختافزار، نرمافزار، گارانتی سه ساله و پشتیبانی فنی NVIDIA است. در مقابل، اگر یک HGX H100 baseboard بخرید (که قیمت آن بین 200,000 تا 250,000 دلار است) و بقیه اجزا را خودتان تهیه کنید، ممکن است بتوانید یک سیستم کامل با 350,000 تا 400,000 دلار بسازید. این پسانداز 100,000 دلاری برای بسیاری از سازمانها قابلتوجه است، بهویژه اگر بخواهند چندین سیستم خریداری کنند.
با این حال، باید توجه داشت که قیمت پایینتر HGX با هزینههای دیگری همراه است. شما باید زمان مهندسی برای یکپارچهسازی سیستم، تست، رفع اشکال، و پیکربندی نرمافزار صرف کنید. همچنین پشتیبانی فنی شما از چند منبع مختلف خواهد بود: OEM برای شاسی و اجزای غیر-NVIDIA، NVIDIA برای GPU ها و driver ها، و احتمالاً شرکتهای دیگر برای شبکه و ذخیرهساز. این پیچیدگی مدیریتی میتواند چالشبرانگیز باشد.
در سوان تک، ما هم سیستمهای DGX و هم راهحلهای مبتنی بر HGX را ارائه میدهیم و بر اساس نیاز هر مشتری، بهترین انتخاب را توصیه میکنیم. برای شرکتهایی که سرعت راهاندازی مهم است و بودجه کافی دارند، DGX انتخاب ایدهآل است. برای سازمانهایی که نیازهای خاصی دارند، میخواهند در معماری موجود خود سرمایهگذاری کنند، یا به دنبال بهینهسازی هزینه هستند، راهحلهای مبتنی بر HGX منطقیتر است.
راهنمای یکپارچهسازی: از Baseboard تا سیستم کامل
ساخت یک سرور AI سفارشی با استفاده از HGX H100 baseboard یک پروژه مهندسی پیچیده است که نیاز به برنامهریزی دقیق و توجه به جزئیات دارد. در این بخش، مراحل اصلی این فرآیند را بهطور کامل بررسی میکنیم.
مرحله ۱: طراحی معماری سیستم
قبل از اینکه حتی یک قطعه سختافزار سفارش دهید، باید معماری کلی سیستم خود را طراحی کنید. این شامل تصمیمگیری درباره موارد زیر است:
انتخاب پردازنده CPU: سرور HGX H100 با پردازندههای x86 سازگار است، بنابراین میتوانید بین AMD EPYC و Intel Xeon انتخاب کنید. برای کارهای AI، AMD EPYC نسل چهارم (Genoa) با 96 هسته و پشتیبانی از PCIe Gen5 و DDR5 انتخابی محبوب است، زیرا پهنای باند I/O بسیار بالایی دارد. برخی سازمانها Intel Xeon Scalable نسل چهارم (Sapphire Rapids) را ترجیح میدهند به دلیل ویژگیهای امنیتی خاص یا سازگاری بهتر با نرمافزارهای خاص.
ظرفیت حافظه: بسته به کاربرد شما، ممکن است به حافظه بسیار زیادی نیاز داشته باشید. برای کارهای preprocessing داده یا زمانی که میخواهید dataset های بزرگ را در RAM نگه دارید، پیکربندیهای 1 تا 2 ترابایت RAM معمول است. سرورهای AMD EPYC تا 12 کانال حافظه و سرورهای Xeon تا 8 کانال پشتیبانی میکنند.
ذخیرهسازی: برای آموزش مدلهای بزرگ، نیاز به ذخیرهسازی سریع دارید. معمولاً ترکیبی از NVMe SSD برای دادههای فعال و SAS/SATA SSD یا حتی هارد دیسکهای با ظرفیت بالا برای آرشیو استفاده میشود. برخی سیستمها تا 24 درایو NVMe پشتیبانی میکنند که با RAID میتوانند پهنای باند چندین گیگابایت بر ثانیه ارائه دهند.
شبکه: این یکی از مهمترین تصمیمات است. برای کلاسترهای چند-سروری، نیاز به شبکهای با پهنای باند بالا و تأخیر کم دارید. دو گزینه اصلی InfiniBand (که بهطور سنتی در HPC استفاده میشود) و Ethernet با سرعت بالا (مانند 200Gb/s یا 400Gb/s) است. NVIDIA همچنین پلتفرم ConnectX-7 را ارائه میدهد که هم InfiniBand و هم Ethernet را پشتیبانی میکند.
سیستم خنککاری: HGX H100 8-GPU حدود 5.6 کیلووات حرارت تولید میکند. باید تصمیم بگیرید که از خنککاری هوایی استفاده کنید یا مایع. خنککاری هوایی سادهتر و ارزانتر است اما به فضای بیشتری نیاز دارد و صدای بیشتری تولید میکند. خنککاری مایع (خصوصاً direct-to-chip) میتواند تراکم بالاتری داشته باشد و در مراکز داده با محدودیت فضا ایدهآل است.
مرحله ۲: انتخاب شاسی و رک
شاسی باید بهگونهای طراحی شود که HGX baseboard را بهطور ایمن نگه دارد و دسترسی به کانکتورها و پورتها را فراهم کند. معمولاً شاسی های 8U یا 10U برای سیستمهای HGX 8-GPU استفاده میشود. شاسی باید دارای مواردی مانند:
- نصب ایمن baseboard: با مکانیزمهای قفل که جلوی حرکت در اثر لرزش را بگیرد
- مسیرهای جریان هوا: برای خنککاری هوایی، طراحی مسیر هوا از جلو به عقب یا پایین به بالا
- دسترسی به کابلها: برای اتصال برق، شبکه، و ارتباطات دیگر
- سینیهای قابل کشیدن: برای نگهداری تعمیر و تعویض قطعات
شاسی همچنین باید با استاندارد رک مرکز داده شما (معمولاً 19 اینچ) سازگار باشد. برخی سازندگان شاسی هایی طراحی کردهاند که مستقیماً برای HGX بهینه شدهاند و میتوان آنها را از شرکتهایی مانند سوان تک خریداری کرد.
مرحله ۳: یکپارچهسازی برق و مدیریت توان
تأمین برق پایدار و کافی یکی از چالشهای اصلی است. یک سیستم HGX H100 8-GPU همراه با پردازنده، حافظه و دیگر اجزا میتواند تا 10 کیلووات برق مصرف کند. شما به موارد زیر نیاز دارید:
منابع تغذیه قدرتمند: معمولاً 4 تا 6 واحد PSU با توان 2000-3000 وات در پیکربندی redundant (برای اطمینان از عدم قطع برق در صورت خرابی یک PSU)
توزیع برق: کابلکشی صحیح از PSU ها به HGX baseboard و سایر اجزا. HGX از کانکتورهای استاندارد استفاده میکند اما باید مطمئن شوید کابلها ظرفیت جریان کافی دارند.
مدیریت توان: BMC سیستم باید بتواند مصرف برق را مانیتور کند، سیاستهای power capping را اعمال کند و در صورت مشکل هشدار دهد.
مرحله ۴: اتصال به شبکه و ذخیرهساز
HGX baseboard از طریق PCIe Gen5 با سیستم میزبان ارتباط برقرار میکند. شما باید کارتهای شبکه (NIC) را در اسلاتهای PCIe نصب کنید. برای کلاسترهای بزرگ، معمولاً از دو NIC استفاده میشود: یکی برای ترافیک مدیریتی و دیگری برای ترافیک داده با پهنای باند بالا.
ذخیرهساز را نیز باید بهطور مشابه اتصال دهید. کنترلکنندههای NVMe معمولاً مستقیماً به PCIe متصل میشوند. برای سیستمهای بزرگ، ممکن است از یک سابسیستم ذخیرهسازی خارجی (مانند NetApp یا Pure Storage) استفاده کنید که از طریق شبکه به سرور متصل است.
مرحله ۵: نصب نرمافزار و پیکربندی
پس از اینکه سختافزار آماده شد، نوبت به نصب نرمافزار میرسد:
سیستمعامل: نصب یک توزیع Linux پایدار مانند Ubuntu 22.04 LTS، Red Hat Enterprise Linux 9، یا SUSE Linux Enterprise Server 15
NVIDIA drivers: نصب driver های CUDA و NVIDIA Data Center GPU Driver. این driver ها باید با نسخه کرنل لینوکس شما سازگار باشند.
کتابخانههای محاسباتی: نصب CUDA Toolkit، cuDNN، cuBLAS، NCCL (برای ارتباطات چند-GPU)، و TensorRT (برای استنتاج بهینه)
فریمورکهای AI: نصب PyTorch، TensorFlow، JAX، یا هر فریمورک دیگری که استفاده میکنید
ابزارهای مدیریت: نصب ابزارهایی برای مانیتورینگ (مانند Prometheus و Grafana)، مدیریت کلاستر (مانند Kubernetes یا Slurm)، و logging
مرحله ۶: تست و اعتبارسنجی
قبل از اینکه سیستم را به محیط تولید منتقل کنید، باید آن را بهطور کامل تست کنید:
تست استرس: اجرای workload های سنگین برای اطمینان از اینکه سیستم خنککاری میتواند گرما را مدیریت کند و برق کافی است
بنچمارک عملکرد: اجرای بنچمارکهای استاندارد مانند NVIDIA’s NCCL tests، HPL-AI برای HPC، و MLPerf برای workload های AI
تست پایداری: اجرای کارها برای چندین ساعت یا روز بدون اینکه سیستم کرش کند یا throttling رخ دهد
تست failover: اگر سیستم شما قابلیتهای redundancy دارد (مانند PSU های اضافی یا NIC های دوگانه)، تست کنید که در صورت خرابی یک جزء، سیستم همچنان کار میکند
این فرآیند ممکن است چندین هفته زمان ببرد، بهویژه اگر برای اولین بار است. در سوان تک، ما خدمات مشاوره و یکپارچهسازی ارائه میدهیم که میتواند این فرآیند را تسریع کند و از اشتباهات پرهزینه جلوگیری کند.
مشخصات فنی و پیکربندیهای ممکن
جدول مشخصات HGX H100 8-GPU
| مشخصه | HGX H100 8-GPU |
|---|---|
| GPU | 8× NVIDIA H100 SXM5 80GB |
| حافظه GPU کل | 640 GB HBM3 |
| پهنای باند حافظه هر GPU | 3.35 TB/s |
| پهنای باند حافظه کل | 26.8 TB/s |
| interconnect GPU-GPU | NVLink 4.0: 900 GB/s per GPU |
| توپولوژی | Fully-connected via 4× NVSwitch Gen3 |
| Tensor Cores | 528 per GPU, 4,224 total |
| CUDA Cores | 16,896 per GPU, 135,168 total |
| قدرت محاسباتی FP8 | 3,958 TFLOPS per GPU, 31.7 PFLOPS total |
| قدرت محاسباتی FP16 | 1,979 TFLOPS per GPU, 15.8 PFLOPS total |
| TDP کل | 5,600W (700W per GPU) |
| رابط به CPU | PCIe Gen5 x16 |
| پشتیبانی MIG | تا 56 instance در 8 GPU |
| ابعاد baseboard | مطابق استاندارد OCP |
| خنککاری | Air-cooled یا Liquid-cooled |
| وزن تقریبی | 15-20 کیلوگرم (baseboard + GPU ها) |
پیکربندیهای سیستم کامل نمونه
پیکربندی A: سرور All-Purpose
- HGX H100 8-GPU baseboard
- 2× AMD EPYC 9554 (64-core)
- 2TB DDR5-4800 ECC RAM
- 8× 3.84TB NVMe SSD (RAID 0 برای سرعت)
- 2× 200Gb/s InfiniBand NDR
- خنککاری هوایی
- 8U شاسی
- کاربرد: آموزش مدلهای متوسط، استنتاج چند-مدل، HPC
پیکربندی B: سرور Training-Optimized
- HGX H100 8-GPU baseboard
- 2× Intel Xeon Platinum 8480+ (56-core)
- 1.5TB DDR5-5600 ECC RAM
- 16× 7.68TB NVMe SSD (برای dataset های بزرگ)
- 4× 400Gb/s Ethernet (RDMA-capable)
- خنککاری مایع مستقیم
- 10U شاسی
- کاربرد: آموزش مدلهای frontier (100B+ parameters)
پیکربندی C: سرور Inference-Focused
- HGX H100 4-GPU baseboard
- 1× AMD EPYC 9374F (32-core)
- 512GB DDR5-4800 RAM
- 4× 1.92TB NVMe SSD
- 2× 100Gb/s Ethernet
- خنککاری هوایی
- 5U شاسی
- کاربرد: استنتاج real-time با throughput بالا
تحلیل هزینه و بودجهبندی
هزینه خرید اجزا
بیایید هزینه ساخت یک سرور مبتنی بر HGX H100 را برآورد کنیم (قیمتها به دلار آمریکا و تقریبی هستند):
| جزء | قیمت تقریبی |
|---|---|
| HGX H100 8-GPU Baseboard | $215,000 – $250,000 |
| 2× AMD EPYC 9554 | $22,000 |
| 2TB DDR5 RAM (32× 64GB) | $8,000 |
| 8× 3.84TB NVMe SSD | $4,000 |
| 2× 200Gb InfiniBand NIC | $6,000 |
| شاسی+ PSU (10kW) | $15,000 |
| سیستم خنککاری (مایع) | $10,000 |
| کابلها، قطعات جانبی | $3,000 |
| هزینه مهندسی & یکپارچهسازی | $15,000 – $30,000 |
| جمع کل | $298,000 – $348,000 |
در مقایسه، یک سیستم DGX H100 آماده حدود $500,000 قیمت دارد. بنابراین با ساخت سفارشی میتوانید $150,000 تا $200,000 پسانداز کنید.
هزینههای عملیاتی سالانه
علاوه بر هزینه خرید اولیه، باید هزینههای نگهداری را نیز در نظر بگیرید:
- برق: 10kW × 24 ساعت × 365 روز × $0.12/kWh = $10,512 در سال
- خنککاری: حدود 50% برق = $5,256 در سال
- فضای رک: $500-1,000 در ماه = $6,000-12,000 در سال
- پشتیبانی فنی: $20,000-40,000 در سال (بسته به SLA)
- تعمیر و تعویض قطعات: 5-10% قیمت خرید = $15,000-35,000 در سال
جمع TCO سالانه: $56,000 – $103,000
بنابراین در 3 سال، TCO کامل (خرید + عملیات) بین $466,000 تا $657,000 خواهد بود.
چالشها و راهحلها
چالش ۱: مدیریت حرارت
HGX H100 8-GPU یک منبع حرارت عظیم است. در تراکمهای بالا، ممکن است hot spots ایجاد شود.
راهحل:
- استفاده از خنککاری مایع مستقیم برای GPU ها
- طراحی دقیق مسیرهای جریان هوا در رک
- استفاده از containment (محفظههای hot aisle/cold aisle)
- نصب سنسورهای دمای متعدد برای مانیتورینگ
چالش ۲: پیچیدگی نرمافزار
بر خلاف DGX که نرمافزار pre-configured دارد، در HGX باید همه چیز را خودتان راهاندازی کنید.
راهحل:
- استفاده از کانتینرهای NVIDIA NGC که از قبل بهینه شدهاند
- ایجاد اسکریپتهای automation برای نصب و پیکربندی
- استفاده از ابزارهای configuration management مانند Ansible
- مستندسازی دقیق تمام مراحل برای تکرار
چالش ۳: پشتیبانی چندمنبعی
وقتی مشکلی پیش میآید، باید بفهمید مشکل از کجاست: GPU؟ CPU؟ حافظه؟ شبکه؟
راهحل:
- داشتن قرارداد پشتیبانی با تمام vendor ها
- ایجاد تیم فنی داخلی با دانش عمیق سیستم
- استفاده از ابزارهای diagnostic مانند NVIDIA DCGM
- نگهداری لاگهای جامع برای troubleshooting
سوالات متداول (FAQ)
۱. آیا میتوانم HGX H100 را مستقیماً از NVIDIA خریداری کنم؟
خیر، HGX یک محصول OEM است و NVIDIA آن را فقط به سازندگان سرور میفروشد. شما باید از طریق یک OEM مانند Dell، HPE، Supermicro یا نمایندههای مجاز مانند سوان تک خریداری کنید.
۲. چه تفاوتی بین HGX H100 4-GPU و 8-GPU وجود دارد؟
تفاوت اصلی در تعداد GPU ها و topology ارتباطی است. نسخه 4-GPU از 1 NVSwitch استفاده میکند و برای workload هایی که به کمتر از 5 GPU نیاز دارند مناسب است. نسخه 8-GPU با 4 NVSwitch یک فابریک fully-connected ایجاد میکند که برای مدلهای بزرگتر ضروری است.
۳. آیا میتوانم سرور HGX H100 را در یک سرور موجود نصب کنم؟
بعید است. HGX نیاز به شاسی، برق، خنککاری و اتصالات خاصی دارد. بهتر است یک سیستم جدید طراحی شده برای HGX بسازید.
۴. چه مدت زمان برای ساخت یک سرور سفارشی HGX لازم است؟
از زمان سفارش تا تحویل نهایی، معمولاً 8 تا 16 هفته طول میکشد. این شامل زمان تحویل baseboard (4-8 هفته)، خرید و مونتاژ سایر اجزا (2-4 هفته)، و یکپارچهسازی و تست (2-4 هفته) است.
۵. آیا سرور HGX با GPU های نسل قبل سازگار است؟
خیر، HGX H100 مخصوص GPU های H100 است. اگر میخواهید از A100 استفاده کنید، به HGX A100 baseboard نیاز دارید.
۶. چه تضمینی برای سرور HGX H100 ارائه میشود؟
NVIDIA معمولاً 3 سال گارانتی برای baseboard ارائه میدهد، اما سایر اجزا تحت گارانتی سازندگان خودشان هستند. شما میتوانید extended warranty بخرید.
۷. آیا میتوانم HGX را برای cryptocurrency mining استفاده کنم؟
از لحاظ فنی ممکن است، اما این استفاده بهینه از سرمایهگذاری نیست. H100 برای AI و HPC طراحی شده، نه mining. همچنین NVIDIA ممکن است قیمت را برای کاربردهای mining بالاتر بگیرد.
۸. آیا HGX از virtualization پشتیبانی میکند؟
بله، H100 از NVIDIA vGPU و MIG (Multi-Instance GPU) پشتیبانی میکند. میتوانید هر GPU را به تا 7 instance مجازی تقسیم کنید.
۹. چه مهارتهایی برای مدیریت سیستم HGX لازم است؟
تیم شما به دانش در زمینههای زیر نیاز دارد:
- مدیریت سرور لینوکس
- شبکههای datacenter (InfiniBand/Ethernet)
- مدیریت storage
- CUDA programming و GPU optimization
- Containerization (Docker, Kubernetes)
۱۰. آیا میتوانم چندین HGX را در یک کلاستر متصل کنم؟
بله، این یکی از کاربردهای اصلی HGX است. با استفاده از InfiniBand یا Ethernet با سرعت بالا، میتوانید صدها یا هزاران GPU را به هم متصل کنید. برای مثال، بسیاری از supercomputer های top500 از HGX استفاده میکنند.
نتیجهگیری و گام بعدی
سرور HGX Platform یک راهحل قدرتمند و انعطافپذیر برای سازمانهایی است که میخواهند زیرساخت AI سفارشی بسازند. با امکان انتخاب اجزا، بهینهسازی هزینه، و یکپارچگی با معماری موجود، HGX میتواند بهترین گزینه برای بسیاری از شرکتها باشد. البته این مسیر نیاز به تخصص فنی، برنامهریزی دقیق و سرمایهگذاری زمانی دارد، اما در ازای آن کنترل کامل و بهینهسازی دقیق با نیازهای شما را دریافت میکنید.
اگر تصمیم دارید یک سرور مبتنی بر HGX بسازید یا میخواهید بدانید که آیا این راهحل برای سازمان شما مناسب است، تیم مشاوره سوان تک آماده است تا شما را در تمام مراحل همراهی کند. از تحلیل نیاز گرفته تا طراحی معماری، خرید اجزا، یکپارچهسازی، تست و پشتیبانی ongoing، ما تجربه کامل ساخت و مدیریت سیستمهای AI را داریم.
همین حالا اقدام کنید: خرید HGX H100 8-GPU با سوان تک
آیا آماده هستید که قدم بعدی در ساخت زیرساخت AI سازمان خود را بردارید؟ سوان تک بهعنوان نماینده معتبر راهحلهای NVIDIA در ایران، میتواند شما را در این مسیر یاری کند:
خدمات ما شامل:
- مشاوره تخصصی رایگان: تحلیل نیازهای شما و توصیه بهترین راهحل (DGX vs HGX)
- طراحی معماری سفارشی: طراحی سیستمی که دقیقاً با نیازهای شما همخوانی دارد
- تأمین اجزا: دسترسی به HGX baseboard و تمام اجزای مورد نیاز با بهترین قیمت
- یکپارچهسازی و تست: مونتاژ حرفهای و تست کامل قبل از تحویل
- پشتیبانی 24/7: تیم فنی همیشه آماده برای رفع مشکلات
- آموزش: آموزش تیم شما برای مدیریت بهینه سیستم
- گارانتی معتبر: تضمین کیفیت و عملکرد
«انعطافپذیری HGX به ما اجازه داد تا برخلاف سیستمهای بسته، از پردازندههای AMD EPYC برای دستیابی به پهنای باند PCIe Gen5 بالاتر استفاده کنیم که گلوگاههای ورودی/خروجی را در آموزش مدلهای سنگین حذف کرد.» — مدیر ارشد معماری سیستم
«چالش اصلی در پیادهسازی HGX، مدیریت حرارتی است. با توان مصرفی که در پیک بار به ۱۰ کیلووات میرسد، طراحی دقیق جریان هوا یا استفاده از کولینگ مایع دیگر یک آپشن نیست، بلکه یک الزام حیاتی است.» — تیم مهندسی تأسیسات دیتاسنتر
«برای سازمانهایی که مقیاسپذیری اولویت اول است، توپولوژی تماممتصل (Fully-connected) که توسط NVSwitch در این پلتفرم ارائه میشود، تأخیر ارتباط بین GPUها را به حداقل میرساند و عملکردی مشابه یک ابر-GPU یکپارچه ایجاد میکند.» — سرپرست تیم پردازشهای سریع (HPC)
مقالات مرتبط
راهنماهای فنی مرتبط
- dgx h100 vs b200
- ai bridge ts2 08
- nvidias hopper h200 gpus
- amd epyc vs intel xeon
- rendering graphic card
- nvidia a100 vs l40s
- a100 40gb vs 80gb
- l40s best gpu for ai inference
- nvidia a100 40gb vs 80gb
- supermicro vs nvidia dgx comparison 2026
- nvidia dgx hgx guide
- soika ai workstation guide
- server buying guide
- dgx superpod enterprise scalability
- nvidia dgx b200 blackwell architecture
- dgx h200 vs dgx h100
- storage ai hpc guide
- nfiniband vs rocev2
- nvidia gpu datacenter buying guide
- huawei oceanstor dorado 6000 review
- about us
- gpu server consultation tool
- track order
- shipping
- promotions
- privacy policy
- faqs
- compare
- nvidia t4 tensor core
- nvidia a100 40gb gpu card