
مقالات و اخبار تکنولوژی
مقایسه DGX H100 و B200


DGX H100 و DGX B200 هر دو از قدرتمندترین پلتفرمهای هوش مصنوعی انویدیا هستند، اما برای یک نوع نیاز طراحی نشدهاند. DGX H100 بر پایهی معماری Hopper ساخته شده و همچنان یکی از پرکاربردترین گزینهها برای آموزش و استقرار مدلهای هوش مصنوعی در سازمانهاست. در مقابل، DGX B200 با معماری Blackwell، حافظهی بیشتر، توان پردازشی بالاتر و ارتباط سریعتر بین GPUها، برای اجرای مدلهای بسیار بزرگ و نسل جدید بارهای کاری هوش مصنوعی توسعه یافته است.
در این مقاله، تفاوت این دو سرور را از نظر معماری، پردازندههای گرافیکی، حافظه، پهنایباند، توان پردازشی، مصرف انرژی و هزینه بررسی میکنیم و مشخص میکنیم هر کدام برای چه سازمانها و پروژههایی انتخاب مناسبتری هستند.
جدول مقایسهی مشخصات فنی DGX H100 و DGX B200
تمام مقادیر زیر مربوط به کل سیستم DGX با ۸ پردازندهی گرافیکی است، مگر جایی که خلاف آن ذکر شده باشد.
| مشخصه | NVIDIA DGX H100 | NVIDIA DGX B200 | تفاوت |
|---|---|---|---|
| معماری | Hopper (تکتراشه) | Blackwell (دوتراشهای/چیپلتی) | نسل جدید Blackwell |
| پردازندهی گرافیکی | ۸ × H100 SXM5 | ۸ × B200 SXM6 | نسل جدید GPU |
| تعداد ترانزیستور هر GPU | حدود ۸۰ میلیارد | حدود ۲۰۸ میلیارد | حدود ۲.۶ برابر بیشتر</cite) |
| حافظهی کل GPU | ۶۴۰ گیگابایت HBM3 | ۱٬۴۴۰ گیگابایت HBM3e | حدود ۱۲۵٪ بیشتر</cite) |
| حافظهی هر GPU | ۸۰ گیگابایت | ۱۸۰ گیگابایت | حدود ۱۲۵٪ بیشتر |
| پهنایباند حافظهی هر GPU | حدود ۳.۳۵ ترابایت بر ثانیه | حدود ۸ ترابایت بر ثانیه | حدود ۱۴۰٪ بیشتر</cite) |
| پهنایباند حافظهی کل سیستم | حدود ۲۶.۸ ترابایت بر ثانیه | حدود ۶۴ ترابایت بر ثانیه | حدود ۱۴۰٪ بیشتر |
| عملکرد آموزش مدل (FP8) | ۳۲ پتافلاپس | ۷۲ پتافلاپس | حدود ۱۲۵٪ بیشتر</cite) |
| عملکرد استنتاج (FP4) | پشتیبانی نمیشود | ۱۴۴ پتافلاپس | قابلیت اختصاصی Blackwell</cite) |
| NVLink | نسل چهارم، ۹۰۰ گیگابایت بر ثانیه برای هر GPU | نسل پنجم، مجموع ۱۴.۴ ترابایت بر ثانیه | پهنایباند بسیار بالاتر |
| پردازندهی مرکزی | ۲ × Intel Xeon Platinum 8480C (۱۱۲ هسته) | ۲ × Intel Xeon Platinum 8570 (۱۱۲ هسته) | نسل جدید پردازنده |
| حافظهی سیستم | ۲ ترابایت DDR5 | تا ۴ ترابایت DDR5 | تا ۱۰۰٪ بیشتر |
| توان مصرفی | حدود ۱۰.۲ تا ۱۱.۳ کیلووات | حدود ۱۴.۳ کیلووات | حدود ۳۰٪ بیشتر |
| شبکه | ConnectX-7 تا ۴۰۰Gb/s | ConnectX-7 تا ۴۰۰Gb/s | بدون تغییر |
| قیمت تقریبی هر سرور کامل (۸ GPU) | معمولاً کمتر از B200 | حدود ۵۱۵ هزار دلار | تفاوت قیمت قابلتوجه</cite) |
محصولات مرتبط
محصولات پیشنهادی
-

سرور NVIDIA DGX H100
91,962,500,000 تومان -
سرور NVIDIA HGX B200: قدرتمندترین زیرساخت هوش مصنوعی با معماری Blackwell
69,300,000,000 تومان
تفاوت معماری؛ Hopper در برابر Blackwell
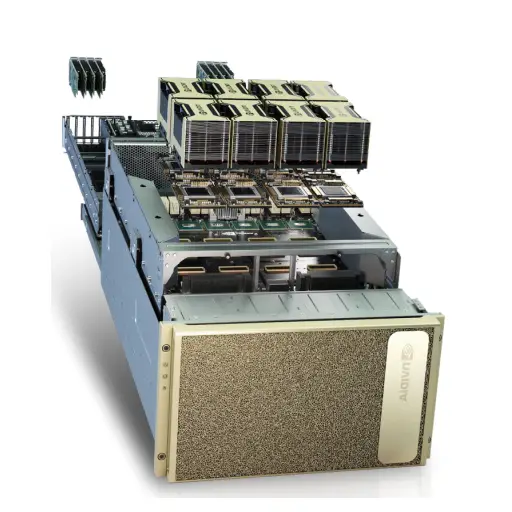
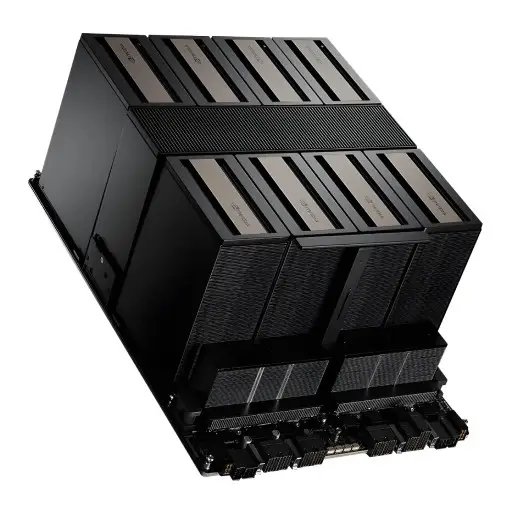
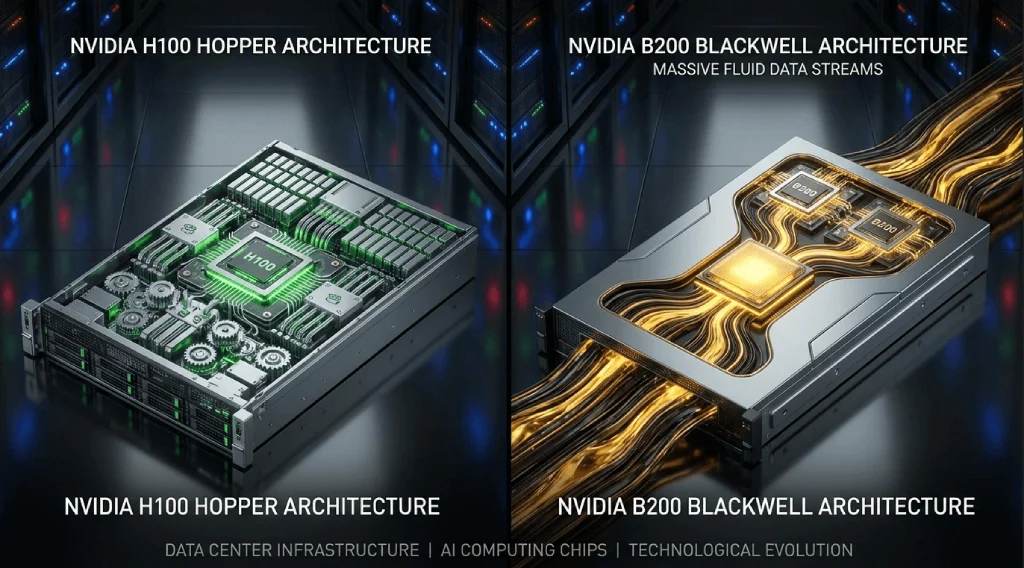
مهمترین تفاوت DGX H100 و DGX B200 به معماری پردازندههای گرافیکی آنها برمیگردد. بسیاری از اختلافهایی که در عملکرد، ظرفیت حافظه و توان پردازشی این دو سیستم دیده میشود، نتیجهی همین تفاوت در طراحی تراشه است.
GPUهای H100 بر پایهی معماری Hopper ساخته شدهاند. در این نسل، هر پردازندهی گرافیکی از یک تراشهی سیلیکونی یکپارچه (Monolithic) تشکیل شده است؛ یعنی تمام بخشهای پردازشی روی یک قطعه سیلیکون قرار دارند. این طراحی باعث میشود ارتباط بین اجزای داخلی تراشه با کمترین تأخیر انجام شود و H100 همچنان برای بسیاری از بارهای کاری آموزش مدلهای هوش مصنوعی عملکرد بسیار پایداری داشته باشد.
در مقابل، انویدیا در معماری Blackwell از طراحی چیپلتی (Chiplet) استفاده کرده است؛ دلیل این تغییر، محدودیت ابعاد تراشه در فرایندهای ساخت نیمههادی است. بهجای ساخت یک تراشهی بسیار بزرگ، B200 از دو قطعهی سیلیکونی تشکیل شده که از طریق فناوری NV-HBI با پهنایباند حدود ۱۰ ترابایت بر ثانیه به یکدیگر متصل هستند.
با وجود این ساختار دوتراشهای، سیستمعامل و CUDA این دو بخش را بهصورت یک GPU واحد شناسایی میکنند؛ در نتیجه، نرمافزارها و مدلهای هوش مصنوعی بدون نیاز به تغییر کد میتوانند از توان پردازشی کامل B200 استفاده کنند.
تفاوت دیگر به تعداد ترانزیستورها مربوط میشود. H100 حدود ۸۰ میلیارد ترانزیستور دارد، در حالی که این عدد در B200 به حدود ۲۰۸ میلیارد رسیده است</cite). این افزایش فقط به معنای بزرگترشدن تراشه نیست؛ بخش قابلتوجهی از آن به افزایش حافظهی کش L2 و بهبود واحدهای پردازشی اختصاص یافته است. نتیجهی این تغییرات، عملکرد بهتر در اجرای مدلهای بزرگ زبانی (LLM)، بهویژه مدلهای Mixture of Experts (MoE)، و همچنین پردازش سریعتر حجم بالای دادههاست.
تفاوت حافظه و پهنایباند DGX H100 و DGX B200
در پردازش مدلهای بزرگ هوش مصنوعی، فقط قدرت محاسباتی GPU اهمیت ندارد؛ سرعت انتقال داده بین حافظه و پردازنده نیز نقش مهمی در عملکرد نهایی دارد. اگر پهنایباند حافظه کافی نباشد، بخشی از توان پردازشی GPU بدون استفاده باقی میماند.
DGX H100 با حافظهی HBM3 و پهنایباند حدود ۳.۳۵ ترابایت بر ثانیه برای هر GPU (و درمجموع حدود ۲۶.۸ ترابایت بر ثانیه برای کل سیستم ۸ کارته)، در زمان معرفی یکی از قدرتمندترین پلتفرمهای هوش مصنوعی بود</cite). اما با افزایش اندازهی مدلهای زبانی، نیاز به حافظهی سریعتر و ظرفیت بالاتر بیشتر شد.
DGX B200 با استفاده از حافظهی HBM3e، پهنایباند حدود ۸ ترابایت بر ثانیه برای هر GPU (درمجموع حدود ۶۴ ترابایت بر ثانیه برای کل سیستم) و مجموع ۱.۴۴ ترابایت حافظهی GPU، توانایی بالاتری در اجرای مدلهای بزرگ هوش مصنوعی دارد</cite). این تفاوت باعث میشود B200 در پردازش مدلهای بزرگ زبانی و پروژههای Generative AI عملکرد بهتری ارائه دهد؛ برای نمونه، حافظهی بزرگتر هر GPU بهتنهایی امکان اجرای مدلهای بسیار بزرگتر بدون نیاز به تقسیم آنها بین چند GPU را فراهم میکند.
مقایسهی اقتصادی؛ آیا DGX B200 ارزش هزینهی بیشتر را دارد؟
تفاوت بین DGX H100 و DGX B200 فقط در قیمت خرید خلاصه نمیشود. در بسیاری از پروژههای هوش مصنوعی، هزینهی واقعی به مصرف انرژی، سرعت پردازش و میزان خروجی قابلدریافت از هر GPU وابسته است.
از نظر قیمت اولیه، یک سرور کامل DGX B200 با ۸ پردازندهی گرافیکی حدود ۵۱۵ هزار دلار هزینه دارد</cite)، که نسبت به نسل قبلی H100 گرانتر است. با این حال، DGX B200 بهدلیل توان پردازشی بیشتر، حافظهی سریعتر و بهینهسازی بهتر برای مدلهای بزرگ هوش مصنوعی، میتواند در پروژههای سنگین و سرویسهای مبتنیبر استنتاج در مقیاس بالا، هزینهی عملیاتی کمتری بهازای هر پردازش ایجاد کند؛ چون یک کار مشخص که ممکن است روی H100 چند ساعت طول بکشد، میتواند روی B200 در زمان کوتاهتری انجام شود و درنهایت هزینهی کل هر پروژه را کاهش دهد.
چه زمانی DGX H100 انتخاب بهتری است؟
DGX H100 همچنان برای بسیاری از سازمانها گزینهای منطقی است؛ بهویژه اگر مدلهای شما در محدودهی ۸۰ گیگابایت حافظه (تا حدود ۳۴ میلیارد پارامتر با دقت استاندارد یا حدود ۷۰ میلیارد پارامتر با کوانتیزیشن) جا میشوند</cite). اگر هدف شما آموزش مدلهای متوسط، اجرای پروژههای تحقیقاتی، فاینتیون مدلهای موجود، یا استفاده در زیرساختهایی با محدودیت برق و خنکسازی است، H100 میتواند تعادل بهتری بین هزینه و عملکرد ارائه دهد.
همچنین بهدلیل حضور طولانیتر در بازار، اکوسیستم نرمافزاری، تجربهی استفاده و دسترسی به تجهیزات جانبی آن بالغتر و قیمت اجارهی ابری آن هم بهطور محسوسی نسبت به زمان معرفیاش کاهش یافته است.
چه زمانی DGX B200 انتخاب مناسبتری است؟
اگر قصد اجرای مدلهای بسیار بزرگ (بهویژه مدلهایی با صدها میلیارد یا تریلیونها پارامتر)، سرویسدهی هوش مصنوعی در مقیاس بالا، یا آمادهسازی زیرساخت برای سالهای آینده را دارید، DGX B200 انتخاب آیندهنگرانهتری محسوب میشود.
ظرفیت حافظهی بالاتر، معماری Blackwell، پشتیبانی از دقتهای محاسباتی فوقپایین مانند FP4، و پشتیبانی بهتر از نسل جدید مدلهای هوش مصنوعی باعث میشود این سیستم در پروژههایی که حجم پردازش بسیار بالایی دارند، بازده اقتصادی بهتری ایجاد کند؛ بهویژه در سرویسهای استنتاج (Inference) در مقیاس بزرگ که سرعت پاسخدهی مستقیماً روی درآمد عملیاتی اثر میگذارد.
جمعبندی
انتخاب بین DGX H100 و DGX B200 به این بستگی دارد که چه نوع کاری قرار است روی سیستم انجام شود. H100 همچنان یک پلتفرم قدرتمند و اثباتشده برای بسیاری از کاربردهای سازمانی است، در حالی که B200 برای پروژههایی طراحی شده که به بیشترین توان پردازشی، مقیاسپذیری و آمادگی برای نسل آیندهی هوش مصنوعی نیاز دارند.
بهترین انتخاب همیشه جدیدترین یا قدرتمندترین سختافزار نیست؛ بلکه سیستمی است که بیشترین تناسب را با حجم کاری، بودجه و زیرساخت سازمان شما داشته باشد.
در مقابل، NVIDIA در معماری Blackwell از طراحی چیپلتی (Chiplet) استفاده کرده است. دلیل این تغییر، محدودیت ابعاد تراشه در فرآیندهای ساخت نیمه هادی است. به جای ساخت یک تراشه بسیار بزرگ، B200 از دو قطعه سیلیکونی تشکیل شده که از طریق فناوری NV-HBI با پهنای باند حدود 10 ترابایت بر ثانیه به یکدیگر متصل هستند.
با وجود این ساختار دو تراشه ای، سیستم عامل و CUDA این دو بخش را به صورت یک GPU واحد شناسایی می کنند. در نتیجه، نرم افزارها و مدل های هوش مصنوعی بدون نیاز به تغییر کد می توانند از توان پردازشی کامل B200 استفاده کنند.
تفاوت دیگر به تعداد ترانزیستورها مربوط می شود. H100 حدود 80 میلیارد ترانزیستور دارد، در حالی که این عدد در B200 به حدود 208 میلیارد رسیده است. این افزایش فقط به معنای بزرگ تر شدن تراشه نیست؛ بخش قابل توجهی از آن به افزایش حافظه کش L2 و بهبود واحدهای پردازشی اختصاص یافته است. نتیجه این تغییرات، عملکرد بهتر در اجرای مدل های بزرگ زبانی (LLM)، به ویژه مدل های Mixture of Experts (MoE)، و همچنین پردازش سریع تر حجم بالای داده ها است.