
مقالات و اخبار تکنولوژی
راهنمای جامع سیستمهای NVIDIA DGX و HGX: انتخاب هوشمندانه برای زیرساخت هوش مصنوعی سازمانی


نویسنده: تیم زیرساخت سوان تک
بازبینی فنی: واحد مهندسی سختافزار HPC
آخرین بهروزرسانی: ۱۵ دی ۱۴۰۵
زمان مطالعه: ۲۵ دقیقه
منابع: مستندات فنی انویدیا (DGX Systems & HGX Platform)، بنچمارکهای MLPerf، دیتاشیتهای H100/H200/B200، گزارشهای TCO سازمانی.
خلاصه: DGX یا HGX؟ کدام مناسب شماست؟
اگر سازمان شما به سرعتِ راهاندازی (Time-to-Market) اولویت میدهد و بودجه کافی برای یک راهکار تضمینشده و یکپارچه دارد، NVIDIA DGX بهترین انتخاب است؛ زیرا تمام اجزا (سختافزار، نرمافزار، شبکه) از پیش بهینهسازی شده و آماده بهرهبرداری هستند. در مقابل، اگر تیم فنی ماهری برای اسمبل و یکپارچهسازی دارید و نیاز به انعطافپذیری در انتخاب پردازنده (CPU)، حافظه یا سیستم خنککننده (مثلاً مایع) برای کاهش هزینهها دارید، پلتفرم NVIDIA HGX به شما امکان ساخت سرورهای سفارشی (Custom Build) را میدهد.
نکات کلیدی تصمیمگیری سیستمهای DGX H100/H200 برای کلاسترهای بزرگ (مانند SuperPOD) و سازمانهایی که نیاز به پشتیبانی ۲۴/۷ مستقیم انویدیا دارند، ایدهآل هستند. در سوی دیگر، HGX برای دیتاسنترهایی که محدودیتهای فیزیکی خاص دارند یا میخواهند با استفاده از قطعات جانبی مقرونبهصرفهتر، هزینه نهایی (TCO) را ۱۰ تا ۱۵ درصد کاهش دهند، گزینه بهتری است. فراموش نکنید که زمان تحویل و راهاندازی HGX معمولاً ۳ تا ۵ هفته طولانیتر از DGX است.
مقدمه: آینده محاسبات هوش مصنوعی
در عصری که هوش مصنوعی از یک فناوری نوظهور به ستون اصلی کسبوکارها تبدیل شده است، انتخاب زیرساخت محاسباتی مناسب میتواند تفاوت بین موفقیت و شکست یک سازمان را رقم بزند. از بانکها و موسسات مالی گرفته تا شرکتهای دارویی، مراکز تحقیقاتی دانشگاهی و استارتاپهای فناوری، همگی به دنبال راهکاری هستند که بتواند نیازهای پیچیده محاسبات یادگیری ماشین، آموزش مدلهای زبانی بزرگ و پردازش حجم عظیم دادهها را برآورده کند.
راهنمای جامع سیستمهای NVIDIA DGX و HGX: انتخاب هوشمندانه
NVIDIA به عنوان پیشگام صنعت محاسبات موازی، دو خانواده محصول برجسته را برای این نیاز ارائه داده است: سیستمهای DGX که راهحلهای یکپارچه و آماده استفاده هستند، و پلتفرم HGX که قابلیت سفارشیسازی بالا برای سازندگان سرور را فراهم میکند. در این راهنمای جامع، به بررسی عمیق معماری، مشخصات فنی، کاربردها، مزایا و معایب هر یک از این سیستمها میپردازیم و به شما کمک میکنیم تا بهترین تصمیم را برای سرمایهگذاری در زیرساخت هوش مصنوعی سازمان خود بگیرید.
بخش اول: درک فلسفه طراحی – DGX در مقابل HGX

NVIDIA DGX: راهحل یکپارچه برای سرعت و قابلیت اطمینان
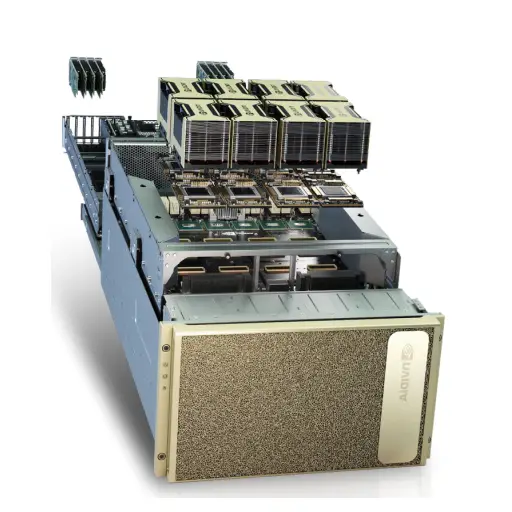
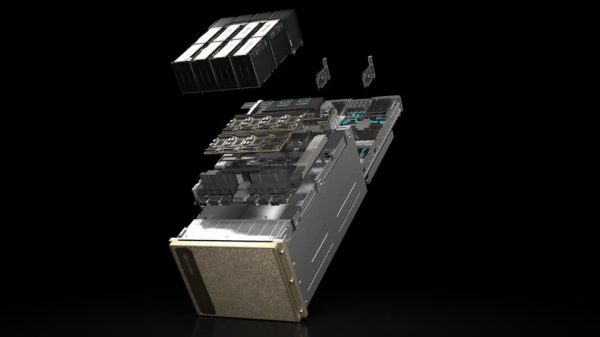
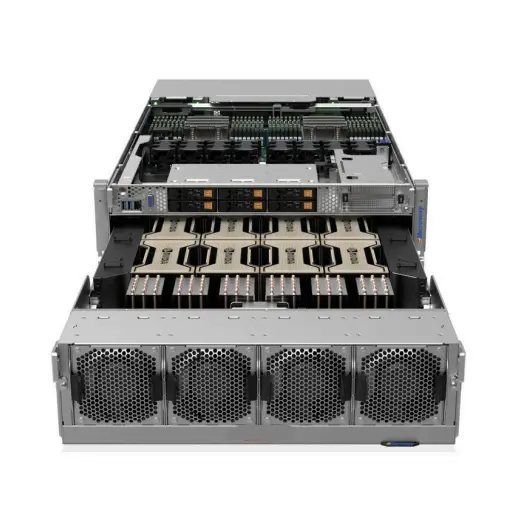
سیستمهای DGX به عنوان ابزارهای تخصصی هوش مصنوعی طراحی شدهاند که تمام پیچیدگیهای یکپارچهسازی سختافزار و نرمافزار را از دوش کاربران برمیدارند. این سیستمها مانند یک ابررایانه کامل عمل میکنند که از کارخانه با همه تنظیمات بهینهسازی شده بیرون میآیند. هر سیستم DGX شامل موارد زیر است:
اجزای سختافزاری:
- هشت پردازنده گرافیکی NVIDIA Tensor Core (H100، H200 یا B200 بسته به مدل)
- دو پردازنده مرکزی Intel Xeon Platinum یا AMD EPYC قدرتمند
- حافظه رم DDR5 با ظرفیت بالا (معمولاً 2 ترابایت)
- فضای ذخیرهسازی NVMe پرسرعت (تا 30 ترابایت)
- شبکههای یکپارچه InfiniBand یا Ethernet با سرعت بالا
- سیستم خنکسازی پیشرفته برای مدیریت حرارت
نرمافزار و پشتیبانی:
- سیستمعامل اختصاصی DGX OS مبتنی بر Ubuntu
- درایورهای CUDA و کتابخانههای بهینهسازی شده
- ابزارهای مدیریت کلاستر NVIDIA Base Command
- دسترسی به مخزن NGC با کانتینرهای آماده
- گارانتی سه ساله و پشتیبانی فنی 24/7 از NVIDIA
برای سازمانهایی که سرعت راهاندازی اولویت دارد، بودجه کافی در اختیار دارند و نمیخواهند وقت خود را صرف پیکربندی و عیبیابی کنند، DGX انتخابی ایدهآل است.
NVIDIA HGX: انعطافپذیری برای نیازهای منحصربهفرد
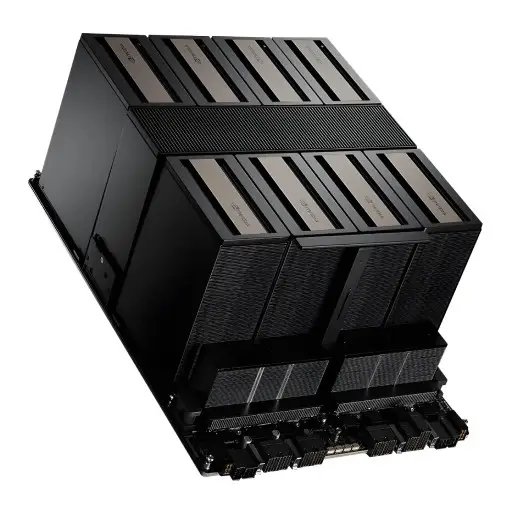
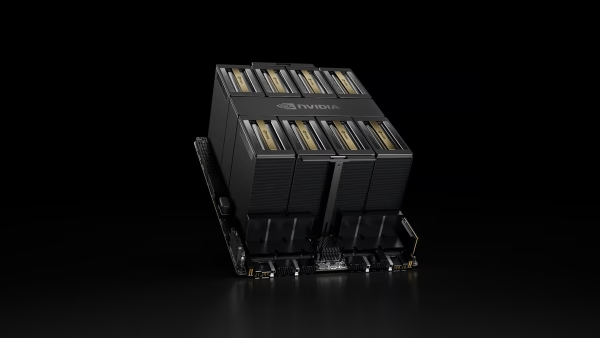
در مقابل، پلتفرم HGX یک baseboard مرجع است که شامل هشت GPU، سوئیچهای NVLink و زیرساخت ارتباطی میشود اما بدون سایر اجزای سیستم عرضه میشود. این پلتفرم به سازندگان سرور (OEM) امکان میدهد که سیستمهای سفارشی را بر اساس نیازهای خاص مشتریان بسازند.
مزایای رویکرد HGX:
- انتخاب آزاد پردازنده مرکزی (Intel یا AMD)
- پیکربندی دلخواه حافظه رم و ذخیرهسازی
- یکپارچهسازی با زیرساخت موجود دیتاسنتر
- انعطاف در انتخاب سیستم خنکسازی (هوایی یا مایع)
- امکان بهینهسازی هزینه با انتخاب اجزای مناسب
این رویکرد برای سازمانهایی مناسب است که:
- معماری سختافزاری خاصی دارند
- نیاز به تطابق با استانداردهای داخلی دارند
- میخواهند هزینهها را بهینه کنند
- تیم فنی ماهری برای یکپارچهسازی دارند

بخش دوم: تکامل نسلها – از H100 تا B200
NVIDIA DGX H100: قدرت معماری Hopper
DGX H100 نخستین سیستمی بود که معماری انقلابی Hopper را به دنیای واقعی آورد. این سیستم با بهرهگیری از پیشرفتهترین فناوریهای نیمههادی، توانست استانداردهای جدیدی در محاسبات هوش مصنوعی تعریف کند.
مشخصات کلیدی DGX H100:
| مشخصه | مقدار | جزئیات |
|---|---|---|
| تعداد GPU | 8 × NVIDIA H100 SXM5 | معماری Hopper با 80 میلیارد ترانزیستور |
| حافظه GPU | 640 گیگابایت (80GB × 8) | HBM3 با پهنای باند 3.35 TB/s هر GPU |
| قدرت محاسباتی | 32 پتافلاپس (FP8) | برای آموزش مدلهای بزرگ |
| پردازنده مرکزی | 2× Intel Xeon Platinum 8480+ | 112 هسته با فرکانس 2.0 گیگاهرتز |
| حافظه سیستم | 2 ترابایت DDR5-4800 | ECC RDIMM برای قابلیت اطمینان بالا |
| ذخیرهسازی | 30 ترابایت NVMe | 8 درایو Gen4 برای سرعت بالا |
| شبکه | 8× OSFP 400Gb/s | ConnectX-7 با پشتیبانی InfiniBand |
| توان مصرفی | 10.2 کیلووات | با 6 منبع تغذیه افزونهدار |
معماری Hopper در H100 با معرفی Transformer Engine و پشتیبانی از دقت FP8، سرعت آموزش مدلهای زبانی بزرگ را تا 6 برابر نسبت به نسل قبل افزایش داد. قابلیت Multi-Instance GPU نیز امکان تقسیم هر GPU به 7 نمونه مستقل را فراهم میکند که برای استفاده بهینه از منابع حیاتی است.
NVIDIA DGX H200: جهش در حافظه و پهنای باند
تنها یک سال پس از H100، NVIDIA با معرفی H200 نشان داد که چگونه میتوان بدون تغییر اساسی معماری، بهبودهای چشمگیری در عملکرد ایجاد کرد.
تفاوتهای کلیدی H200 با H100:
| ویژگی | DGX H100 | DGX H200 | بهبود |
|---|---|---|---|
| حافظه GPU کل | 640 گیگابایت | 1,128 گیگابایت | +76% |
| نوع حافظه | HBM3 | HBM3e | نسل پیشرفتهتر |
| پهنای باند حافظه | 26.8 TB/s | 38.4 TB/s | +43% |
| سرعت آموزش LLM | پایه | 1.18× سریعتر | +18% |
| سرعت استنتاج | پایه | تا 1.6× سریعتر | +60% |
| پردازش متن طولانی | پایه | تا 3.4× سریعتر | +240% |
افزایش 76 درصدی حافظه یعنی امکان آموزش مدلهای بزرگتر بدون نیاز به تکنیکهای پیچیده تقسیم مدل. برای مثال، یک مدل 405 میلیارد پارامتری مانند Llama 3.1 Ultra که قبلاً نیاز به تقسیم بین چندین نود داشت، اکنون میتواند در یک سیستم H200 جای بگیرد.
NVIDIA DGX B200: معماری Blackwell و انقلاب بعدی
با معرفی معماری Blackwell در سال 2024، NVIDIA بزرگترین جهش نسلی در تاریخ محاسبات هوش مصنوعی را رقم زد. DGX B200 نه یک ارتقا تدریجی، بلکه یک بازطراحی کامل است.
نوآوریهای معماری Blackwell:
- طراحی دو-Die با NVLink-C2C: هر GPU B200 در واقع دو تراشه است که با پهنای باند 10 ترابایت بر ثانیه به هم متصل شدهاند، اما از دیدگاه نرمافزاری یک GPU یکپارچه عمل میکنند.
- 208 میلیارد ترانزیستور: 2.5 برابر بیشتر از H100، که امکان پیچیدگی محاسباتی بیشتری را فراهم میکند.
- پشتیبانی اصلی از FP4: اولین معماری که به طور بومی از دقت 4 بیتی پشتیبانی میکند، که برای استنتاج بهینه حیاتی است.
- Transformer Engine نسل دوم: با قابلیت Micro-Tensor Scaling که امکان استفاده از دقتهای متغیر در داخل یک تنسور را میدهد.
جدول مقایسه سه نسل:
| مشخصه | DGX H100 | DGX H200 | DGX B200 | پیشرفت کلی |
|---|---|---|---|---|
| قدرت آموزش (FP8) | 32 پتافلاپس | 32 پتافلاپس | 72 پتافلاپس | +125% |
| قدرت استنتاج (FP4) | – | – | 144 پتافلاپس | جدید |
| حافظه کل | 640 GB | 1,128 GB | 1,440 GB | +125% |
| پهنای باند حافظه | 26.8 TB/s | 38.4 TB/s | 64 TB/s | +138% |
| NVLink | 900 GB/s | 900 GB/s | 1,800 GB/s | +100% |
| توان مصرفی | 10.2 کیلووات | 10.2 کیلووات | 14 کیلووات | +37% |
| بازده انرژی | 3.1 PFLOPS/kW | 3.1 PFLOPS/kW | 5.1 PFLOPS/kW | +65% |
همانطور که مشاهده میکنید، B200 با افزایش 37 درصدی توان مصرفی، قدرت محاسباتی را بیش از دو برابر کرده است که نشاندهنده بهبود چشمگیر در بازده انرژی است.
بخش سوم: پلتفرم HGX – قدرت انعطافپذیری
HGX H100: ساخت سرورهای سفارشی
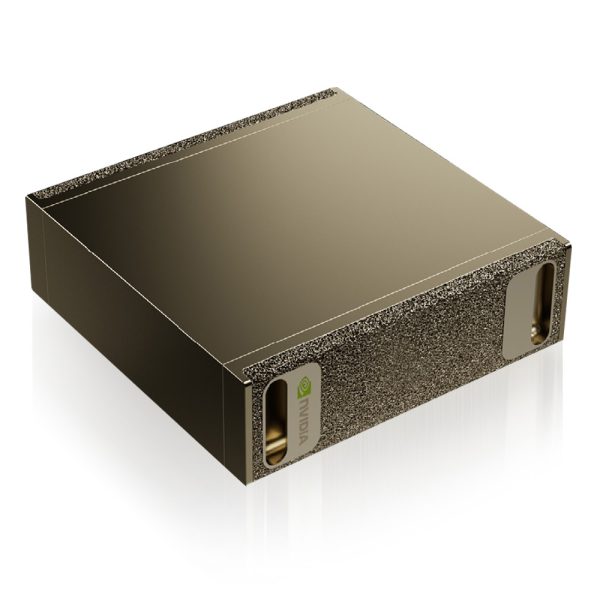
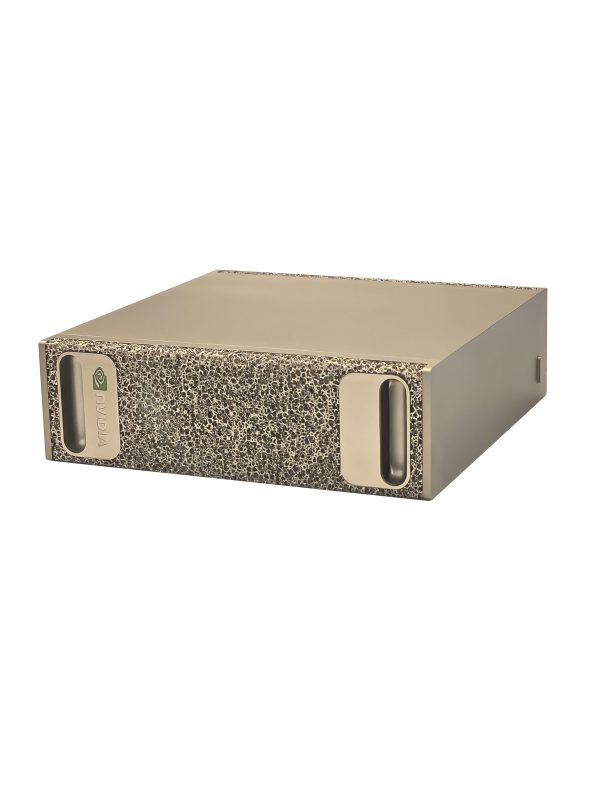
پلتفرم HGX H100 به سازندگان سرور این امکان را میدهد که سیستمهای AI سفارشی بسازند که دقیقاً با نیازهای مشتریان هماهنگ باشند. این baseboard شامل موارد زیر است:
اجزای اصلی HGX Baseboard:
- 8× GPU H100 SXM5 با 80 گیگابایت حافظه HBM3
- 4× NVSwitch نسل سوم برای ارتباط کامل GPU-to-GPU
- کنترلکنندههای مدیریت حرارت و توان
- رابطهای PCIe Gen5 برای اتصال به سیستم میزبان
- BMC برای مدیریت از راه دور
سناریوهای ساخت سرور با HGX:
پیکربندی A – سرور همهمنظوره:
- HGX H100 8-GPU
- 2× AMD EPYC 9554 (64 هسته)
- 2 ترابایت DDR5 RAM
- 8× NVMe SSD 3.84TB
- 2× InfiniBand NDR 200Gb/s
- خنکسازی هوایی
- قیمت تقریبی: 350,000 – 400,000 دلار
- کاربرد: آموزش مدلهای متوسط، استنتاج چندمدل، محاسبات علمی
پیکربندی B – سرور استنتاج پرتراکم:
- HGX H100 8-GPU
- 2× Intel Xeon Gold 6448Y (32 هسته)
- 1 ترابایت DDR5 RAM
- 4× NVMe SSD 1.92TB
- 4× Ethernet 100GbE
- خنکسازی مایع مستقیم
- قیمت تقریبی: 320,000 – 370,000 دلار
- کاربرد: سرویسدهی API های تجاری، استنتاج مقیاس بزرگ
پیکربندی C – سرور تحقیقاتی با ذخیرهسازی بالا:
- HGX H100 8-GPU
- 2× AMD EPYC 9654 (96 هسته)
- 3 ترابایت DDR5 RAM
- 16× NVMe SSD 7.68TB (122 ترابایت کل)
- 2× InfiniBand HDR 200Gb/s + 2× Ethernet 25GbE
- خنکسازی هوایی پیشرفته
- قیمت تقریبی: 420,000 – 480,000 دلار
- کاربرد: پروژههای تحقیقاتی با دیتاست بزرگ، ژنومیکس، تصویربرداری پزشکی
مراحل یکپارچهسازی HGX
برای سازمانهایی که تصمیم به ساخت سرور سفارشی دارند، فرآیند یکپارچهسازی شامل مراحل زیر است:
مرحله 1 – طراحی و برنامهریزی (2-4 هفته):
- تحلیل نیازهای کاری و تعیین مشخصات
- انتخاب اجزای سازگار (CPU، RAM، Storage، Network)
- طراحی معماری حرارتی و برقی
- محاسبه هزینهها و تایید بودجه
مرحله 2 – تهیه و آمادهسازی (6-10 هفته):
- سفارش HGX baseboard از NVIDIA یا توزیعکنندگان معتبر
- تهیه شاسی، منابع تغذیه و سیستم خنککننده
- خرید اجزای جانبی (CPU، RAM، SSD، NIC)
مرحله 3 – مونتاژ و آزمایش (2-3 هفته):
- نصب فیزیکی baseboard در شاسی
- اتصال برق، شبکه و کابلکشی
- نصب سیستمعامل و درایورها
- تست استرس و اعتبارسنجی عملکرد
مرحله 4 – استقرار و بهینهسازی (1-2 هفته):
- انتقال به محیط تولید
- پیکربندی نرمافزارهای مدیریت کلاستر
- آموزش تیم فنی
- اجرای workload های واقعی و تنظیم پارامترها
زمان کل: 11-19 هفته (در مقابل 12-16 هفته برای DGX که بیشتر وقت منتظر تحویل است)
بخش چهارم: DGX SuperPOD – مقیاسپذیری سازمانی
معماری Scalable Unit (SU)
برای سازمانهایی که به بیش از یک یا دو سیستم نیاز دارند، NVIDIA مفهوم DGX SuperPOD را معرفی کرده است. یک SuperPOD از واحدهای مقیاسپذیر (Scalable Unit یا SU) تشکیل شده که هر کدام شامل موارد زیر هستند:
ترکیب یک SU استاندارد مبتنی بر H100:
- 32× سیستم DGX H100 (256 GPU در مجموع)
- 8× سوئیچ Leaf InfiniBand NDR
- 4× سوئیچ Spine InfiniBand
- 1-2 پتابایت استوریج موازی (BeeGFS یا Lustre)
- 2-4 سرور مدیریت (Base Command Manager، UFM)
- زیرساخت شبکه مدیریت
مشخصات عملکردی یک SU:
| پارامتر | مقدار | توضیحات |
|---|---|---|
| قدرت محاسباتی کل | 8.2 اگزافلاپس (FP8) | برای آموزش مدلهای عظیم |
| حافظه GPU کل | 20.5 ترابایت | جایگذاری مدلهای تریلیون پارامتری |
| پهنای باند شبکه | 51.2 ترابایت/ثانیه | ارتباط GPU-to-GPU |
| پهنای باند استوریج | 2+ ترابایت/ثانیه | خواندن و نوشتن داده |
| مصرف برق | 450-500 کیلووات | شامل خنکسازی |
| فضای رک | 32-40 واحد | بسته به تراکم |
مسیر گسترش: از یک SU تا سوپرکامپیوتر
سطح 1 – یک SU (256 GPU):
- سرمایهگذاری: حدود 20 میلیون دلار
- زمان آموزش GPT-3 175B: 2-3 هفته
- تعداد پروژه همزمان: 10-15
- مناسب برای: شرکتهای متوسط، دانشگاههای بزرگ
سطح 2 – چهار SU (1,024 GPU):
- سرمایهگذاری: حدود 75 میلیون دلار
- زمان آموزش مدل 500B: 1-2 هفته
- تعداد پروژه همزمان: 40-60
- مناسب برای: شرکتهای بزرگ، مراکز ابری AI
سطح 3 – شانزده SU (4,096 GPU):
- سرمایهگذاری: حدود 280 میلیون دلار
- زمان آموزش مدل تریلیون پارامتری: چند هفته
- تعداد پروژه همزمان: 150-200
- مناسب برای: غولهای فناوری، مراکز تحقیقاتی ملی
شبکههای چهارگانه SuperPOD
یکی از دلایل عملکرد استثنایی SuperPOD، معماری شبکه چندلایه آن است:
1. Compute Fabric (InfiniBand NDR 400Gb/s):
- وظیفه: ارتباط GPU-to-GPU برای آموزش
- تأخیر: کمتر از 1 میکروثانیه
- ویژگی خاص: NVIDIA SHARP برای AllReduce سختافزاری
2. Storage Fabric (InfiniBand HDR 200Gb/s):
- وظیفه: خواندن/نوشتن داده از استوریج
- توان عملیاتی: 2+ TB/s برای خواندن
- ویژگی خاص: مسیرهای چندگانه برای قابلیت اطمینان
3. In-Band Management (Ethernet 1/10GbE):
- وظیفه: جمعآوری متریکها، توزیع نرمافزار
- پروتکل: SSH، HTTPS، Prometheus
4. Out-of-Band Management (Ethernet 1GbE):
- وظیفه: دسترسی BMC، restart از راه دور
- امنیت: شبکه مجزا از سایر بخشها
بخش پنجم: مقایسه جامع و تحلیل هزینه-فایده
جدول تصمیمگیری: کدام سیستم برای شما؟
| معیار | DGX H100/H200/B200 | HGX-based Custom Server | DGX SuperPOD |
|---|---|---|---|
| زمان راهاندازی | 8-16 هفته | 11-19 هفته | 3-6 ماه |
| هزینه اولیه (8 GPU) | 350K-500K دلار | 320K-480K دلار | 20M+ دلار (256 GPU) |
| انعطافپذیری سختافزار | محدود | بسیار بالا | متوسط |
| پشتیبانی فنی | NVIDIA مستقیم 24/7 | چند vendor | NVIDIA مختص SuperPOD |
| عملکرد تضمینشده | بله (MLPerf) | خیر (بستگی به پیکربندی) | بله (سطح بالا) |
| سفارشیسازی نرمافزار | محدود | کامل | متوسط |
| مقیاسپذیری | تا 8 سیستم آسان | دستی | تا هزاران GPU |
| مناسب برای | تیمهای تحقیقاتی، شرکتهای متوسط | سازمانهای با نیاز خاص | شرکتهای بزرگ، hyperscalers |
تحلیل هزینه تمامشده مالکیت (TCO) – سناریوی 5 ساله
فرض کنید یک سازمان نیاز به معادل 100 GPU برای کارهای خود دارد:
سناریو A: خرید DGX H200 (13 سیستم):
- هزینه خرید: 13 × 450,000 = 5.85 میلیون دلار
- برق (5 سال): 1.8 میلیون دلار
- خنکسازی: 900 هزار دلار
- نگهداری: 600 هزار دلار (تحت گارانتی)
- TCO کل: 9.15 میلیون دلار
- مزایا: راهاندازی سریع، پشتیبانی کامل، عملکرد تضمینشده
- معایب: هزینه اولیه بالاتر، انعطاف محدود
سناریو B: ساخت سرور با HGX H200 (13 سیستم):
- هزینه خرید: 13 × 380,000 = 4.94 میلیون دلار
- برق (5 سال): 1.8 میلیون دلار
- خنکسازی: 900 هزار دلار
- نگهداری: 1.2 میلیون دلار (چند vendor)
- هزینه یکپارچهسازی: 400 هزار دلار
- TCO کل: 9.24 میلیون دلار
- مزایا: سفارشیسازی کامل، انعطاف بالا
- معایب: زمان راهاندازی طولانیتر، پیچیدگی مدیریت
تحلیل: در این سناریو، تفاوت هزینه TCO تنها حدود 100 هزار دلار است، اما عوامل غیرمالی مانند زمان، ریسک و تخصص فنی میتوانند تصمیمگیرنده باشند.
سناریو C: SuperPOD با H200 (یک SU – 256 GPU):
- هزینه خرید: 21 میلیون دلار (شامل شبکه و استوریج)
- برق (5 سال): 3.5 میلیون دلار
- خنکسازی: 1.8 میلیون دلار
- نگهداری: 2 میلیون دلار
- TCO کل: 28.3 میلیون دلار
- هزینه به ازای هر GPU: 110 هزار دلار
- مزایا: مقیاسپذیری استثنایی، عملکرد شبکه بینظیر، مدیریت متمرکز
- معایب: سرمایهگذاری عظیم اولیه، مناسب فقط برای سازمانهای بزرگ
بخش ششم: کاربردهای عملی و موارد استفاده
صنعت مالی و بانکداری
چالش: یک بانک بینالمللی نیاز به تحلیل real-time تراکنشها برای تشخیص تقلب دارد. حجم تراکنشها روزانه 500 میلیون است.
راهحل: استقرار 4 سیستم DGX H200 برای استنتاج real-time
- مدل: شبکه عصبی با 30 میلیارد پارامتر
- تأخیر: کمتر از 10 میلیثانیه برای هر تراکنش
- دقت تشخیص: بهبود 35% نسبت به سیستم قبلی
- صرفهجویی سالانه: 40 میلیون دلار از جلوگیری تقلب
بهداشت و درمان
چالش: یک مرکز تحقیقاتی سرطان میخواهد مدلی برای پیشبینی پاسخ به درمان بر اساس ژنوم بیمار توسعه دهد.
راهحل: ساخت کلاستر 16-GPU با HGX H100
- دیتاست: 100,000 ژنوم کامل انسانی
- مدل: Transformer با 50 میلیارد پارامتر
- زمان آموزش: 6 هفته (در مقابل 8 ماه با سرورهای قبلی)
- دقت پیشبینی: 78% (نسبت به 52% روشهای سنتی)
صنعت خودرو
چالش: یک خودروساز میخواهد سیستم رانندگی خودکار سطح 4 توسعه دهد که نیاز به آموزش روی میلیاردها فریم ویدیویی دارد.
راهحل: استقرار یک DGX SuperPOD با 512 GPU
- دیتاست: 10 پتابایت ویدیو از دهها میلیون کیلومتر رانندگی
- مدلهای همزمان: Vision Transformer، LiDAR Processing، Path Planning
- زمان آموزش هر iteration: 4 هفته
- تعداد iteration: 12 در سال (در مقابل 2-3 با زیرساخت قبلی)
تحقیقات علمی و دانشگاهی
چالش: یک دانشگاه میخواهد در حوزه مدلسازی پروتئین برای کشف دارو پیشرو باشد.
راهحل: خرید 2 سیستم DGX H100 + ساخت 2 سرور custom با HGX
- دلیل ترکیبی: DGX برای پروژههای تحقیقاتی پربازده، HGX برای دانشجویان
- نتیجه: 8 مقاله در مجلات top-tier در 18 ماه
- جذب بودجه تحقیقاتی: 15 میلیون دلار بر اساس نتایج
بخش هفتم: چالشها و راهحلها
چالشهای فنی
1. مدیریت حرارت:
- مشکل: سیستمهای 8-GPU تا 10 کیلووات حرارت تولید میکنند
- راهحل DGX: سیستم خنککننده یکپارچه با 20 فن و مسیرهای هوای بهینه
- راهحل HGX: انتخاب بین خنککننده هوایی (سادهتر اما نیاز به فضای بیشتر) یا مایع (کارآمدتر اما پیچیدهتر)
2. پهنای باند شبکه:
- مشکل: بدون شبکه مناسب، GPUها 80% وقت را منتظر داده میمانند
- راهحل: استفاده حتمی از InfiniBand برای کلاسترهای بیش از 4 نود
- جایگزین اقتصادی: Ethernet 200/400GbE با RoCEv2، اما عملکرد 10-15% کمتر
3. ذخیرهسازی:
- مشکل: دیتاستهای چند پتابایتی و نیاز به خواندن همزمان توسط صدها GPU
- راهحل: استوریج موازی مانند BeeGFS یا Lustre با حداقل 100 OSD
- هزینه: حدود 200 دلار به ازای هر ترابایت با عملکرد بالا
چالشهای سازمانی
1. کمبود متخصص:
- مشکل: تخصصهای مورد نیاز: معماری سختافزار، شبکه HPC، DevOps، MLOps
- راهحل کوتاهمدت: استفاده از مشاوران و integrator های معتبر مانند سوانتک
- راهحل بلندمدت: آموزش تیم داخلی از طریق دورههای NVIDIA DLI
2. مدیریت انتظارات:
- مشکل: انتظار عملکرد خطی با افزودن GPU (که همیشه محقق نمیشود)
- راهحل: تست POC با حجم کوچکتر قبل از سرمایهگذاری بزرگ
- واقعبینی: در بهترین حالت 85-95% efficiency scaling
3. تعادل بین سرعت و انعطاف:
- دوراهی: DGX سریع اما سفت، HGX انعطافپذیر اما زمانبر
- توصیه: شروع با DGX برای نیازهای فوری، افزودن HGX برای گسترش
بخش هشتم: نقشه راه تصمیمگیری
فرآیند تصمیمگیری گامبهگام
گام 1: ارزیابی نیازها (2-4 هفته)
پرسشهای کلیدی:
- چه مدلهایی میخواهیم آموزش دهیم؟ (اندازه، معماری)
- چند پروژه بهطور همزمان اجرا میشود؟
- آیا نیاز به استنتاج real-time داریم؟
- حجم دیتاستهای ما چقدر است؟
- بودجه در دسترس چقدر است؟
- زمان راهاندازی چقدر مهم است؟
گام 2: محاسبه منابع (1-2 هفته)
ابزارهای کمکی:
- NVIDIA GPU Calculator برای تخمین تعداد GPU
- MLPerf Benchmarks برای مقایسه عملکرد
- TCO Calculator برای محاسبه هزینه 5 ساله
گام 3: بررسی گزینهها (2-3 هفته)
سه مسیر اصلی:
- مسیر A: خرید DGX (اگر سرعت اولویت است)
- مسیر B: ساخت با HGX (اگر سفارشیسازی اولویت است)
- مسیر C: SuperPOD (اگر مقیاس بزرگ هدف است)
گام 4: POC و اعتبارسنجی (4-8 هفته)
توصیه اکید:
- اجاره کوتاهمدت از cloud providers (Lambda Labs، CoreWeave)
- تست workload های واقعی خود
- اندازهگیری عملکرد و هزینه واقعی
گام 5: تصمیم و اجرا (12-24 هفته)
بسته به گزینه انتخابی:
- DGX: سفارش → تحویل (8-16 هفته) → راهاندازی (1-2 هفته)
- HGX: طراحی (2-4 هفته) → تهیه (6-10 هفته) → یکپارچهسازی (3-4 هفته)
- SuperPOD: طراحی دیتاسنتر (8-12 هفته) → نصب (12-16 هفته)
ماتریس تصمیمگیری سریع
| اگر شما… | توصیه |
|---|---|
| استارتاپ AI با بودجه محدود | Cloud GPU (Lambda، RunPod) یا 1-2 DGX H100 |
| شرکت متوسط با تیم فنی قوی | 4-8 سرور HGX سفارشی |
| شرکت بزرگ با پروژههای متعدد | 8-16 سیستم DGX H200/B200 |
| غول فناوری یا hyperscaler | DGX SuperPOD (256+ GPU) |
| دانشگاه/مرکز تحقیقاتی | ترکیب 2-4 DGX + 4-8 HGX |
| سرویسدهنده API تجاری | Inference-optimized با 16-32 GPU |
نتیجهگیری
انتخاب بین سیستمهای NVIDIA DGX و پلتفرم HGX یک تصمیم استراتژیک است که باید بر اساس نیازهای خاص سازمان، بودجه، زمان راهاندازی و تخصص تیم فنی گرفته شود. DGX برای سازمانهایی که به سرعت، قابلیت اطمینان و پشتیبانی جامع نیاز دارند، گزینهای عالی است. در مقابل، HGX برای سازمانهایی که نیازهای خاصی دارند و میخواهند هزینهها را بهینه کنند، انعطافپذیری بیشتری ارائه میدهد.
برای سازمانهای بزرگ که به مقیاسپذیری استثنایی نیاز دارند، DGX SuperPOD با معماری شبکه پیشرفته و مدیریت متمرکز، راهحلی بینظیر است. در نهایت، مهمترین عامل این است که زیرساخت انتخابی شما بتواند با رشد نیازهای کسبوکارتان همگام شود و به شما امکان نوآوری مداوم در حوزه هوش مصنوعی را بدهد.
برای مشاوره تخصصی، دریافت قیمت بهروز و بررسی گزینههای تامین سیستمهای NVIDIA DGX و HGX در ایران، با تیم متخصصان سوانتک تماس بگیرید.
«در پروژههای تحقیقاتی که بودجه محدود است، استفاده از HGX به ما اجازه داد تا با انتخاب پردازندههای AMD و حافظههای اقتصادیتر، بدون قربانی کردن قدرت GPU، حدود ۱۵ درصد در هزینه نهایی صرفهجویی کنیم.» — مدیر فنی آزمایشگاه پردازش سریع
«برای ما که در حوزه بانکی فعالیت میکنیم، “زمان” ارزشمندترین دارایی است. انتخاب DGX به جای ساخت سرورهای سفارشی، ریسک عدم هماهنگی درایورها و شبکه را به صفر رساند و ما توانستیم مدل تشخیص تقلب خود را دو ماه زودتر عملیاتی کنیم.» — معمار ارشد زیرساخت فینتک
«جهش از H100 به B200 فقط یک ارتقای ساده نیست؛ این یک تغییر پارادایم در بازده انرژی است. با استفاده از سیستمهای جدید، ما توانستیم در همان فضای فیزیکی رکها، قدرت پردازشی را بیش از دو برابر کنیم بدون اینکه سیستم خنککننده دیتاسنتر را تغییر دهیم.» — مدیر عملیات دیتاسنتر ابری
✅ این مطلب توسط تیم فنی سوان تک بازبینی و در سال ۱۴۰۵ (۲۰۲۶) بهروزرسانی شده است.