


توضیحات
NVIDIA H200 – دنیای هوش مصنوعی در سالهای اخیر با سرعتی باورنکردنی در حال پیشرفت است. مدلهای زبانی بزرگ مانند GPT-4، Claude و Llama با میلیاردها پارامتر، نیاز به منابع محاسباتی و حافظهای عظیمی دارند که محدودیتهای سختافزاری را به چالشی جدی برای محققان و توسعهدهندگان تبدیل کرده است. تا همین چند سال پیش، آموزش یک مدل زبانی با صد میلیارد پارامتر هفتهها زمان میبرد و هزینههای نجومی داشت. استنتاج این مدلها نیز آنقدر کند بود که استفاده تجاری از آنها برای بسیاری از کسبوکارها غیرممکن به نظر میرسید.
در این میان، NVIDIA به عنوان پیشتاز صنعت پردازندههای گرافیکی و محاسبات موازی، گام بلندی برای حل این معضل برداشته است. شرکت آمریکایی NVIDIA که سالهاست در حوزه GPU های تخصصی برای یادگیری ماشین فعالیت میکند، با معرفی NVIDIA H200 Tensor Core GPU نشان داده که چگونه میتوان با بهرهگیری از جدیدترین فناوری حافظه HBM3e، مرزهای عملکرد را جابهجا کرد. این پردازنده نه تنها اولین GPU تجاری مجهز به حافظه HBM3e در جهان است، بلکه با ارائه 141 گیگابایت حافظه و پهنای باند 4.8 ترابایت بر ثانیه، رکوردهای قبلی را درهم شکسته و معیارهای جدیدی را برای صنعت AI تعریف کرده است.
H200 نسخه ارتقایافته H100 است که خود یکی از موفقترین محصولات NVIDIA در حوزه مراکز داده بود. اما تفاوت H200 با نسل قبلی خود فقط در اعداد و ارقام نیست؛ این پردازنده با معماری Hopper بهینهشده، قابلیتهای جدیدی برای آموزش سریعتر مدلهای عظیم، استنتاج بلادرنگ در مقیاس بزرگ و اجرای محاسبات علمی پیچیده را به ارمغان آورده است. در این مقاله، به بررسی جامع این محصول خواهیم پرداخت و خواهیم دید که چرا H200 میتواند نقطه عطفی در صنعت هوش مصنوعی و محاسبات با کارایی بالا باشد.
معماری Hopper: قلب تپنده H200

NVIDIA H200 بر پایه معماری Hopper ساخته شده است که نام آن از گریس هاپر، یکی از پیشگامان علم کامپیوتر، گرفته شده است. این معماری که برای اولین بار در سال 2022 معرفی شد، نسل بعد از معماری Ampere است و بهطور خاص برای بارهای کاری هوش مصنوعی و محاسبات علمی طراحی شده است. قلب این معماری، Tensor Cores نسل چهارم هستند که قابلیتهای محاسباتی بینظیری را برای عملیات ماتریسی مورد استفاده در شبکههای عصبی عمیق فراهم میکنند.
Tensor Cores واحدهای محاسباتی تخصصی هستند که بهجای پردازش تکتک اعداد، عملیات ماتریسی را بهصورت موازی انجام میدهند. H200 دارای 528 Tensor Core است که میتوانند عملیات ضرب و جمع ماتریسها را با سرعتی چند برابر بیشتر از هستههای معمولی CUDA انجام دهند. این Tensor Cores از فرمتهای عددی مختلفی از جمله FP64، FP32، FP16، BF16 و FP8 پشتیبانی میکنند که به توسعهدهندگان امکان میدهد بسته به نیاز خود، بین دقت و سرعت توازن برقرار کنند. برای مثال، در مرحله آموزش مدلهای زبانی که نیاز به دقت بالاست، از فرمت FP16 استفاده میشود، اما در مرحله استنتاج که سرعت اهمیت بیشتری دارد، FP8 میتواند عملکرد را تا دو برابر افزایش دهد.
علاوه بر Tensor Cores، H200 دارای 16,896 هسته CUDA است که برای محاسبات عمومیمنظوره و کارهایی که نیاز به پردازش موازی دارند، مورد استفاده قرار میگیرند. این هستهها در 144 Streaming Multiprocessor (SM) سازماندهی شدهاند و میتوانند هزاران thread را بهطور همزمان اجرا کنند. معماری Hopper همچنین دارای واحدهای جدیدی برای شتابدهی عملیات Transformer است که پایه اصلی مدلهای زبانی مدرن مانند BERT، GPT و T5 هستند. این بهینهسازیها باعث شده که H200 بتواند در کارهای NLP (پردازش زبان طبیعی) عملکردی استثنایی داشته باشد.
یکی دیگر از نوآوریهای معماری Hopper، پشتیبانی از NVLink نسل چهارم است که امکان اتصال چندین GPU با پهنای باند بسیار بالا را فراهم میکند. در فرم فاکتور SXM، هر H200 میتواند با سرعت 900 گیگابایت بر ثانیه با دیگر GPUها ارتباط برقرار کند. این قابلیت برای آموزش مدلهایی که به چندین GPU نیاز دارند، حیاتی است، چرا که کمترین تأخیر در انتقال داده بین GPUها میتواند عملکرد کلی سیستم را دچار افت کند. با NVLink نسل چهارم، هشت GPU H200 میتوانند بهعنوان یک واحد یکپارچه عمل کنند و حافظه و قدرت محاسباتی خود را با یکدیگر به اشتراک بگذارند.
در نهایت، معماری Hopper با قابلیت Multi-Instance GPU (MIG) امکان تقسیم یک GPU فیزیکی به چندین GPU مجازی را فراهم میکند. این ویژگی برای مراکز داده و ارائهدهندگان خدمات ابری بسیار ارزشمند است، چرا که اجازه میدهد منابع GPU بهطور کارآمدتری بین کاربران مختلف تقسیم شود و از ظرفیت سختافزار حداکثر بهرهبرداری صورت گیرد.
فناوری HBM3e: انقلاب حافظه
یکی از مهمترین تفاوتهای H200 با نسل قبلی خود، استفاده از حافظه HBM3e (High Bandwidth Memory 3 Enhanced) است. این فناوری جدیدترین نسل حافظههای با پهنای باند بالا است که برای اولین بار در یک محصول تجاری NVIDIA بهکار رفته است. HBM3e نه تنها ظرفیت بیشتری نسبت به HBM3 و HBM2e دارد، بلکه سرعت انتقال داده آن نیز بهطور قابلتوجهی افزایش یافته است.
H200 با 141 گیگابایت حافظه HBM3e، 76 درصد حافظه بیشتری نسبت به H100 (که 80 گیگابایت HBM3 دارد) در اختیار کاربران قرار میدهد. این افزایش ظرفیت به معنای این است که مدلهای بزرگتری میتوانند بهطور کامل در حافظه GPU بارگذاری شوند، بدون اینکه نیاز باشد بخشهایی از مدل در حافظه CPU یا حافظه سیستم نگهداری شوند. برای مثال، یک مدل زبانی با 70 میلیارد پارامتر مانند Llama 2 70B که در فرمت FP16 حدود 140 گیگابایت فضا اشغال میکند، میتواند بهراحتی در یک H200 بارگذاری شود، در حالی که برای H100 نیاز به تکنیکهای بهینهسازی حافظه مانند quantization یا استفاده از چندین GPU است.
اما ظرفیت بزرگتر تنها بخشی از داستان است. پهنای باند حافظه، یعنی سرعتی که GPU میتواند دادهها را از حافظه بخواند و بنویسد، نقش حیاتی در عملکرد کلی دارد. H200 با پهنای باند 4.8 ترابایت بر ثانیه، 43 درصد سریعتر از H100 (با پهنای باند 3.35 ترابایت بر ثانیه) است. این افزایش سرعت بهویژه در کارهایی که به دسترسی مکرر به حافظه نیاز دارند، مانند استنتاج مدلهای generative AI، تأثیر چشمگیری دارد. در این نوع کارها، GPU باید وزنهای مدل را بارها و بارها از حافظه بخواند تا خروجی جدیدی تولید کند، و هر تأخیر در دسترسی به حافظه مستقیماً بر سرعت تولید توکنها تأثیر میگذارد.
فناوری HBM3e با استفاده از معماری سهبعدی، چندین تراشه حافظه را روی هم قرار میدهد و آنها را با اتصالات عمودی به یکدیگر متصل میکند. این طراحی باعث میشود فاصله فیزیکی بین GPU و حافظه کاهش یابد، که به نوبه خود تأخیر (latency) را کاهش میدهد و مصرف انرژی را بهینه میکند. در واقع، یکی از دستاوردهای HBM3e این است که علیرغم افزایش ظرفیت و پهنای باند، مصرف انرژی آن کمتر از نسلهای قبلی است، که برای مراکز داده بزرگ که هزاران GPU را بهکار میگیرند، صرفهجویی قابلتوجهی در هزینههای عملیاتی ایجاد میکند.
برای درک بهتر اهمیت HBM3e، بیایید با یک مثال عملی آن را بررسی کنیم. فرض کنید میخواهید یک مدل زبانی بزرگ را برای تولید متن استفاده کنید. در هر مرحله تولید، مدل باید تمام وزنهای خود را بررسی کند تا بهترین کلمه بعدی را انتخاب کند. اگر این وزنها در حافظه کند یا با پهنای باند محدود ذخیره شده باشند، GPU بیشتر وقت خود را صرف انتظار برای دریافت داده میکند تا انجام محاسبات واقعی. با HBM3e، این انتظار به حداقل میرسد و GPU میتواند تمام توان محاسباتی خود را بهکار گیرد. در نتیجه، H200 میتواند در استنتاج مدل Llama 2 70B تا 45 درصد سریعتر از H100 عمل کند، که این یعنی زمان پاسخدهی کمتر و تجربه بهتر کاربر.
مشخصات فنی کامل H200
بیایید نگاهی جامع به مشخصات فنی NVIDIA H200 Tensor Core GPU بیندازیم و ببینیم این پردازنده چه قابلیتهایی را در اختیار کاربران خود قرار میدهد.
جدول مشخصات کلیدی
| مشخصه | NVIDIA H200 SXM | NVIDIA H200 NVL |
|---|---|---|
| معماری | NVIDIA Hopper | NVIDIA Hopper |
| فرآیند ساخت | TSMC 4N (4nm) | TSMC 4N (4nm) |
| تعداد ترانزیستورها | 80 میلیارد | 80 میلیارد |
| Tensor Cores | 528 (نسل چهارم) | 528 (نسل چهارم) |
| CUDA Cores | 16,896 | 16,896 |
| حافظه GPU | 141 GB HBM3e | 141 GB HBM3e |
| پهنای باند حافظه | 4.8 TB/s | 4.8 TB/s |
| رابط حافظه | 5120-bit | 5120-bit |
| L2 Cache | 60 MB | 60 MB |
| قدرت محاسباتی FP64 | 67 TFLOPS | 67 TFLOPS |
| قدرت محاسباتی FP32 | 134 TFLOPS | 134 TFLOPS |
| قدرت محاسباتی FP16 (Tensor) | 1,979 TFLOPS | 1,979 TFLOPS |
| قدرت محاسباتی FP8 (Tensor) | 3,958 TFLOPS | 3,958 TFLOPS |
| INT8 (Tensor) | 3,958 TOPS | 3,958 TOPS |
| TDP | 700W | 600W (دو GPU) |
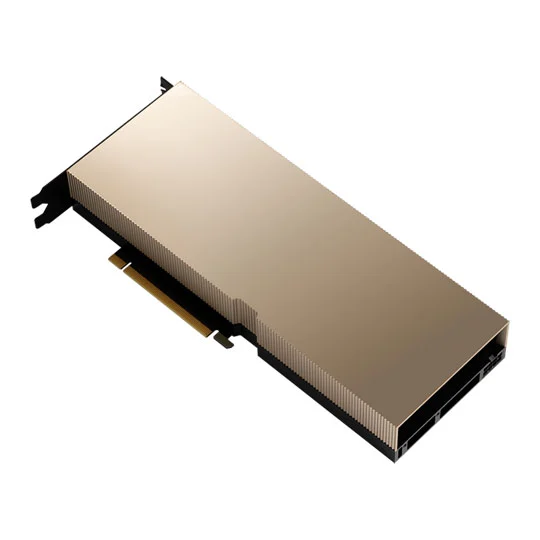
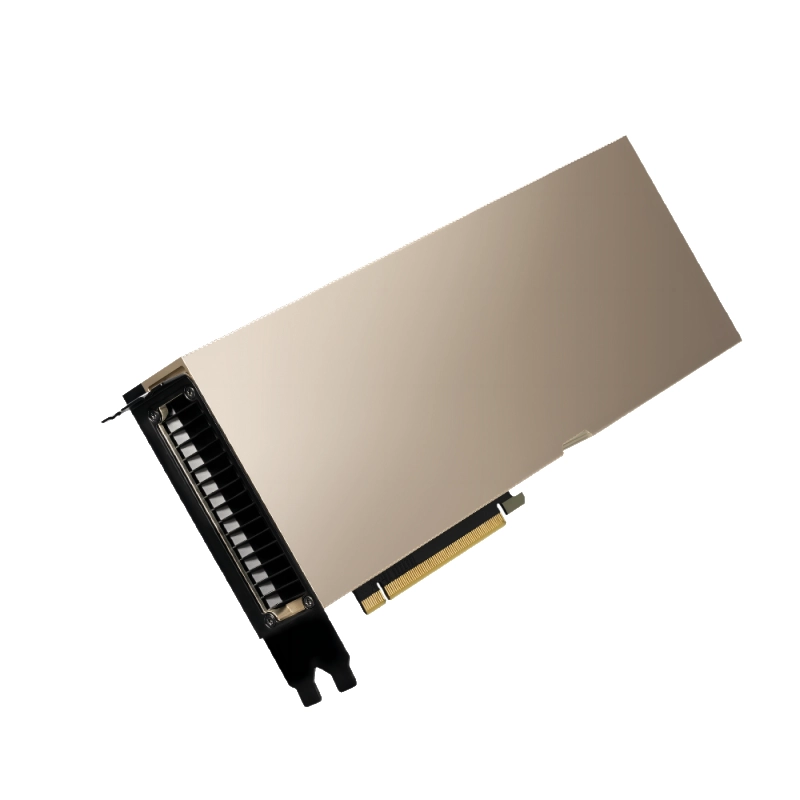
| فرم فاکتور | SXM5 | Dual-slot PCIe |
| خنکسازی | مایع/هوایی | هوایی |
| NVLink | 900 GB/s | – |
| PCIe | Gen5 x16 | Gen5 x16 |
| تاریخ عرضه | Q2 2024 | Q3 2024 |
تحلیل عمیق قدرت محاسباتی
وقتی صحبت از GPU های مخصوص یادگیری ماشین میشود، قدرت محاسباتی در فرمتهای عددی مختلف اهمیت زیادی دارد. H200 در فرمت FP64 (اعشار دوگانه با دقت بالا) میتواند 67 تریلیون عملیات در ثانیه انجام دهد، که برای محاسبات علمی که به دقت بسیار بالایی نیاز دارند، مانند شبیهسازیهای دینامیک سیالات محاسباتی (CFD) یا مدلسازی پروتئینها، حیاتی است. در فرمت FP32 که برای بسیاری از محاسبات گرافیکی و شبیهسازیها استفاده میشود، این عدد به 134 تریلیون عملیات در ثانیه میرسد.
اما واقعیت این است که اکثر کارهای یادگیری عمیق نیازی به این سطح از دقت ندارند. Tensor Cores که برای عملیات ماتریسی بهینه شدهاند، میتوانند با فرمتهای کمدقتتر مانند FP16 و FP8 عملکرد بسیار بالاتری ارائه دهند. H200 در فرمت FP16 قادر به انجام 1,979 تریلیون عملیات در ثانیه است، و در FP8 این عدد به 3,958 تریلیون میرسد. این افزایش دو برابری در FP8 به این دلیل است که هر عملیات FP8 فقط نصف بیتهای یک عملیات FP16 را اشغال میکند، بنابراین در همان زمان میتوان دو برابر عملیات انجام داد.
برای کارهای استنتاج که سرعت از دقت مهمتر است، FP8 انتخاب ایدهآلی است. تحقیقات نشان داده که در اکثر مدلهای زبانی و بینایی، کاهش دقت از FP16 به FP8 تأثیر بسیار کمی بر کیفیت خروجی دارد، اما سرعت را تا دو برابر افزایش میدهد. به همین دلیل است که H200 در بنچمارکهای استنتاج عملکردی درخشان دارد.
مصرف انرژی و مدیریت حرارت
با TDP برابر 700 وات در نسخه SXM، H200 یک پردازنده پرمصرف است که نیاز به سیستم خنککاری قوی دارد. این میزان مصرف انرژی ممکن است در نگاه اول بالا به نظر برسد، اما وقتی آن را با قدرت محاسباتی H200 مقایسه میکنیم، متوجه میشویم که بازدهی انرژی این پردازنده در واقع بسیار خوب است. نسبت عملکرد به توان (Performance per Watt) در H200 نسبت به نسلهای قبلی بهبود یافته، که یعنی برای هر واحد انرژی مصرفی، محاسبات بیشتری انجام میشود.
برای مراکز داده بزرگی که صدها یا هزاران GPU نصب میکنند، مدیریت حرارت یک چالش اساسی است. H200 با طراحی بهینه گرما و پشتیبانی از سیستمهای خنککاری مایع، میتواند در محیطهای پرتراکم نیز بهطور پایدار کار کند. نسخه NVL که دو GPU را در یک کارت PCIe قرار میدهد، با TDP کمتر (600 وات برای هر دو GPU) و خنککاری هوایی طراحی شده که نصب آن در سرورهای استاندارد را آسانتر میکند.
مقایسه جامع H200 و H100
حالا که با مشخصات فنی H200 آشنا شدیم، بیایید آن را با پرچمدار نسل قبل، یعنی H100، مقایسه کنیم تا ببینیم چه بهبودهایی حاصل شده است.
جدول مقایسه مستقیم
| مشخصه | NVIDIA H200 | NVIDIA H100 | بهبود |
|---|---|---|---|
| حافظه GPU | 141 GB HBM3e | 80 GB HBM3 | +76% |
| پهنای باند حافظه | 4.8 TB/s | 3.35 TB/s | +43% |
| نوع حافظه | HBM3e | HBM3 | نسل جدید |
| Tensor Cores | 528 | 528 | یکسان |
| CUDA Cores | 16,896 | 16,896 | یکسان |
| قدرت FP8 (Tensor) | 3,958 TFLOPS | 3,958 TFLOPS | یکسان |
| TDP | 700W | 700W | یکسان |
| L2 Cache | 60 MB | 60 MB | یکسان |
| NVLink | 900 GB/s | 900 GB/s | یکسان |
| عملکرد آموزش (GPT-3) | مرجع | -48% | +90%~ |
| عملکرد استنتاج (Llama 2 70B) | 31,000+ tokens/s | ~21,000 tokens/s | +45% |
| قیمت (تخمینی) | $40,000-55,000 | $30,000-40,000 | +25%~ |
تحلیل تفاوتهای کلیدی
همانطور که از جدول بالا مشخص است، تفاوت اصلی H200 و H100 در بخش حافظه است. هر دو پردازنده از همان معماری Hopper و تعداد یکسانی Tensor Core و CUDA Core استفاده میکنند، اما H200 با 141 گیگابایت حافظه HBM3e و پهنای باند 4.8 ترابایت بر ثانیه، بهطور قابلتوجهی از H100 پیشی گرفته است. این افزایش 76 درصدی ظرفیت حافظه و 43 درصدی پهنای باند، دقیقاً همان چیزی است که بسیاری از کاربردهای AI مدرن به آن نیاز داشتند.
اما سوال اینجاست: این اعداد در عمل چه تأثیری دارند؟ برای پاسخ به این سوال، باید به بنچمارکهای واقعی نگاه کنیم. در بنچمارک MLPerf v5.0 که استانداردی برای سنجش عملکرد سیستمهای AI است، H200 در کارهای آموزش مدلهای زبانی مانند GPT-3 تا 90 درصد سریعتر از H100 عمل کرد. این بهبود عظیم به این دلیل است که مدلهای بزرگتر میتوانند بهطور کامل در حافظه H200 بارگذاری شوند، بدون اینکه نیاز باشد بخشهایی از مدل به CPU offload شوند یا از تکنیکهای بهینهسازی حافظه استفاده شود که خود باعث کاهش سرعت میشوند.
در کارهای استنتاج نیز H200 عملکرد چشمگیری دارد. برای مدل Llama 2 70B که یکی از محبوبترین مدلهای متنباز است، H200 میتواند بیش از 31,000 توکن در ثانیه تولید کند، در حالی که H100 حدود 21,000 توکن در ثانیه تولید میکند. این 45 درصد بهبود یعنی زمان پاسخدهی کمتر برای کاربران نهایی و امکان سرویسدهی به تعداد بیشتری از درخواستهای همزمان. برای یک ارائهدهنده خدمات ابری که مدلهای زبانی را به صورت API عرضه میکند، این بهبود میتواند به معنای کاهش قابلتوجه در تعداد GPUهای مورد نیاز و در نتیجه صرفهجویی در هزینهها باشد.
چه زمانی ارتقا به NVIDIA H200 ارزش دارد؟
با توجه به اینکه قیمت H200 حدود 25 تا 40 درصد بیشتر از H100 است، سوال مهم این است که آیا ارتقا به این محصول توجیه اقتصادی دارد یا نه. پاسخ به این سوال بستگی به نوع کاربرد شما دارد.
اگر در حال کار بر روی مدلهای زبانی بزرگ با بیش از 70 میلیارد پارامتر هستید، H200 تقریباً یک انتخاب ضروری است. این مدلها بهسادگی در 80 گیگابایت حافظه H100 جا نمیشوند، مگر اینکه از تکنیکهای quantization استفاده کنید که میتواند کیفیت مدل را کاهش دهد. با H200، میتوانید این مدلها را با دقت کامل اجرا کنید و از عملکرد بهتری برخوردار شوید.
برای کارهای استنتاج که نیاز به پاسخدهی در زمان واقعی دارند، مانند چتباتها، دستیارهای صوتی یا سیستمهای ترجمه خودکار، بهبود 45 درصدی سرعت در H200 میتواند هزینه اضافی آن را توجیه کند. با سرعت بالاتر، میتوانید با تعداد کمتری GPU به همان میزان درخواست پاسخ دهید، که در بلندمدت به صرفهجویی در هزینه منجر میشود.
از طرف دیگر، اگر کارهای شما محدود به مدلهای کوچکتر (زیر 30 میلیارد پارامتر) است یا در حوزههایی مانند بینایی کامپیوتر کار میکنید که نیاز به حافظه کمتری دارند، شاید بتوانید با H100 به نتایج رضایتبخشی برسید و هزینه کمتری پرداخت کنید. همچنین اگر بودجه شما محدود است و نمیتوانید قیمت بالاتر H200 را بپردازید، H100 همچنان یک پردازنده بسیار قدرتمند و قابل است که برای بسیاری از کاربردها مناسب است.
بنچمارکهای واقعی: H200 در عمل
اعداد و ارقام مشخصات فنی مهم هستند، اما آنچه واقعاً اهمیت دارد عملکرد در دنیای واقعی است. بیایید نگاهی به بنچمارکهای واقعی H200 در سناریوهای مختلف بیندازیم.
عملکرد در مدلهای زبانی بزرگ (LLM)
یکی از مهمترین بنچمارکها برای ارزیابی GPU های AI، MLPerf است که توسط کنسرسیومی از شرکتهای فناوری برگزار میشود. در MLPerf Inference v5.0، سیستمهای مجهز به H200 رکوردهای جدیدی را ثبت کردند. برای مدل Llama 2 70B که یکی از چالشبرانگیزترین مدلها به لحاظ نیاز به حافظه است، یک سیستم 8-GPU H200 توانست بیش از 31,000 توکن در ثانیه تولید کند. این عدد در مقایسه با 21,000 توکن در ثانیه برای H100، بهبود 48 درصدی را نشان میدهد.
برای درک بهتر این اعداد، بیایید آن را به مثالی عملی تبدیل کنیم. فرض کنید یک سرویس چتبات دارید که از Llama 2 70B استفاده میکند. هر پاسخ بهطور متوسط 100 کلمه (حدود 130 توکن) دارد. با H200، شما میتوانید در هر ثانیه به بیش از 230 درخواست کاربر پاسخ دهید (با فرض استفاده از 8 GPU)، در حالی که با H100 این عدد حدود 160 درخواست است. این یعنی با همان تعداد GPU، میتوانید 44 درصد کاربر بیشتری را سرویسدهی کنید.
آموزش مدلهای پیچیده
در حوزه آموزش مدلها، H200 نیز عملکرد قابلتوجهی دارد. بر اساس گزارشهای منتشر شده از شرکتهایی مانند Lambda Labs و CoreWeave، آموزش یک مدل GPT-3 با 175 میلیارد پارامتر با H200 تا 90 درصد سریعتر از H100 است. این بهبود عمدتاً به دلیل ظرفیت حافظه بیشتر است که اجازه میدهد batch size بزرگتری استفاده شود. با batch size بزرگتر، GPU میتواند در هر مرحله از آموزش، دادههای بیشتری را پردازش کند، که منجر به استفاده بهینهتر از منابع محاسباتی میشود.
برای یک پروژه تحقیقاتی که میخواهد یک مدل زبانی سفارشی با 100 میلیارد پارامتر بر روی 500 میلیارد توکن آموزش دهد، این تفاوت میتواند بسیار چشمگیر باشد. با H100، چنین پروژهای ممکن است 2-3 ماه زمان ببرد، اما با H200 این زمان به 1-1.5 ماه کاهش مییابد. علاوه بر صرفهجویی در زمان، این یعنی صرفهجویی قابلتوجه در هزینههای برق، خنکسازی و استهلاک سختافزار.
محاسبات HPC و شبیهسازیهای علمی
H200 فقط برای AI طراحی نشده است؛ این پردازنده در محاسبات علمی با کارایی بالا (HPC) نیز عملکردی استثنایی دارد. در شبیهسازیهای دینامیک سیالات محاسباتی (CFD) که برای طراحی هواپیما، خودرو یا توربینهای بادی استفاده میشود، H200 به دلیل حافظه بیشتر میتواند مشهای (meshes) با جزئیات بالاتری را در حافظه GPU نگه دارد، که منجر به نتایج دقیقتر و زمان شبیهسازی کمتر میشود.
در پروژههای تحقیقاتی دانشگاهی مانند مدلسازی تغییرات آبوهوا، شبیهسازی فرآیندهای مولکولی یا تحلیل دادههای نجومی، که نیاز به پردازش حجم عظیمی از دادهها دارند، H200 میتواند سرعت تحقیق را بهطور قابلتوجهی افزایش دهد. یکی از پروژههای معروف که از GPU های NVIDIA استفاده میکند، پروژه Folding@home است که برای مطالعه تا شدن پروتئینها طراحی شده است. با H200، محققان میتوانند شبیهسازیهای پیچیدهتری را در زمان کوتاهتری انجام دهند و به نتایج سریعتر برسند.
Generative AI و تولید محتوا
یکی دیگر از کاربردهای هیجانانگیز H200، تولید محتوای generative است. مدلهایی مانند Stable Diffusion XL برای تولید تصویر، Whisper برای تبدیل گفتار به متن، و MusicGen برای تولید موسیقی، همگی میتوانند از قدرت H200 بهرهمند شوند. در تولید تصویر با کیفیت بالا، که نیاز به اجرای صدها مرحله denoising دارد، سرعت بالاتر H200 میتواند زمان تولید هر تصویر را از چند دقیقه به چند ثانیه کاهش دهد.
برای استودیوهای انیمیشن یا شرکتهای بازیسازی که میخواهند از AI برای تولید asset های بصری استفاده کنند، این بهبود سرعت میتواند فرآیند تولید را متحول کند. به جای اینکه هنرمندان ساعتها منتظر رندر شدن یک صحنه باشند، میتوانند در زمان واقعی ایدههای مختلف را آزمایش کنند و خلاقیت خود را به سطح جدیدی برسانند.
فرم فاکتورهای مختلف NVIDIA H200
NVIDIA برای پاسخ به نیازهای متنوع مشتریان، H200 را در چند فرم فاکتور مختلف عرضه میکند. هر فرم فاکتور برای یک سناریوی کاربرد خاص طراحی شده است.
H200 SXM: قدرت خالص برای مراکز داده بزرگ
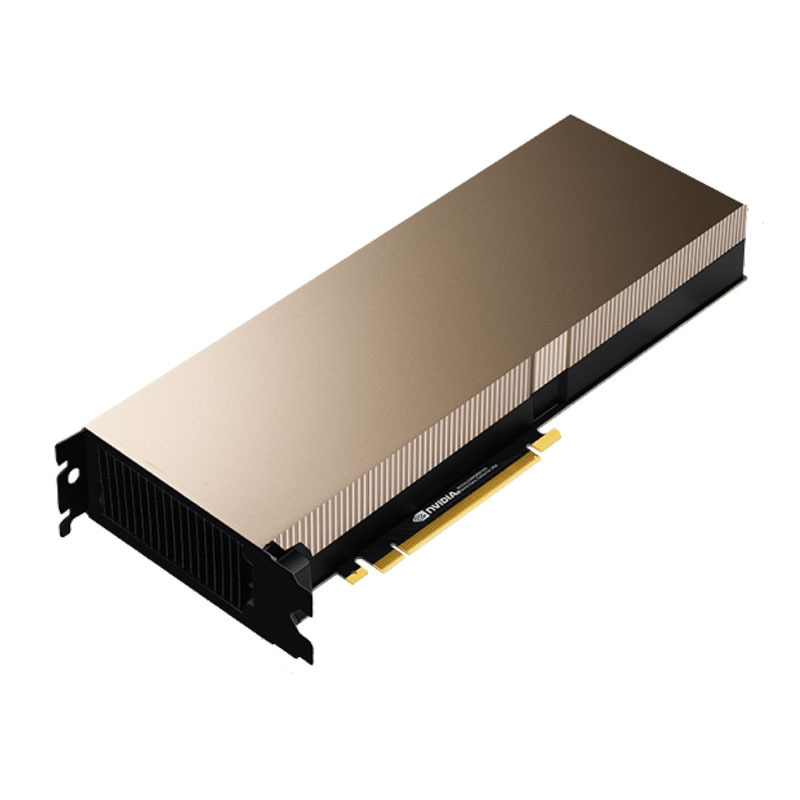
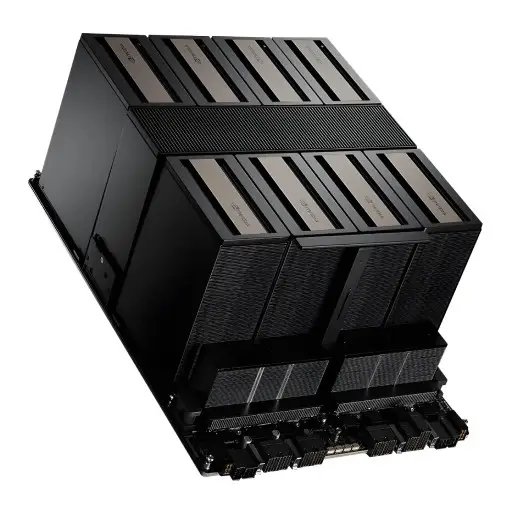
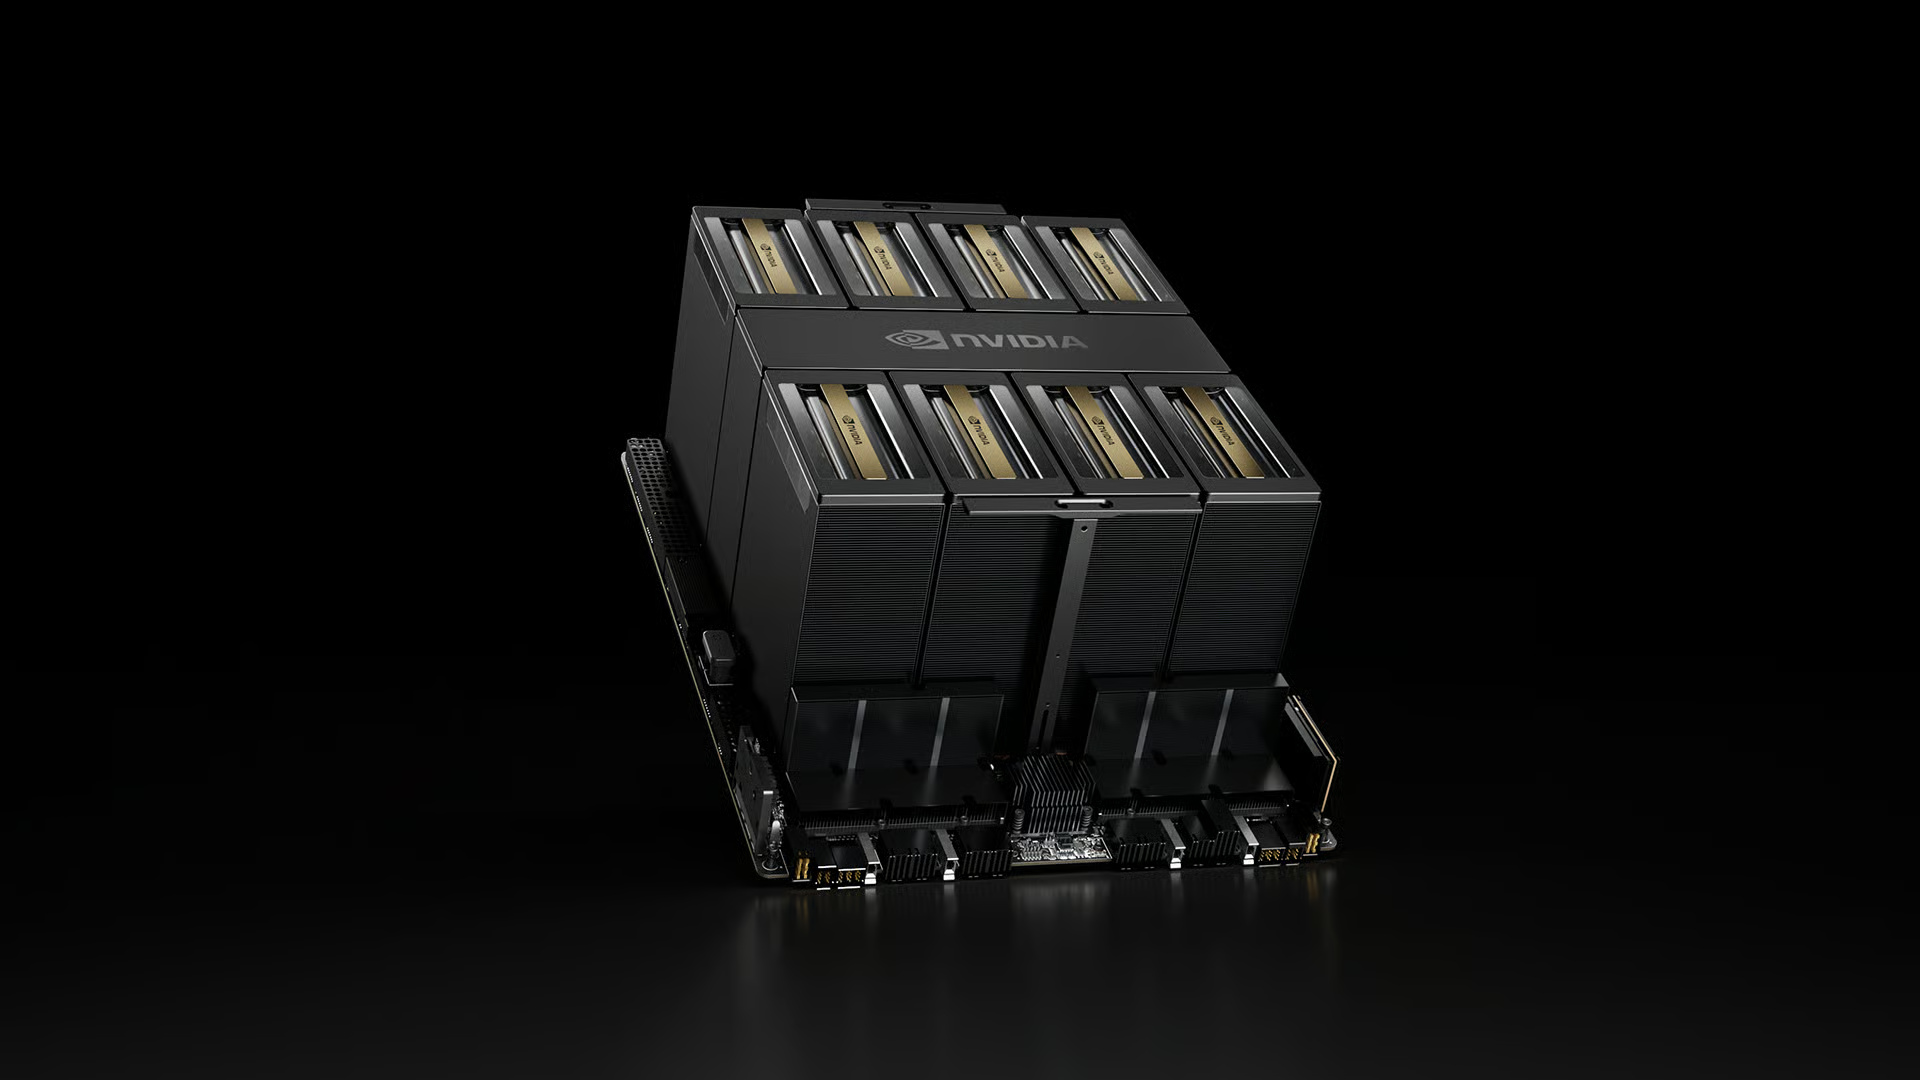
فرم فاکتور SXM (Server PCI Express Module) مخصوص سیستمهای HGX (High-Performance GPU eXtension) است که برای مراکز دادهای طراحی شدهاند که به حداکثر عملکرد نیاز دارند. در این فرم فاکتور، H200 بهصورت ماژولی طراحی شده که مستقیماً به برد اصلی سیستم متصل میشود، نه از طریق اسلات PCIe. این طراحی امکان اتصالات پهنای باند بسیار بالا بین GPUها را فراهم میکند.
در یک سیستم HGX H200، هشت GPU از طریق NVLink نسل چهارم به یکدیگر متصل میشوند و میتوانند با سرعت 900 گیگابایت بر ثانیه داده رد و بدل کنند. این یعنی تمام 1.1 ترابایت حافظه (141 GB × 8) میتواند بهعنوان یک استخر حافظه مشترک عمل کند و مدلهای بزرگی که در یک GPU جا نمیشوند، میتوانند بهطور شفاف بین چندین GPU توزیع شوند. برای آموزش مدلهای عظیم با صدها میلیارد یا حتی تریلیونها پارامتر، این قابلیت ضروری است.
سیستمهای SXM معمولاً به سیستم خنککاری مایع نیاز دارند، زیرا TDP هر GPU 700 وات است و هشت GPU با هم 5.6 کیلووات حرارت تولید میکنند. این سیستمها بیشتر در مراکز داده بزرگ شرکتهایی مانند Google، Meta، Microsoft و OpenAI استفاده میشوند که نیاز به آموزش مدلهای frontier دارند. قیمت یک سیستم کامل DGX H200 با هشت GPU حدود 500,000 دلار تخمین زده میشود.
NVIDIA H200 NVL: تعادل قدرت و انعطافپذیری
H200 NVL (NVIDIA NVLink) فرم فاکتور جدیدی است که NVIDIA برای پاسخ به نیاز بازار به راهحلی میانراه بین قدرت SXM و سادگی PCIe طراحی کرده است. در این فرم فاکتور، دو GPU H200 در یک کارت PCIe قرار داده شدهاند که از طریق NVLink به یکدیگر متصل هستند. این طراحی امکان استفاده از مزایای NVLink را بدون نیاز به سیستمهای HGX گرانقیمت فراهم میکند.
با H200 NVL، شما 282 گیگابایت حافظه (141 GB × 2) در یک کارت دارید که برای بسیاری از مدلهای بزرگ کافی است. TDP هر کارت NVL 600 وات است (300 وات برای هر GPU) که از خنککاری هوایی پشتیبانی میکند، بنابراین میتوان آن را در سرورهای استانداردی که زیرساخت خنککاری مایع ندارند نصب کرد. این باعث میشود که H200 NVL برای شرکتهای میانسطح یا استارتاپهایی که نمیخواهند در سیستمهای DGX سرمایهگذاری کنند، انتخابی مناسب باشد.
با این حال، باید توجه داشت که عملکرد NVL کمی کمتر از SXM است، هم به دلیل TDP پایینتر و هم به این دلیل که تنها دو GPU به یکدیگر متصل هستند و نمیتوان فابریک NVLink هشتتایی ساخت. برای کارهایی که به بیش از دو GPU نیاز دارند، باید چندین کارت NVL را از طریق PCIe به یکدیگر متصل کرد، که پهنای باند آن به مراتب کمتر از NVLink است.
NVIDIA H200 PCIe: سادگی و سازگاری
فرم فاکتور PCIe که هنوز بهطور رسمی عرضه نشده اما انتظار میرود در اواخر سال 2024 یا اوایل 2025 منتشر شود، برای سرورهای استانداردی طراحی شده که فقط اسلاتهای PCIe دارند. این فرم فاکتور برای شرکتهایی که زیرساخت موجود خود را میخواهند ارتقا دهند بدون اینکه نیاز به خرید سیستمهای جدید HGX داشته باشند، ایدهآل است.
H200 PCIe احتمالاً با TDP کمتری (حدود 350-400 وات) و بدون پشتیبانی از NVLink عرضه خواهد شد. این یعنی برای کارهایی که به یک GPU نیاز دارند، عملکرد خوبی خواهد داشت، اما برای کارهای چند-GPU که نیاز به ارتباط سریع بین GPUها دارند، ممکن است بهاندازه فرم فاکتورهای دیگر مناسب نباشد. با این حال، برای بسیاری از کاربردهای استنتاج، HPC و یادگیری ماشین میانسطح، H200 PCIe میتواند یک انتخاب عالی باشد.
قیمت H200 PCIe احتمالاً در محدوده 30,000 تا 40,000 دلار خواهد بود، که آن را به گزینهای مقرونبهصرفهتر نسبت به SXM تبدیل میکند. برای شرکتهای کوچکتر یا پروژههای تحقیقاتی با بودجه محدود، این میتواند راهی برای دسترسی به توان H200 بدون سرمایهگذاری عظیم باشد.
کاربردهای عملی H200
H200 یک پردازنده همهکاره است که میتواند در طیف وسیعی از کاربردها استفاده شود. بیایید به برخی از مهمترین آنها نگاهی بیندازیم.
آموزش و fine-tuning مدلهای زبانی بزرگ
یکی از محبوبترین کاربردهای H200، آموزش مدلهای زبانی بزرگ است. شرکتهای AI مانند OpenAI، Anthropic، Cohere و Stability AI از GPU های قدرتمند برای آموزش مدلهایی مانند GPT-4، Claude، Command و Stable Diffusion استفاده میکنند. با H200، این شرکتها میتوانند مدلهای بزرگتری را در زمان کوتاهتری آموزش دهند و به نتایج بهتری برسند.
برای مثال، یک شرکت که میخواهد یک مدل زبانی اختصاصی برای صنعت خود (مانند پزشکی، حقوق یا مالی) بسازد، میتواند با استفاده از H200، یک مدل موجود مانند Llama 2 را بر روی دادههای تخصصی خود fine-tune کند. با حافظه 141 گیگابایت، حتی مدلهای 70 میلیارد پارامتری را میتوان با batch size های بزرگ fine-tune کرد، که منجر به همگرایی سریعتر و کیفیت بهتر میشود.
فرآیند fine-tuning معمولاً چندین روز تا چند هفته طول میکشد، بسته به اندازه مدل و حجم داده. با H200، این زمان بهطور قابلتوجهی کاهش مییابد. برای یک پروژه تحقیقاتی که قبلاً 2 هفته برای fine-tuning نیاز داشت، با H200 این زمان ممکن است به 1 هفته یا کمتر برسد.
استنتاج سریع برای سرویسهای تولید
پس از اینکه یک مدل آموزش دیده شد، مرحله بعدی استفاده از آن برای پاسخدهی به درخواستهای کاربران است، که به آن استنتاج (inference) میگویند. برای سرویسهای تولیدی که باید به میلیونها درخواست در روز پاسخ دهند، سرعت استنتاج بسیار حیاتی است. H200 با پهنای باند حافظه بالا و پشتیبانی از فرمت FP8، یکی از بهترین گزینهها برای استنتاج سریع مدلهای بزرگ است.
شرکتهایی مانند ChatGPT، Gemini، Claude و Perplexity که سرویسهای AI محاورهای ارائه میدهند، نیاز به زیرساخت عظیمی برای استنتاج دارند. با H200، آنها میتوانند با تعداد کمتری GPU به همان تعداد کاربر خدمت بدهند، که منجر به کاهش هزینههای عملیاتی میشود. همچنین زمان پاسخدهی کمتر یعنی تجربه کاربری بهتر و رضایت بیشتر مشتریان.
برای استارتاپهایی که در حال راهاندازی سرویسهای AI هستند، H200 میتواند به آنها کمک کند تا با بودجه محدود، خدمات سریع و مقیاسپذیری ارائه دهند. به جای اینکه از همان ابتدا دهها GPU خریداری کنند، میتوانند با تعداد کمتری شروع کنند و به تدریج با رشد کاربران، سختافزار خود را گسترش دهند.
محاسبات علمی و شبیهسازیهای پیچیده
دانشمندان و محققان در رشتههای مختلف از فیزیک گرفته تا زیستشناسی، از GPU های قدرتمند برای انجام محاسبات پیچیده استفاده میکنند. H200 با قدرت محاسباتی بالا در فرمت FP64 و حافظه وسیع، برای کارهای HPC ایدهآل است.
در حوزه شیمی محاسباتی، محققان از GPU ها برای شبیهسازی برهمکنشهای مولکولی و طراحی داروهای جدید استفاده میکنند. یک شبیهسازی دینامیک مولکولی که قبلاً چندین هفته زمان میبرد، با H200 ممکن است در چند روز تکمیل شود. این شتاب در تحقیق میتواند به کشف سریعتر داروهای جدید و درمانهای بهتر منجر شود.
در علوم جوی و اقلیمشناسی، مدلهای پیشبینی آبوهوا نیاز به پردازش حجم عظیمی از دادههای ماهوارهای و زمینی دارند. H200 میتواند این دادهها را سریعتر پردازش کند و به پیشبینیهای دقیقتری منجر شود. برای پیشبینی طوفانها، سیلها یا خشکسالیها، سرعت بالای محاسبات میتواند به معنای نجات جانها و کاهش خسارات باشد.
بینایی کامپیوتر و پردازش تصویر
در حوزه بینایی کامپیوتر، H200 میتواند برای آموزش مدلهای detection، segmentation و classification استفاده شود. برای مثال، یک شرکت خودروسازی که در حال توسعه سیستمهای خودران است، نیاز به آموزش مدلهای بینایی که بتوانند اشیای مختلف در جاده را تشخیص دهند دارد. این مدلها باید بر روی میلیونها تصویر و ویدیو آموزش ببینند، و H200 میتواند این فرآیند را تسریع کند.
در صنعت پزشکی، مدلهای بینایی برای تشخیص بیماریها از روی تصاویر رادیولوژی، MRI یا اسکن CT استفاده میشوند. یک مدل که با H200 آموزش دیده باشد، میتواند به پزشکان کمک کند تا سریعتر و دقیقتر تشخیص بگذارند. برای مثال، تشخیص سرطان در مراحل اولیه میتواند شانس بهبودی را بهطور چشمگیری افزایش دهد.
Generative AI و خلق محتوای خلاقانه
مدلهای generative مانند Stable Diffusion، DALL-E، Midjourney و Runway که برای تولید تصویر، ویدیو و موسیقی استفاده میشوند، نیاز به قدرت محاسباتی زیادی دارند. H200 میتواند این مدلها را با سرعت بالایی اجرا کند و به هنرمندان، طراحان و خالقان محتوا امکان میدهد تا ایدههای خود را سریعتر به واقعیت تبدیل کنند.
یک استودیوی انیمیشن میتواند از H200 برای تولید خودکار بکگراندها، کاراکترها یا حتی صحنههای کامل استفاده کند. این نه تنها زمان تولید را کاهش میدهد، بلکه به هنرمندان اجازه میدهد تا روی جنبههای خلاقانهتر کار خود تمرکز کنند و وظایف تکراری را به AI بسپارند.
در صنعت بازیسازی، H200 میتواند برای تولید بافتها (textures)، مدلهای سهبعدی، گفتار کاراکترها یا حتی طراحی سطوح بازی استفاده شود. این میتواند هزینههای توسعه را کاهش دهد و به استودیوهای کوچکتر اجازه دهد تا بازیهای با کیفیت بالا تولید کنند.
تحلیل قیمت و سرمایهگذاری NVIDIA H200
یکی از مهمترین سوالاتی که شرکتها و محققان هنگام بررسی H200 با آن مواجه میشوند، این است که آیا سرمایهگذاری در این پردازنده ارزش اقتصادی دارد یا نه. بیایید به جنبههای مختلف هزینهها و بازگشت سرمایه نگاهی بیندازیم.
هزینه خرید مستقیم
قیمت دقیق H200 به فرم فاکتور و قرارداد خرید بستگی دارد، اما بر اساس اطلاعات منتشر شده از فروشندگان و ارائهدهندگان خدمات ابری، قیمتها به شرح زیر تخمین زده میشود:
- H200 SXM (تک واحد): $40,000 تا $55,000
- سیستم HGX H200 (8 GPU): $400,000 تا $500,000
- سیستم DGX H200 کامل: $500,000+ (شامل سرور، پردازندهها، حافظه، ذخیرهساز و نرمافزار)
- H200 NVL (دو GPU در یک کارت): $70,000 تا $90,000 (تخمینی)
- H200 PCIe (زمانی که عرضه شود): $30,000 تا $40,000 (تخمینی)
این قیمتها البته در مقایسه با H100 که قیمت آن بین 30,000 تا 40,000 دلار است، 25 تا 40 درصد بالاتر است. با این حال، باید توجه داشت که عملکرد H200 در بسیاری از کارها 45 تا 90 درصد بهتر از H100 است، بنابراین نسبت عملکرد به قیمت (performance per dollar) ممکن است بهتر باشد.
برای شرکتهایی که قصد خرید مستقیم دارند، باید هزینههای جانبی را نیز در نظر بگیرند. یک سیستم DGX H200 نیاز به زیرساخت خنککاری، برق با ظرفیت بالا (حداقل 10 کیلووات برای هر سیستم)، شبکه با پهنای باند بالا و فضای رک دارد. همه اینها به هزینه نهایی اضافه میشوند.
اجاره از خدمات ابری
برای شرکتهایی که نمیخواهند سرمایهگذاری اولیه بالایی انجام دهند یا نیاز به GPU برای مدت محدودی دارند، اجاره از ارائهدهندگان خدمات ابری گزینهای جذاب است. چندین ارائهدهنده از جمله AWS، Azure، Google Cloud، Lambda Labs، CoreWeave و Jarvislabs در حال افزودن H200 به پورتفولیوی خود هستند.
قیمت اجاره H200 بر اساس گزارشهای اولیه به شرح زیر است:
- اجاره on-demand: $1.90 تا $3.80 در ساعت (به ازای هر GPU)
- اجاره reserved (قرارداد بلندمدت): $1.20 تا $2.50 در ساعت
- اجاره spot (قیمت متغیر): $0.80 تا $1.50 در ساعت
برای مقایسه، قیمت اجاره H100 معمولاً بین $2.50 تا $4.00 در ساعت است، بنابراین H200 تقریباً 20-30 درصد گرانتر است. با این حال، با توجه به عملکرد بهتر، ممکن است در نهایت هزینه کمتری پرداخت کنید.
بیایید با یک مثال محاسبه کنیم. فرض کنید میخواهید یک مدل Llama 2 70B را برای 1 میلیون درخواست در ماه اجرا کنید. هر درخواست بهطور متوسط 100 توکن تولید میکند.
با H100:
- سرعت: 21,000 توکن در ثانیه (برای 1 GPU)
- تعداد GPU مورد نیاز: 5 GPU (برای سرویسدهی پایدار با فضای خطا)
- هزینه: 5 GPU × $3.00/ساعت × 730 ساعت/ماه = $10,950/ماه
با H200:
- سرعت: 31,000 توکن در ثانیه (برای 1 GPU)
- تعداد GPU مورد نیاز: 4 GPU (به دلیل سرعت بالاتر)
- هزینه: 4 GPU × $2.50/ساعت × 730 ساعت/ماه = $7,300/ماه
در این سناریو، با وجود اینکه قیمت ساعتی H200 کمی بیشتر است، به دلیل عملکرد بهتر، هزینه کلی 33 درصد کمتر میشود!
محاسبه TCO (Total Cost of Ownership)
برای خریداران مستقیم، محاسبه TCO که شامل تمام هزینههای مالکیت در طول عمر محصول است، بسیار مهم است. TCO شامل موارد زیر است:
- هزینه خرید اولیه: $500,000 برای یک DGX H200
- هزینه برق: با مصرف 10 کیلووات و قیمت متوسط برق $0.15 در کیلوواتساعت، حدود $13,000 در سال
- هزینه خنکسازی: حدود 30-50% هزینه برق، یعنی $4,000-$6,500 در سال
- هزینه نگهداری: 5-10% از قیمت خرید در سال، یعنی $25,000-$50,000 در سال
- هزینه فضا و رک: متغیر بسته به موقعیت مرکز داده
- هزینه شبکه: برای زیرساخت با پهنای باند بالا
در مجموع، TCO یک سیستم DGX H200 در 3 سال میتواند بین $700,000 تا $850,000 باشد. اگر این عدد را با اجاره ابری مقایسه کنیم (فرض کنیم استفاده 24/7):
هزینه اجاره ابری:
- 8 GPU × $2.50/ساعت × 8,760 ساعت/سال × 3 سال = $525,000
در این سناریو، اجاره ابری ارزانتر به نظر میرسد. اما اگر به سختافزار برای بیش از 3 سال نیاز داشته باشید یا بتوانید پس از 3 سال آن را با قیمت خوبی بفروشید، خرید مستقیم میتواند مقرونبهصرفهتر باشد.
همچنین باید توجه داشت که برای شرکتهایی که به حفظ حریم خصوصی دادهها اهمیت میدهند یا در صنایعی مانند دفاعی، بانکداری یا بهداشت فعالیت میکنند که مقررات سختگیرانهای دارند، داشتن زیرساخت on-premises ممکن است الزامی باشد، صرف نظر از هزینه.
بازگشت سرمایه (ROI)
بازگشت سرمایه به نوع کاربرد شما بستگی دارد. برای یک شرکت تحقیقاتی که H200 را برای آموزش مدلها استفاده میکند، ROI ممکن است به شکل زمان صرفهجویی شده باشد. اگر H200 بتواند زمان آموزش را از 2 ماه به 1 ماه کاهش دهد، این یعنی محققان میتوانند دو برابر سریعتر نتیجه بگیرند و محصول خود را زودتر به بازار عرضه کنند. در صنعت AI که رقابت شدید است، این یک ماه میتواند تفاوت بین موفقیت و شکست باشد.
برای یک ارائهدهنده سرویس API که H200 را برای استنتاج استفاده میکند، ROI بهطور مستقیم در هزینه عملیاتی کمتر و امکان سرویسدهی به کاربران بیشتر نمایان میشود. اگر با همان تعداد GPU بتوانید 45 درصد درخواست بیشتری را پاسخ دهید، این یعنی درآمد بیشتر یا هزینه کمتر.
سوالات متداول (FAQ)
1. تفاوت اصلی H200 و H100 چیست؟
تفاوت اصلی در حافظه است. H200 دارای 141 گیگابایت حافظه HBM3e با پهنای باند 4.8 ترابایت بر ثانیه است، در حالی که H100 دارای 80 گیگابایت HBM3 با پهنای باند 3.35 ترابایت بر ثانیه است. این یعنی H200 حافظه 76 درصد بیشتر و پهنای باند 43 درصد بالاتر دارد. در نتیجه، در کارهای آموزش مدلهای بزرگ تا 90 درصد و در استنتاج تا 45 درصد سریعتر عمل میکند.
2. NVIDIA H200 برای چه کاربردهایی مناسب است؟
H200 برای طیف وسیعی از کاربردها مناسب است، از جمله:
- آموزش و fine-tuning مدلهای زبانی بزرگ (LLM)
- استنتاج سریع برای سرویسهای تولیدی AI
- محاسبات علمی HPC (دینامیک سیالات، مدلسازی مولکولی)
- بینایی کامپیوتر و پردازش تصویر
- تولید محتوای generative (تصویر، ویدیو، موسیقی)
- تحلیل دادههای بزرگ و یادگیری ماشین
3. قیمت NVIDIA H200 چقدر است؟
قیمت H200 بسته به فرم فاکتور و نحوه خرید متفاوت است:
- H200 SXM (تک واحد): $40,000-$55,000
- سیستم DGX H200 (8 GPU): $500,000+
- اجاره ابری: $1.90-$3.80 در ساعت به ازای هر GPU قیمتهای دقیق به شرایط بازار، حجم خرید و مذاکره با فروشنده بستگی دارد.
4. NVIDIA H200 چه زمانی در دسترس است؟
H200 از سهماهه دوم 2024 شروع به عرضه شده است. فرم فاکتور SXM در حال حاضر در سیستمهای HGX و DGX موجود است. H200 NVL در سهماهه سوم 2024 عرضه شد. فرم فاکتور PCIe انتظار میرود در اواخر 2024 یا اوایل 2025 منتشر شود. در حال حاضر، چندین ارائهدهنده خدمات ابری از جمله AWS، Azure، Lambda Labs و CoreWeave H200 را ارائه میدهند.
5. آیا H200 با نرمافزارهای موجود سازگار است؟
بله، H200 با تمام کتابخانهها و فریمورکهای AI که از CUDA پشتیبانی میکنند، سازگار است. این شامل PyTorch، TensorFlow، JAX، Triton، Hugging Face Transformers، LangChain و صدها کتابخانه دیگر میشود. همچنین NVIDIA سیستمعاملهای لینوکس مختلف، VMware vSphere و Kubernetes را پشتیبانی میکند. بهروزرسانی driver های CUDA برای بهرهبرداری کامل از قابلیتهای H200 توصیه میشود.
6. NVIDIA H200 نیاز به سیستم خنککاری مایع دارد؟
بستگی به فرم فاکتور دارد. H200 SXM با TDP 700 وات معمولاً به خنککاری مایع نیاز دارد، بهویژه در کانفیگوراسیونهای 8-GPU که 5.6 کیلووات حرارت تولید میکنند. H200 NVL با TDP پایینتر (600 وات برای دو GPU) از خنککاری هوایی پشتیبانی میکند و میتوان آن را در سرورهای استاندارد با سیستمهای خنککاری موجود استفاده کرد. H200 PCIe نیز احتمالاً از خنککاری هوایی پشتیبانی خواهد کرد.
7. چند GPU NVIDIA H200 میتوان با هم استفاده کرد؟
در سیستمهای HGX، میتوان تا 8 GPU H200 را از طریق NVLink نسل چهارم با یکدیگر متصل کرد که در مجموع 1.1 ترابایت حافظه فراهم میکند. برای کارهای بسیار بزرگ، میتوان چندین سیستم HGX را از طریق شبکه InfiniBand یا RoCE به یکدیگر متصل کرد و صدها یا هزاران GPU را با هم ترکیب کرد. در فرم فاکتور NVL، دو GPU با NVLink متصل هستند، اما میتوان چندین کارت NVL را در یک سرور نصب کرد.
8. آیا میتوان H100 را به NVIDIA H200 ارتقا داد؟
خیر، ارتقای مستقیم امکانپذیر نیست. H200 و H100 ماژولهای فیزیکی جداگانه هستند و نمیتوان GPU های موجود را با تعویض قطعات به H200 تبدیل کرد. با این حال، در سیستمهای HGX که از پردازندههای SXM استفاده میکنند، ممکن است بتوان کل ماژول GPU را تعویض کرد، اما این کار نیاز به پشتیبانی سازنده سیستم و احتمالاً بهروزرسانی firmware و BIOS دارد.
9. مصرف برق NVIDIA H200چقدر است؟
TDP H200 SXM 700 وات است. یک سیستم کامل DGX H200 با 8 GPU، پردازندههای CPU، حافظه و دیگر قطعات، حدود 10.2 کیلووات برق مصرف میکند. H200 NVL با TDP 600 وات (برای هر دو GPU) کمتر مصرف میکند. باید توجه داشت که مصرف واقعی به نوع کاربار بستگی دارد و همیشه به TDP کامل نمیرسد.
10. چگونه میتوانم به NVIDIA H200 دسترسی پیدا کنم؟
سه راه اصلی برای دسترسی به H200 وجود دارد:
-
خرید مستقیم: از طریق شرکای رسمی NVIDIA مانند Dell, HPE, Lenovo, Supermicro یا مستقیماً از NVIDIA (برای سیستمهای DGX). نیاز به سرمایهگذاری اولیه بالا و زیرساخت مناسب دارد.
-
اجاره ابری: از ارائهدهندگان خدمات ابری مانند AWS, Azure, Google Cloud, Lambda Labs, CoreWeave, Jarvislabs. میتوانید بر اساس استفاده، بهصورت ساعتی هزینه بپردازید.
-
کولوکیشن (Colocation): خرید سختافزار و نصب آن در مراکز داده شخص ثالث که زیرساخت برق و خنککاری را فراهم میکنند.
برای محققان و دانشگاهها، NVIDIA برنامههای تحقیقاتی و آموزشی دارد که ممکن است دسترسی با تخفیف یا رایگان به H200 را فراهم کند.
نتیجهگیری
NVIDIA H200 Tensor Core GPU بدون شک یکی از قدرتمندترین پردازندههای موجود برای هوش مصنوعی و محاسبات علمی در سال 2024 است. با 141 گیگابایت حافظه HBM3e، پهنای باند 4.8 ترابایت بر ثانیه و معماری Hopper بهینهشده، این پردازنده مرزهای امکان در آموزش مدلهای عظیم AI و استنتاج سریع آنها را جابهجا کرده است.
آنچه H200 را متمایز میکند، فقط اعداد خشک مشخصات فنی نیست، بلکه تأثیر واقعی آن بر کارهای روزمره محققان، توسعهدهندگان و شرکتهایی است که با AI کار میکنند. با H200، مدلهایی که قبلاً روزها یا هفتهها برای آموزش نیاز داشتند، اکنون در کسری از زمان آماده میشوند. سرویسهای AI که قبلاً به دهها GPU نیاز داشتند، اکنون میتوانند با تعداد کمتری به همان تعداد کاربر خدمت بدهند. محققان علمی میتوانند شبیهسازیهای پیچیدهتری را انجام دهند و به نتایج دقیقتری برسند.
البته H200 یک سرمایهگذاری قابلتوجه است، چه بهصورت خرید مستقیم و چه اجاره از خدمات ابری. اما برای سازمانهایی که به دنبال حداکثر عملکرد در کارهای AI سنگین هستند، این سرمایهگذاری میتواند بازگشت قابلملاحظهای داشته باشد، چه به شکل کاهش هزینههای عملیاتی، چه به شکل سرعت بیشتر در تحقیق و توسعه، و چه به شکل قابلیت ارائه محصولات و خدمات بهتر به مشتریان.
با توجه به روند صعودی AI و نیاز فزاینده به پردازش مدلهای بزرگتر و پیچیدهتر، H200 بهعنوان یکی از بنیادهای زیرساخت AI نسل آینده جایگاه خود را تثبیت کرده است. چه یک محقق دانشگاهی باشید که روی یک پروژه علمی کار میکنید، چه یک استارتاپ AI که در حال ساخت نسل بعدی از سرویسهای هوشمند است، و چه یک شرکت بزرگ که میخواهد با AI تحول دیجیتال ایجاد کند، H200 ابزاری است که میتواند به شما کمک کند تا از رقبا جلوتر بمانید و به اهداف خود سریعتر برسید.
در نهایت، NVIDIA با H200 نشان داده که هنوز هم پیشتاز صنعت پردازندههای AI است و با بهرهگیری از جدیدترین فناوریها، میتواند محصولاتی تولید کند که نه فقط از لحاظ فنی پیشرفته هستند، بلکه تأثیر واقعی و ملموسی بر پیشرفت هوش مصنوعی و علم در سراسر جهان دارند. H200 نه پایان، بلکه آغاز فصل جدیدی در تکامل محاسبات AI است.
محصولات مرتبط

نقد و بررسیها
پاککردن فیلترهاهنوز بررسیای ثبت نشده است.