


توضیحات
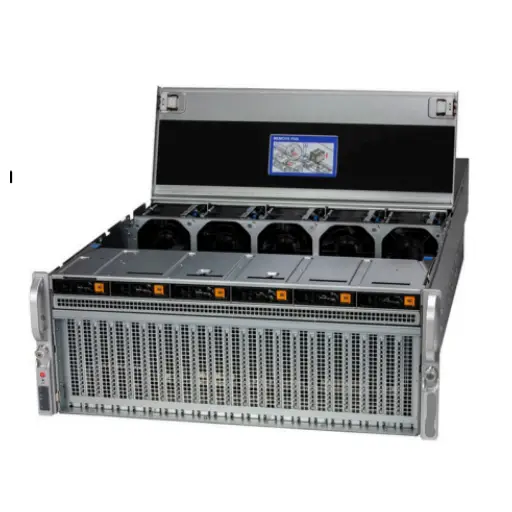
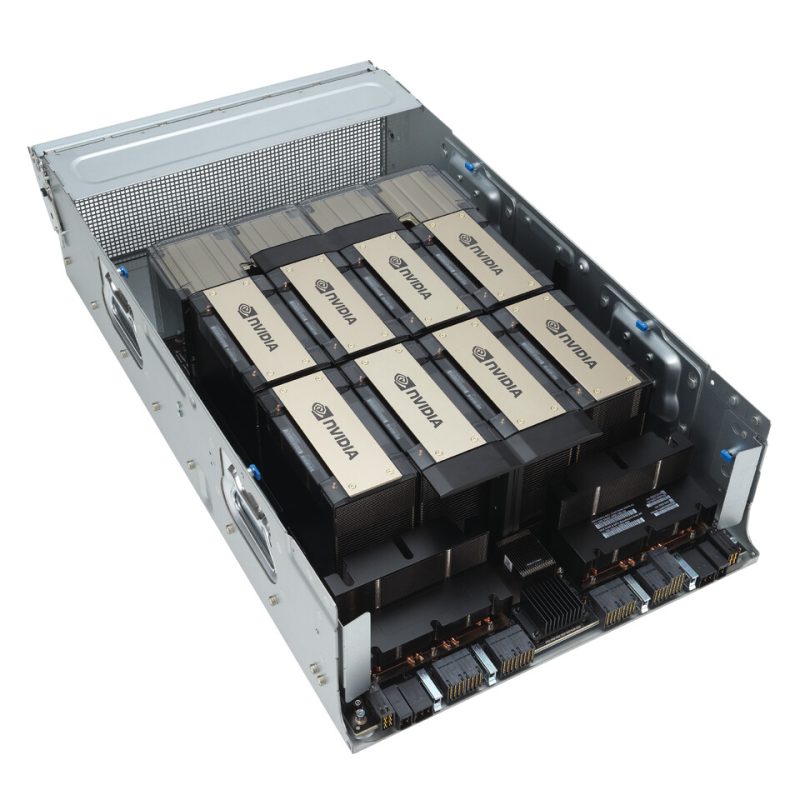
در دنیای پرسرعت هوش مصنوعی و علوم دادهمحور، انتخاب زیرساخت مناسب میتواند مرز بین پیشرفت تدریجی و نوآوریهای بزرگ را تعیین کند. سرور HGX H100 8-GPU یک راهحل کامل و آماده برای ابررایانش است که برای غلبه بر چالشهای مقیاس اگزابایت (Exascale) در حوزههای هوش مصنوعی مولد، یادگیری عمیق و محاسبات با عملکرد بالا (HPC) طراحی شده است. این سیستم بر پایه شاسی قدرتمند Supermicro SYS-821GE-TNHR ساخته شده و ترکیبی هماهنگ از قطعات پیشرفته است که قدرت محاسباتی، پهنای باند حافظه و توان عملیاتی ورودی/خروجی بینظیری را برای پروژههای بلندپروازانه شما فراهم میکند.
این سرور برای موسسات تحقیقاتی هوش مصنوعی، مراکز داده بزرگ و شرکتهای نوآور طراحی شده و یک پشته نرمافزاری و سختافزاری کاملاً یکپارچه و معتبر را برای آموزش، تنظیم دقیق و پیادهسازی مدلهای زبان بسیار بزرگ (vLLM)، شبکههای عصبی پیچیده و شبیهسازیهای علمی پیشرفته ارائه میدهد. این فقط یک سختافزار نیست؛ این موتور محرک نوآوری بعدی شماست.
نگاهی کلی: ویژگیهای کلیدی و مزایای استراتژیک
- شتابدهی بینظیر هوش مصنوعی: هسته اصلی آن پلتفرم NVIDIA HGX H100 با ۸ پردازنده گرافیکی است که تا ۳۲ پتافلاپس (PetaFLOPS) عملکرد در FP8 Tensor Core ارائه میدهد و برای آموزش مدلهای عظیم ایدهآل است.
- طراحی با چگالی بالا: شاسی رکمونت 8U که ۸ پردازنده گرافیکی، دو پردازنده مرکزی و فضای ذخیرهسازی گسترده را بدون کاهش کارایی حرارتی در خود جای میدهد.
- مقیاسپذیری یکپارچه: ادغام کامل NVLink/NVSwitch برای ایجاد فضای حافظه یکپارچه و پهنای باند بالا، که امکان ساخت خوشههای چند گرهی برای محاسبات در مقیاس اگزابایت را فراهم میکند.
- قابلیت اطمینان سازمانی: سازگار با RoHS، با منبع تغذیه پشتیبان، خنککننده پیشرفته و ویژگیهای امنیتی مانند TPM 2.0 برای عملکرد ۲۴ ساعته بدون وقفه.
- بهینهسازی مقرونبهصرفه: پشتیبانی از خنککننده هوایی یا مایع که مصرف انرژی را تا ۴۰ درصد نسبت به سیستمهای قدیمی کاهش میدهد.
جدول مشخصات فنی کامل HGX H100 8-GPU
این جدول نمایی دقیق از اجزای اصلی سرور و مزایای استراتژیک آنها برای متخصصان فنی و مدیران IT ارائه میدهد.
| بخش | مشخصات | مزیت کلیدی برای هوش مصنوعی و HPC |
|---|---|---|
| شاسی | رکمونت 8U، سازگار با RoHS (مدل Supermicro SYS-821GE-TNHR) | طراحی با چگالی بالا و مدیریت حرارتی بهینه برای حفظ عملکرد پایدار در مراکز داده. |
| پردازندههای مرکزی (CPU) | ۲x Intel® Xeon® Platinum 8592+ (مجموعاً ۱۲۸ هسته / ۲۵۶ رشته) | موازیسازی فوقالعاده برای مدیریت پایپلاینهای پیچیده داده و پشتیبانی از پردازندههای گرافیکی. |
| پلتفرم پردازنده گرافیکی | NVIDIA HGX H100 8-GPU (SXM5) با NVLink/NVSwitch | فضای حافظه یکپارچه ۶۴۰ گیگابایت HBM3 برای آموزش مدلهای موازی عظیم. |
| حافظه سیستم (RAM) | ۱ ترابایت DDR5-5600 ECC RDIMM (۱۶x ۶۴ گیگابایت) | ظرفیت در مقیاس ترابایت با کد تصحیح خطا برای کار بدون خطا با دادههای حجیم. |
| زیرسیستم ذخیرهسازی | ۳۰.۷۲ ترابایت NVMe PCIe 4.0 کلاس سازمانی (۸x ۳.۸۴ ترابایت، ۱ DWPD) | حذف گلوگاههای ورودی/خروجی با تأخیر کم برای بارگذاری سریع مجموعه دادهها. |
| شبکه | ۲x کارت شبکه دو پورتی ۲۵GbE SFP28؛ پشتیبانی از ۴۰۰GbE InfiniBand | پهنای باند بالا برای انتقال داده و اتصال به خوشههای چند گرهی. |
| امنیت | ماژول سختافزاری TPM 2.0 (AOM-TPM-9670V-P) | ریشه اعتماد سختافزاری برای بوت امن، رمزنگاری و حفاظت از دادهها. |
| حفاظت از دادهها | Intel® VROC Premium (پشتیبانی از RAID 0, 1, 5, 10) | RAID نرمافزاری کلاس سازمانی برای آرایههای NVMe، تضمینکننده یکپارچگی دادهها. |
| توان و خنککننده | منبع تغذیه پشتیبان (تا ۲۴ کیلووات)؛ خنککننده هوایی با گزینه مایع | مدیریت کارآمد انرژی برای عملیات ۲۴ ساعته در محیطهای با چگالی بالا. |
| گارانتی | ۳ سال قطعات، ۳ سال خدمات، ۱ سال تعویض سریع | پوشش جامع برای قابلیت اطمینان سازمانی و حداقل زمان توقف. |
بررسی عمیق معماری: مزایا و جزئیات اجزا HGX H100 8-GPU
۱. ستون فقرات محاسباتی: پردازندههای دوگانه Intel® Xeon® Platinum 8592+
در حالی که پردازندههای گرافیکی نقش اصلی در پردازش موازی را بر عهده دارند، پردازندههای مرکزی مانند سیستم عصبی هوشمند عمل میکنند و پایپلاینهای داده، منابع سیستم و وظایف پیچیده سریالی را مدیریت میکنند. این سرور به یک پیکربندی دو پردازندهای قدرتمند مجهز است که گلوگاههای سیستم را از بین برده و کل جریان داده را به طور مؤثر هماهنگ میکند.
- مدل: ۲x Intel® Xeon® Platinum 8592+
- تعداد کل هستهها: مجموعاً ۱۲۸ هسته فیزیکی و ۲۵۶ رشته، موازیسازی فوقالعادهای را برای مدیریت پیشپردازش مجموعه دادههای عظیم، ترافیک شبکه، ورودی/خروجی ذخیرهسازی و وظایف سیستمعامل فراهم میکند تا پردازندههای گرافیکی هرگز در انتظار داده نمانند.
- حافظه کش عظیم: با مجموع ۶۴۰ مگابایت حافظه کش L3، این پردازندهها تأخیر دسترسی به حافظه را به شدت کاهش داده و خطوط اجرایی را برای حداکثر کارایی، اشباع نگه میدارند.

۲. پارادایم جدید حافظه: ۱ ترابایت رم DDR5-5600 ECC
مقیاس مدلهای هوش مصنوعی امروزی نیازمند زیرسیستمی از حافظه است که هم وسیع و هم فوقالعاده سریع باشد. پیکربندی حافظه این سرور برای مدیریت سنگینترین بارهای کاری طراحی شده است.
- ظرفیت در مقیاس ترابایت: ۱ ترابایت حافظه رم کلی، امکان بارگذاری، پردازش و کش کردن مجموعه دادههای عظیم را مستقیماً در حافظه فراهم میکند. این ویژگی برای کاربردهایی در ژنومیک، مدلسازی مالی و مراحل پیشآموزش مدلهای زبان بزرگ حیاتی است.
- سرعت سرسامآور: با استفاده از ۱۶ ماژول حافظه DDR5-5600، سیستم پهنای باندی فوقالعاده را برای تغذیه ۱۲۸ هسته پردازنده فراهم میکند و تضمین میکند که دادهها به صورت روان بین پردازندهها، ذخیرهساز و زیرسیستم GPU جابجا شوند.
- قابلیت اطمینان بیچونوچرا: پشتیبانی از ECC (کد تصحیح خطا) در یک سرور هوش مصنوعی سازمانی غیرقابل چشمپوشی است. این فناوری به طور خودکار خطاهای تکبیتی حافظه را در لحظه شناسایی و تصحیح میکند و از تخریب دادههای خاموش (Silent Data Corruption) که میتواند محاسبات چند روزه را بیاعتبار کند، جلوگیری کرده و یکپارچگی نتایج شما را تضمین میکند.
۳. ابر موتور هوش مصنوعی: پلتفرم ۸ مسیره HGX H100 8-GPU
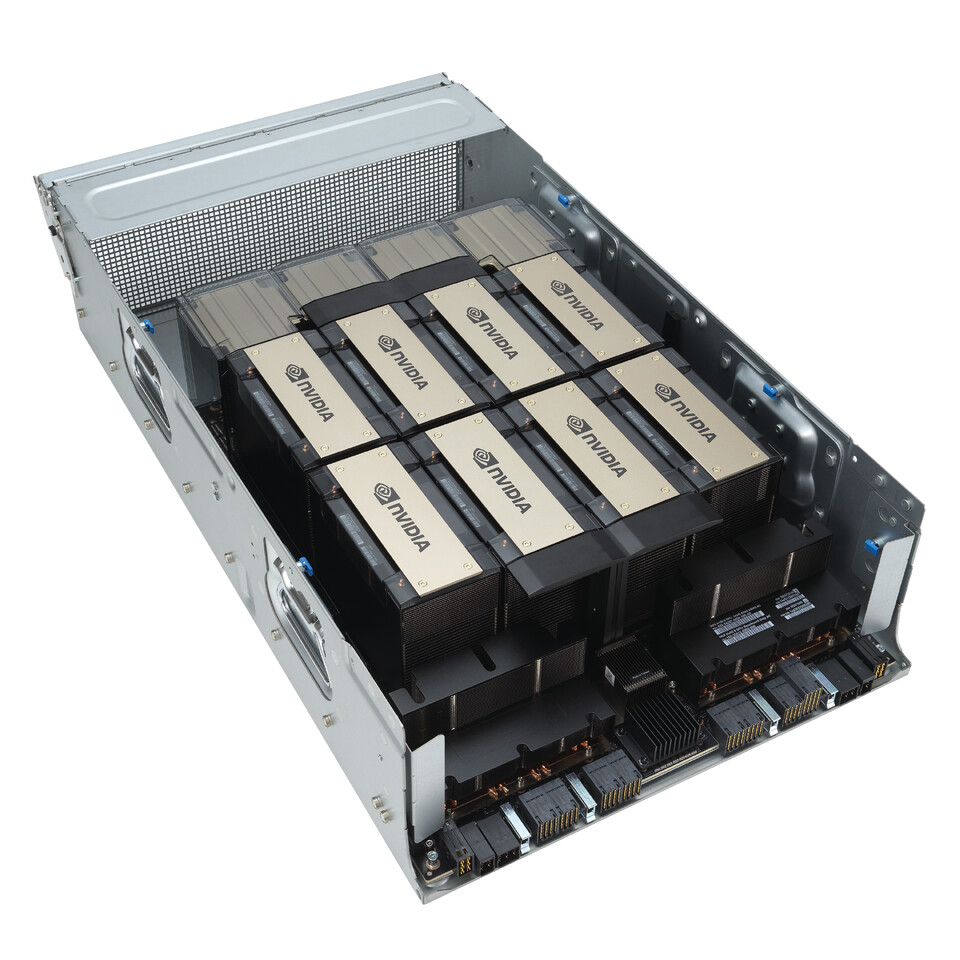
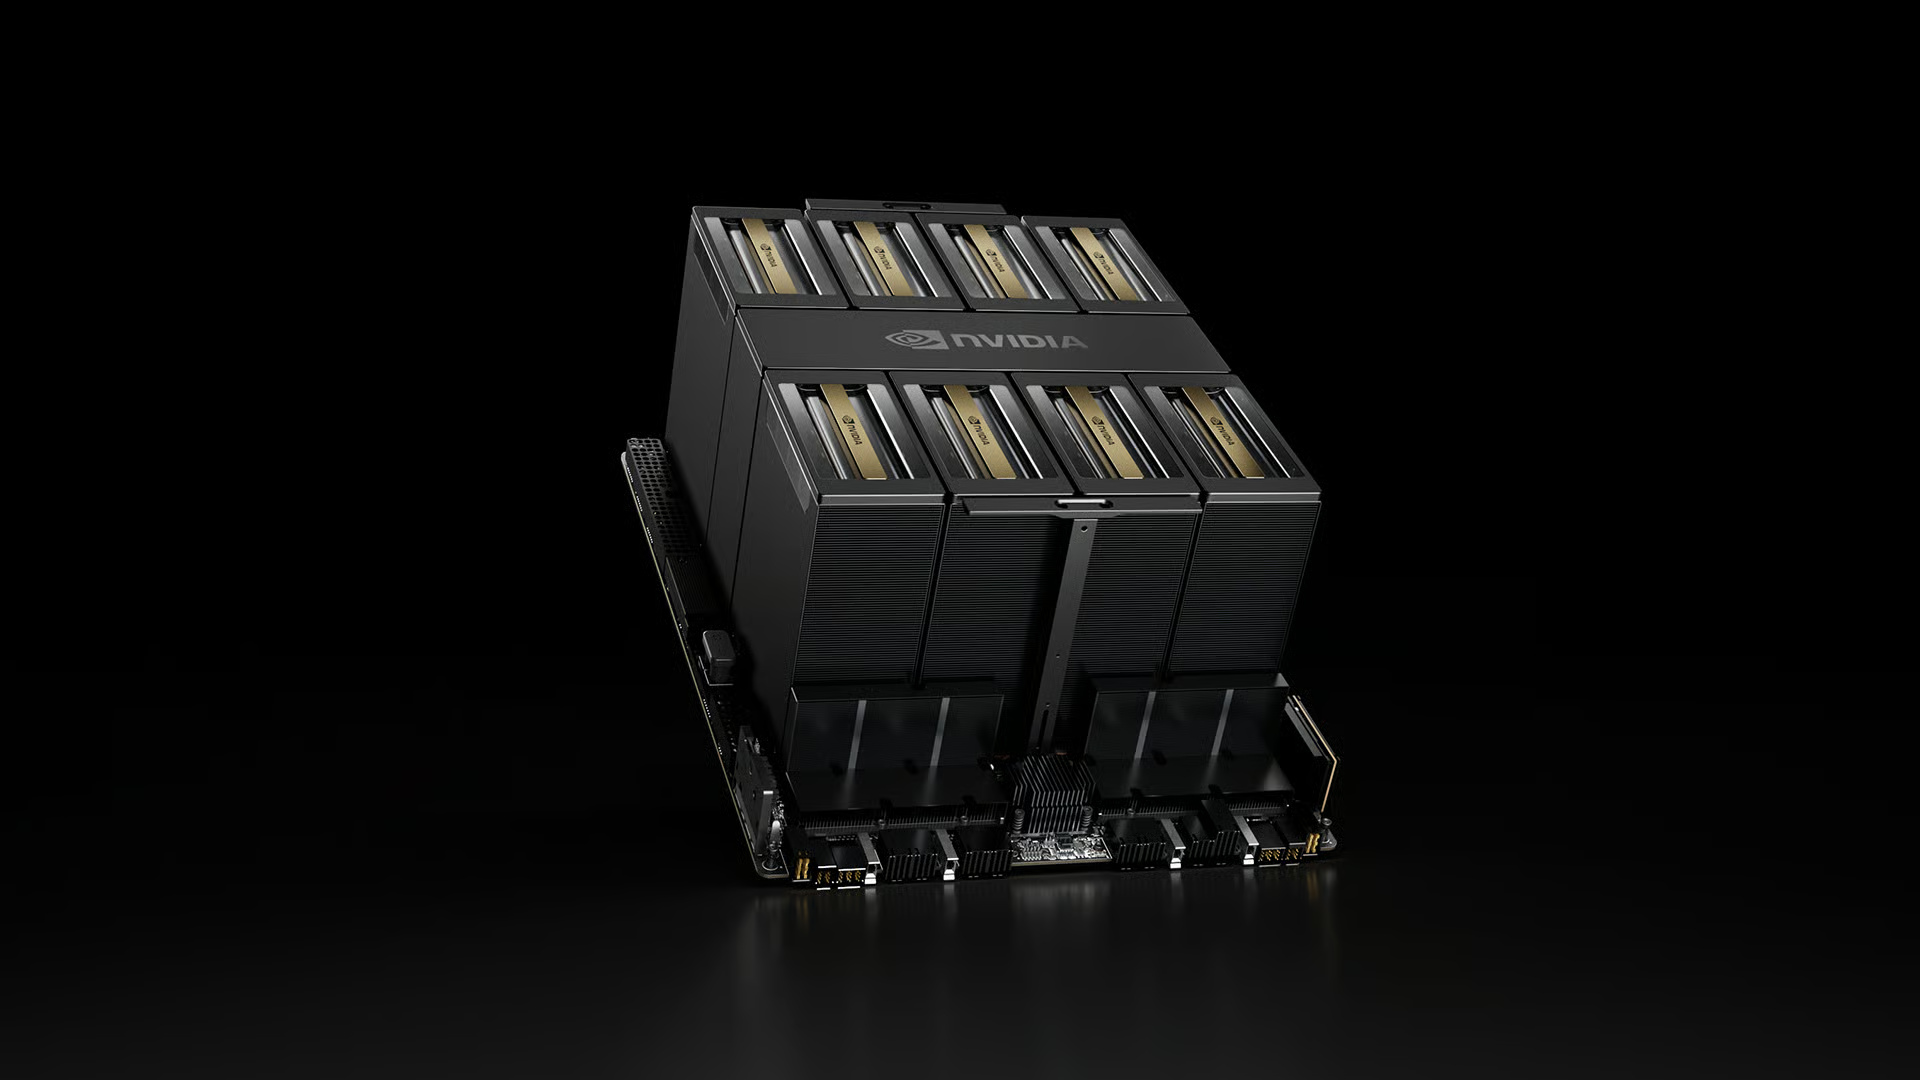
این بخش، هسته اصلی عملکرد انقلابی سرور است. سیستم بر روی برد پایه NVIDIA HGX™ H100 8-GPU ساخته شده است که به عنوان یک ابرکامپیوتر هوش مصنوعی یکپارچه و عظیم عمل میکند.
- مدل GPU: هشت عدد پردازنده گرافیکی NVIDIA H100 SXM5 Tensor Core، هر کدام با ۸۰ گیگابایت حافظه HBM3 (مجموع ۶۴۰ گیگابایت حافظه سیستم VRAM) و ۳.۳۵ ترابایت بر ثانیه پهنای باند برای هر GPU (مجموع ۲۶.۸ ترابایت بر ثانیه).
- اتصال یکپارچه: این هشت GPU با پهنای باند ۹۰۰ گیگابایت بر ثانیه برای ارتباط مستقیم GPU-به-GPU از طریق نسل چهارم NVLink و نسل سوم NVSwitch به یکدیگر متصل شدهاند. این طراحی انقلابی به هشت پردازنده گرافیکی اجازه میدهد تا به عنوان یک شتابدهنده واحد و عظیم عمل کنند و آموزش مدلهای غولپیکر را بدون کاهش عملکرد ناشی از عبور از گذرگاه PCIe ممکن میسازد.
- بهینهسازی کامل پشته هوش مصنوعی: این پلتفرم به طور کامل برای نرمافزارهای پیشرو هوش مصنوعی مانند NVIDIA AI Enterprise، CUDA، Magnum IO و Doca اعتبار سنجی شده است. این ویژگی به دانشمندان داده اجازه میدهد تا با حداقل تنظیمات به عملکرد حداکثری دست یابند.
مزیت H100: جهش نسلی در عملکرد
اگرچه H100 یک غول اثباتشده است، مقایسه آن با جانشین (H200) و پیشینیان (A100) نقاط قوت آن را در وظایف محاسباتی فشرده برجسته میکند.
| ویژگی | NVIDIA® H100 SXM5 | NVIDIA® H200 SXM5 | NVIDIA® A100 SXM4 |
|---|---|---|---|
| حافظه GPU | ۸۰ گیگابایت HBM3 | ۱۴۱ گیگابایت HBM3e | ۸۰ گیگابایت HBM2e |
| پهنای باند حافظه GPU | ۳.۳۵ ترابایت بر ثانیه | ۴.۸ ترابایت بر ثانیه | ۲.۰ ترابایت بر ثانیه |
| معماری | NVIDIA® Hopper™ | NVIDIA® Hopper™ | NVIDIA® Ampere™ |
| عملکرد استنتاج LLM | پایه | تا ۱.۹ برابر سریعتر روی مدلهایی مانند Llama 2 70B | تا ۰.۵ برابر کندتر از H100 |
| مزیت کلیدی | عملکرد همهجانبه اثباتشده: مناسب برای طیف وسیعی از بارهای کاری هوش مصنوعی. | برتری در بارهای وابسته به حافظه: ایدهآل برای vLLM با پنجره زمینه طولانی. | گزینه مقرونبهصرفه قدیمی: مناسب برای وظایف کمتر پیچیده اما در پهنای باند ضعیفتر است. |
۴. ذخیرهسازی و شبکه با توان عملیاتی بالا
یک سرور هوش مصنوعی تنها به اندازه کندترین قطعه خود سرعت دارد. زیرسیستمهای ذخیرهسازی و شبکه این سیستم برای حفظ عملکرد حداکثری موتورهای محاسباتی مهندسی شدهاند.
- ذخیرهسازی فوق سریع NVMe: با ۳۰.۷۲ ترابایت حافظه NVMe PCIe 4.0 کلاس سازمانی، این سرور دسترسی به داده با تأخیر کم و توان عملیاتی بالا را برای بارگذاری سریع مجموعه دادهها و ذخیرهسازی مکرر نقاط بازرسی مدل فراهم میکند. این درایوها با نرخ 1 DWPD، برای تحمل چرخههای نوشتن سنگین و مداوم که در فرآیند آموزش هوش مصنوعی رایج است، طراحی شدهاند.
- شبکه مقیاسپذیر: دو کارت شبکه ۲۵GbE SFP28 پهنای باند کافی برای انتقال داده و مدیریت سیستم را فراهم میکنند. مهمتر از آن، این سیستم برای اتصال به ابرخوشهها (Super Cluster) معماری شده و آماده ادغام با زیرساختهای شبکه با کارایی بالا مانند NVIDIA® Quantum-2 InfiniBand برای ساخت محیطهای آموزش توزیعشده چند گرهی است.
کاربردهای ایدهآل HGX H100 8-GPU
این سرور برای محیطهایی که به حداکثر چگالی محاسباتی و کارایی نیاز دارند، انتخابی عالی است. کاربردهای کلیدی آن عبارتند از:
- آموزش و استنتاج هوش مصنوعی: ایدهآل برای آموزش مدلهای زبان بسیار بزرگ (vLLM) و اجرای استنتاج با توان عملیاتی بالا روی مدلهایی مانند GPT یا Llama.
- سیستمهای پیشنهاددهنده یادگیری عمیق: مدیریت مجموعه دادههای عظیم برای پیشنهادهای شخصیسازیشده در تجارت الکترونیک یا پلتفرمهای محتوایی.
- بینایی کامپیوتر و پردازش تصویر: شتابدهی به وظایفی مانند تشخیص اشیا، تحلیل ویدیو و تصویربرداری پزشکی.
- محاسبات با عملکرد بالا (HPC): مناسب برای شبیهسازیها در ژنومیک، مدلسازی آب و هوا و دینامیک سیالات محاسباتی.
- هوش مصنوعی مولد: قدرتدهی به کاربردهای خلاقانه مانند تولید تصویر از متن و پردازش زبان طبیعی.
پرسش و پاسخ متداول (FAQ)
۱. این سرور برای چه نوع بارهای کاری مناسب است؟ این سرور برای آموزش و تنظیم دقیق مدلهای زبان بسیار بزرگ (vLLM)، مدلهای پیشنهاددهنده یادگیری عمیق، سیستمهای بینایی کامپیوتر و شبیهسازیهای علمی بزرگ (HPC) در زمینههایی مانند کشف دارو، مدلسازی آب و هوا و دینامیک سیالات محاسباتی ایدهآل است.
۲. آیا قطعات در آینده قابل ارتقا هستند؟ این سیستم با یک معماری متوازن طراحی شده است. در حالی که اجزای اصلی مانند برد پایه HGX یکپارچه هستند، حافظه سیستم (RAM) و درایوهای ذخیرهسازی NVMe را میتوان به راحتی گسترش داد یا ارتقا داد تا نیازهای آینده را پاسخگو باشد.
۳. چه نرمافزارها و سیستمعاملهایی پشتیبانی میشوند؟ این سرور از تمام توزیعهای اصلی لینوکس سازمانی (مانند Ubuntu, RHEL) پشتیبانی کرده و با مجموعه نرمافزاری NVIDIA AI Enterprise، CUDA Toolkit و پلتفرمهای کانتینرسازی مانند Docker و Singularity کاملاً سازگار است و یکپارچگی روان آن را در پایپلاینهای MLOps موجود تضمین میکند.
۴. چرا پیکربندی ۸ پردازندهای با NVSwitch اهمیت دارد؟ پیکربندی ۸ پردازندهای با NVSwitch یک استخر حافظه یکپارچه و با پهنای باند بالا ایجاد میکند. این به توسعهدهندگان اجازه میدهد تا با هشت GPU به عنوان یک شتابدهنده واحد و قدرتمند رفتار کنند، که فرآیند آموزش مدلهای بسیار بزرگ را به شدت ساده کرده و مقیاسپذیری عملکرد را تضمین میکند.
۵. این سرور در مقایسه با پلتفرم آینده NVIDIA Blackwell B200 چگونه است؟ H100 یک غول اثباتشده در معماری Hopper است که تعادل عالی بین محاسبه و حافظه برای بارهای کاری امروزی ارائه میدهد. پلتفرم آینده Blackwell جهش بعدی را در عملکرد محاسباتی خام (TFLOPS) وعده میدهد. H100 راهحل ایدهآل و آماده پیادهسازی برای حل چالشهای وابسته به حافظه امروز است، در حالی که Blackwell افق بعدی در محاسبات هوش مصنوعی را نمایندگی میکند.
۶. نیازمندیهای توان و خنککننده این سرور چیست؟ به عنوان یک پلتفرم محاسباتی با چگالی بالا، این سرور 8U میتواند زیر بار کامل بیش از ۱۰ کیلووات توان مصرف کند و برای مراکز داده سازمانی با واحدهای توزیع برق (PDU) با ظرفیت بالا و راهحلهای خنککننده پیشرفته (هوایی یا مایع) مناسب است. برای نیازهای دقیق زیرساخت، با یک متخصص مرکز داده مشورت کنید.
محصولات مرتبط

نقد و بررسیها
پاککردن فیلترهاهنوز بررسیای ثبت نشده است.