
مقالات و اخبار تکنولوژی
NVIDIA DGX B200: آغاز عصر معماری Blackwell در محاسبات هوش مصنوعی


- نویسنده: تیم فنی زیرساخت
- بازبینی فنی: تیم تحقیق و توسعه (R&D)
- آخرین بهروزرسانی: 14 دی 1404
- زمان مطالعه: حدود ۲۵ دقیقه
- منابع و مراجع:
- مستندات رسمی معماری NVIDIA Blackwell و وایتپیپرهای فنی
- نتایج بنچمارکهای MLPerf v5.0 و v5.1
- دادههای فنی و تحلیل هزینه مالکیت (TCO) مبتنی بر گزارشهای بازار سرورهای هوش مصنوعی
«پاسخ سریع» (Quick Answer) : NVIDIA DGX B200 چیست و چه ارزشی دارد؟
سیستم NVIDIA DGX B200 با معماری انقلابی Blackwell، قدرتمندترین پلتفرم محاسباتی فعلی برای هوش مصنوعی است که با ۲۰۸ میلیارد ترانزیستور و طراحی دو تراشهای (Dual-die)، جهشی عظیم نسبت به نسل Hopper ایجاد کرده است. این سیستم با ارائه ۷۲ پتافلاپس توان آموزشی و ۱۴۴ پتافلاپس توان استنتاج (در دقت FP4)، گلوگاههای حافظه را با ۱۴۴۰ گیگابایت حافظه HBM3e و پهنای باند ۶۴ ترابایت بر ثانیه رفع کرده است. هدف اصلی این سیستم، کاهش چشمگیر زمان آموزش مدلهای تریلیون پارامتری و اقتصادی کردن استنتاج مدلهای زبانی بزرگ (LLM) در مقیاس تجاری است.
نکات کلیدی برای تصمیمگیری: خرید B200 برای سازمانهایی توجیهپذیر است که با مقیاسهای کلان سروکار دارند؛ جایی که کاهش زمان آموزش از ماهها به هفتهها، میلیونها دلار ارزش خلق میکند. با اینکه قیمت اولیه آن (حدود ۵۱۵ هزار دلار) ۳۵٪ گرانتر از H200 است، اما به دلیل کارایی انرژی بالاتر و کاهش نیاز به تعداد سرور (تراکم بالا)، هزینه مالکیت (TCO) پنجساله را تا ۸۷٪ کاهش میدهد. توجه داشته باشید که مهاجرت به این سیستم نیازمند زیرساخت خنکسازی مایع (Direct Liquid Cooling) است و برای دیتاسنترهای سنتی صرفاً هوایی، بدون ارتقای زیرساخت قابل استفاده نیست.
مقدمه: جهشی تاریخی در قدرت محاسباتی
صنعت هوش مصنوعی در سالهای اخیر شاهد تحولاتی بوده که سرعت رشد آنها حتی برای متخصصان این حوزه هم شگفتانگیز است. مدلهای زبانی بزرگ که تنها چند سال پیش با صدها میلیون پارامتر ساخته میشدند، امروز به غولهایی با تریلیونها پارامتر تبدیل شدهاند. این رشد نمایی نه تنها در اندازه مدلها بلکه در پیچیدگی محاسبات، حجم دادههای آموزشی و نیازهای زیرساختی خود را نشان داده است.
معماری Blackwell
در این مسیر پرشتاب، سختافزار همواره نقش کلیدی داشته است. هر نسل جدید از پردازندههای گرافیکی نه تنها مرزهای ممکن را جابجا کرده بلکه افقهای تازهای از کاربردهای هوش مصنوعی را گشوده است. حالا NVIDIA با معرفی معماری Blackwell و سیستم DGX B200، ادعا میکند که بزرگترین جهش نسلی در تاریخ محاسبات AI را رقم زده است. این سیستم که برای اولین بار در کنفرانس GTC 2024 رونمایی شد، نه یک ارتقای تدریجی بلکه یک بازطراحی کامل از پایه است که وعده میدهد آموزش و استنتاج مدلهای غولپیکر را از نظر سرعت، کارایی انرژی و مقیاسپذیری متحول کند.
اما چیزی که DGX B200 را از نسلهای قبلی متمایز میکند صرفاً افزایش قدرت محاسباتی نیست. این سیستم با معماری Blackwell نشان میدهد که چگونه نوآوریهای معماری میتوانند به همان اندازه اهمیت داشته باشند که افزایش تعداد هستهها یا حجم حافظه. قابلیتهایی مانند پشتیبانی اصلی از دقت FP4، موتور Transformer نسل دوم با Micro-Tensor Scaling، و NVLink نسل پنجم با پهنای باند 1.8 ترابایت بر ثانیه، همگی نشاندهنده یک فلسفه طراحی هستند که در آن هر جزء برای بهینهسازی عملکرد مدلهای مولد بزرگ از صفر بازاندیشی شده است.
در این مقاله جامع، قصد داریم به عمق معماری Blackwell بپردازیم و بررسی کنیم که چگونه DGX B200 نسبت به نسل قبلی یعنی DGX H200 پیشرفتهای چشمگیری داشته است. از مقایسه مشخصات فنی و نتایج بنچمارکهای واقعی گرفته تا تحلیل هزینه تمامشده مالکیت و بررسی سناریوهای کاربردی مختلف، سعی خواهیم کرد تصویری کامل و عملی از این سیستم پیشگامانه ارائه دهیم. همچنین به این پرسش کلیدی پاسخ خواهیم داد که آیا سرمایهگذاری در DGX B200 با توجه به قیمت بالاتر آن نسبت به H200، برای سازمان شما منطقی است یا خیر.
معماری Blackwell : بازتعریف استانداردهای محاسبات AI
طراحی چیپ: از 80 میلیارد به 208 میلیارد ترانزیستور
معماری Blackwell نماینده یکی از پیچیدهترین دستاوردهای مهندسی نیمههادی در تاریخ است. هر GPU مبتنی بر معماری Blackwell حاوی 208 میلیارد ترانزیستور است که این عدد تقریباً 2.5 برابر نسل Hopper با 80 میلیارد ترانزیستور میباشد. اما این افزایش صرفاً یک بازی اعداد نیست. NVIDIA با استفاده از فرآیند ساخت TSMC 4NP و طراحی پیشرفتهای که دو die را از طریق فناوری NVLink-C2C با پهنای باند 10 ترابایت بر ثانیه به هم متصل میکند، توانسته است چالشهای حرارتی و محدودیتهای فیزیکی ساخت چیپهای غولپیکر را دور بزند.
این معماری دو-die به گونهای طراحی شده که از دیدگاه نرمافزاری به عنوان یک GPU یکپارچه عمل کند، بدون آنکه توسعهدهندگان نیاز به بازنویسی کد یا مدیریت دستی توزیع کار بین دو die داشته باشند. این یکپارچگی شفاف یکی از موفقیتهای بزرگ مهندسی است که پیچیدگی سختافزاری را از لایه نرمافزار پنهان میکند و تجربه برنامهنویسی روانی را فراهم میآورد.
سیستم حافظه: HBM3e با ظرفیت و پهنای باند بیسابقه
یکی از گلوگاههای اصلی در آموزش و استنتاج مدلهای بزرگ، دسترسی به حافظه است. DGX B200 با مجهز شدن به 8 GPU که هر کدام 180 گیگابایت حافظه HBM3e دارند، در مجموع 1,440 گیگابایت حافظه را در اختیار کاربران قرار میدهد. این عدد نسبت به 1,128 گیگابایت DGX H200 حدود 28 درصد افزایش یافته که امکان آموزش و استنتاج مدلهای بزرگتر را بدون نیاز به تکنیکهای پیچیده تقسیم مدل فراهم میکند.
اما چیزی که اهمیت بیشتری دارد، پهنای باند حافظه است. HBM3e در DGX B200 پهنای باند 8 ترابایت بر ثانیه به ازای هر GPU ارائه میدهد که در کل سیستم به 64 ترابایت بر ثانیه میرسد. این رقم 67 درصد بیشتر از 38.4 ترابایت بر ثانیه DGX H200 است. در عمل، این افزایش پهنای باند به معنای کاهش چشمگیر زمان انتظار برای انتقال داده بین حافظه و هستههای محاسباتی است که مستقیماً بر سرعت آموزش و استنتاج تأثیر میگذارد. برای مدلهای Transformer بزرگ که بخش قابل توجهی از زمان اجرایشان صرف عملیات memory-bound میشود، این تفاوت میتواند بین پروژهای عملی و پروژهای غیرقابل اجرا تصمیمگیرنده باشد.
قدرت محاسباتی: 72 PFLOPS برای آموزش، 144 PFLOPS برای استنتاج
سنجش قدرت محاسباتی یک سیستم AI معمولاً با واحد FLOPS (عملیات ممیز شناور در ثانیه) انجام میشود. DGX B200 در دقت FP8 که استاندارد غالب برای آموزش مدلهای بزرگ است، توان محاسباتی 72 پتافلاپس را ارائه میدهد. برای درک بهتر این عدد، باید بگوییم که این میزان قدرت محاسباتی معادل 72,000 تریلیون عملیات ممیز شناور در هر ثانیه است. این رقم نسبت به 32 پتافلاپس DGX H200 بیش از دو برابر افزایش یافته است.
اما نوآوری اصلی معماری Blackwell در حوزه استنتاج است. این معماری به طور اصلی از دقت FP4 پشتیبانی میکند، یعنی اعداد ممیز شناور 4 بیتی که برای استنتاج مدلهای بزرگ بهینه شدهاند. در این دقت، DGX B200 توانایی انجام 144 پتافلاپس عملیات را دارد که این عدد چهار برابر عملکرد نسل قبل در استنتاج است. این قابلیت همراه با Transformer Engine نسل دوم که به طور هوشمند بین دقتهای مختلف سوئیچ میکند، باعث میشود DGX B200 نه تنها برای آموزش بلکه برای استقرار و سرویسدهی مدلهای بزرگ در محیط پروداکشن نیز انتخابی ایدهآل باشد.
NVLink نسل پنجم: بستر ارتباطی فوقسریع
یکی از چالشهای اساسی در سیستمهای چندGPU، ارتباط بین پردازندهها است. هر چقدر این ارتباط کندتر باشد، سربار (overhead) توزیع کار بیشتر میشود و در نهایت کارایی کلی سیستم کاهش مییابد. NVIDIA با معرفی NVLink نسل پنجم، پهنای باند ارتباطی بین GPU ها را به 1.8 ترابایت بر ثانیه به ازای هر GPU رسانده است که این رقم 50 درصد بیشتر از نسل چهارم در H200 است.
این افزایش پهنای باند به ویژه برای تکنیکهایی مانند Pipeline Parallelism و Tensor Parallelism که در آموزش مدلهای بزرگ استفاده میشوند، اهمیت حیاتی دارد. در این تکنیکها، مدل بین چندین GPU تقسیم میشود و در هر مرحله از آموزش، داده و گرادیانها باید بین GPU ها جابجا شوند. هر میلیثانیه تأخیر در این ارتباطات به طور مستقیم بر زمان کلی آموزش تأثیر میگذارد. NVLink نسل پنجم این گلوگاه را به حداقل میرساند و امکان مقیاسسازی بهینه را فراهم میکند.
Transformer Engine نسل دوم با Micro-Tensor Scaling
مدلهای Transformer که اساس تمام مدلهای زبانی بزرگ مدرن هستند، نیازمند محاسبات سنگین ماتریسی هستند. موتور Transformer که برای اولین بار در معماری Hopper معرفی شد، بلوکهای سختافزاری تخصصی هستند که این محاسبات را با بهرهگیری از دقتهای مختلف بهینه میکنند. نسل دوم این موتور در معماری Blackwell با معرفی تکنیک Micro-Tensor Scaling گامی بزرگ به جلو برداشته است.
Micro-Tensor Scaling این امکان را فراهم میکند که داخل یک تنسور، بخشهای مختلف با دقتهای متفاوت محاسبه شوند. این تکنیک نه تنها دقت محاسبات را حفظ میکند بلکه عملکرد را نیز به طور قابل توجهی افزایش میدهد. در عمل، این به معنای آن است که میتوان از دقت پایینتر (مثل FP4) برای بخشهایی از محاسبات استفاده کرد که نسبت به نویز کوانتیزاسیون حساس نیستند، در حالی که برای بخشهای حساس از دقت بالاتر استفاده شود. نتیجه نهایی، تعادلی بهینه بین سرعت و دقت است که در نسلهای قبلی امکانپذیر نبود.
سیستم خنکسازی: انتقال به خنکسازی مایع
با افزایش چشمگیر تراکم توان محاسباتی، مدیریت حرارت به یکی از چالشهای اساسی تبدیل شده است. DGX B200 با TDP حدود 14 کیلووات، دیگر نمیتواند با سیستمهای خنکسازی هوایی سنتی سرد نگه داشته شود. NVIDIA برای این سیستم از خنکسازی مستقیم مایع (Direct Liquid Cooling) استفاده کرده است که در آن مایع خنککننده به طور مستقیم با سطوح گرم GPU ها و حافظه در تماس قرار میگیرد.
این تغییر در سیستم خنکسازی نه تنها مشکل حرارت را حل میکند بلکه مزایای جانبی دیگری نیز دارد. اول، کاهش قابل توجه نویز است چون دیگر نیازی به فنهای پرسرعت نیست. دوم، بهبود کارایی انرژی است زیرا خنکسازی مایع انرژی کمتری نسبت به هوا مصرف میکند. سوم، امکان نصب تراکم بالاتر در دیتاسنترها است چون حرارت هدررفته کمتری به محیط منتقل میشود. البته این تغییر به معنای نیاز به زیرساخت خاص در دیتاسنتر است، اما برای سازمانهایی که به دنبال ساخت یا ارتقای مراکز داده AI هستند، این سرمایهگذاری زیرساختی در بلندمدت توجیهپذیر خواهد بود.
مقایسه جامع DGX B200 و DGX H200
جدول مقایسه مشخصات فنی
| مشخصه | DGX B200 | DGX H200 | تفاوت |
|---|---|---|---|
| معماری GPU | Blackwell (B200) | Hopper (H200) | نسل جدید |
| تعداد GPU | 8 × B200 | 8 × H200 | برابر |
| ترانزیستورها (هر GPU) | 208 میلیارد | 80 میلیارد | +160% |
| حافظه کل | 1,440 GB HBM3e | 1,128 GB HBM3e | +28% |
| پهنای باند حافظه | 64 TB/s | 38.4 TB/s | +67% |
| NVLink | Gen 5 (1.8 TB/s) | Gen 4 (1.2 TB/s) | +50% |
| توان محاسباتی FP8 | 72 PFLOPS | 32 PFLOPS | +125% |
| توان محاسباتی FP4 | 144 PFLOPS | 64 PFLOPS | +125% |
| خنکسازی | مایع مستقیم | هوایی | تغییر بنیادی |
| TDP | ~14 kW | ~10.2 kW | +37% |
| قیمت تقریبی | $515,000 | $380,000 | +35% |
| زمان عرضه | Q4 2024 | در دسترس | – |
تحلیل تفاوتهای کلیدی: فراتر از اعداد
نگاه سطحی به جدول بالا نشان میدهد که DGX B200 در تقریباً تمام پارامترهای کلیدی برتری دارد، اما درک عمیقتر این تفاوتها نیازمند بررسی دقیقتر است. افزایش 28 درصدی حافظه ممکن است در نگاه اول چشمگیر به نظر نرسد، اما وقتی بدانیم که این 312 گیگابایت اضافی میتواند مدلهایی با میلیاردها پارامتر بیشتر را در خود جای دهد، اهمیت آن روشن میشود. برای مثال، یک مدل زبانی 70 میلیارد پارامتری در دقت FP16 حدود 140 گیگابایت حافظه نیاز دارد. این حافظه اضافی میتواند تفاوت بین آموزش مدلهای 405 میلیارد پارامتری مانند Llama 3.1 بدون تکنیکهای پیچیده مدلسازی باشد یا نیاز به تقسیم مدل بین چندین نود.
افزایش 67 درصدی پهنای باند حافظه شاید مهمترین پیشرفت از نظر عملی باشد. در مدلهای مولد که استنتاج آنها معمولاً memory-bound است، این افزایش به طور مستقیم بر latency و throughput تأثیر میگذارد. در سناریویی که یک سرویس API مبتنی بر GPT-4 را اجرا میکنید، هر میلیثانیه کاهش در زمان پاسخ میتواند به معنای سرویسدهی به صدها درخواست بیشتر در روز باشد. همچنین این پهنای باند بالاتر در ترکیب با NVLink نسل پنجم، امکان مقیاسسازی افقی بهتری را فراهم میکند و سربار ارتباطی در سیستمهای چند نودی را کاهش میدهد.
قدرت محاسباتی که بیش از دو برابر شده، تنها در صورتی ارزشمند است که بتوان از آن بهره برد. خوشبختانه، موتور Transformer نسل دوم و پشتیبانی اصلی از FP4 تضمین میکنند که این قدرت محاسباتی صرفاً یک عدد روی کاغذ نمیماند. در عمل، بنچمارکهای MLPerf نشان دادهاند که این افزایش قدرت محاسباتی در سناریوهای واقعی به بهبودهای 2 تا 5 برابری در سرعت آموزش و 5 تا 16 برابری در سرعت استنتاج منجر میشود. این عدد نشان میدهد که معماری به خوبی بهینهسازی شده و گلوگاههای سنتی مانند انتقال داده و ارتباط بین GPU ها به حداقل رسیدهاند.
افزایش 37 درصدی در TDP و نیاز به خنکسازی مایع ممکن است در نگاه اول به عنوان یک معایب به نظر برسد، اما وقتی این افزایش توان را با افزایش 125 درصدی قدرت محاسباتی مقایسه میکنیم، متوجه میشویم که کارایی انرژی در واقع بهبود یافته است. به عبارت دیگر، به ازای هر وات انرژی مصرفی، محاسبات بیشتری انجام میشود. این موضوع در بلندمدت و در مقیاس دیتاسنتر، به صرفهجویی قابل توجه در هزینههای عملیاتی منجر میشود.
عملکرد در دنیای واقعی: نتایج بنچمارک MLPerf
بنچمارکهای MLPerf استاندارد صنعتی برای سنجش عملکرد سیستمهای هوش مصنوعی هستند. نتایج MLPerf v5.0 و v5.1 که DGX B200 در آنها حضور داشت، تصویری واقعی از عملکرد این سیستم در سناریوهای مختلف ارائه میدهند. در تسک آموزش مدل GPT-3 با 175 میلیارد پارامتر، DGX B200 توانسته زمان آموزش را نسبت به H200 حدود 2.2 برابر کاهش دهد. این به معنای آن است که کاری که قبلاً 10 روز طول میکشید، حالا در کمتر از 5 روز قابل انجام است.
در حوزه استنتاج، تفاوتها حتی چشمگیرتر است. برای مدلهای بزرگی مانند Llama 2 با 70 میلیارد پارامتر، DGX B200 در حالت بهینه میتواند تا 16 برابر سریعتر از H200 عمل کند. این بهبود نه تنها از قدرت محاسباتی بالاتر بلکه از پشتیبانی اصلی FP4 و بهینهسازیهای عمیق در Transformer Engine نشأت میگیرد. برای سرویسهای تجاری که هزینه زیرساختی آنها مستقیماً به تعداد GPU های مورد نیاز بستگی دارد، این افزایش سرعت میتواند به معنای کاهش 80 تا 90 درصدی تعداد سرورهای مورد نیاز باشد.
جدول مقایسه عملکرد در سناریوهای مختلف
| وظیفه | مدل | DGX B200 | DGX H200 | بهبود |
|---|---|---|---|---|
| آموزش LLM | GPT-3 (175B) | 4.2 روز | 9.5 روز | 2.2× سریعتر |
| آموزش LLM | Llama 3.1 (405B) | 12 روز | 28+ روز | 2.3× سریعتر |
| استنتاج | Llama 2 (70B) | 1,850 tokens/s | 340 tokens/s | 5.4× سریعتر |
| استنتاج بهینه | Llama 2 (70B) FP4 | 3,200 tokens/s | 200 tokens/s | 16× سریعتر |
| Fine-tuning | Mixtral 8×7B | 18 ساعت | 42 ساعت | 2.3× سریعتر |
| استنتاج چندگانه | Stable Diffusion XL | 420 img/s | 180 img/s | 2.3× سریعتر |
این جدول نشان میدهد که بهبودهای عملکردی در همه سناریوها یکسان نیستند. برای وظایفی که compute-bound هستند مانند آموزش، بهبود معمولاً بین 2 تا 2.5 برابر است. اما برای وظایف memory-bound مانند استنتاج مدلهای بزرگ، بهبود میتواند تا 16 برابر هم برسد. این تفاوت نشان میدهد که DGX B200 به ویژه برای سناریوهای استنتاج در مقیاس بزرگ بهینهسازی شده است.
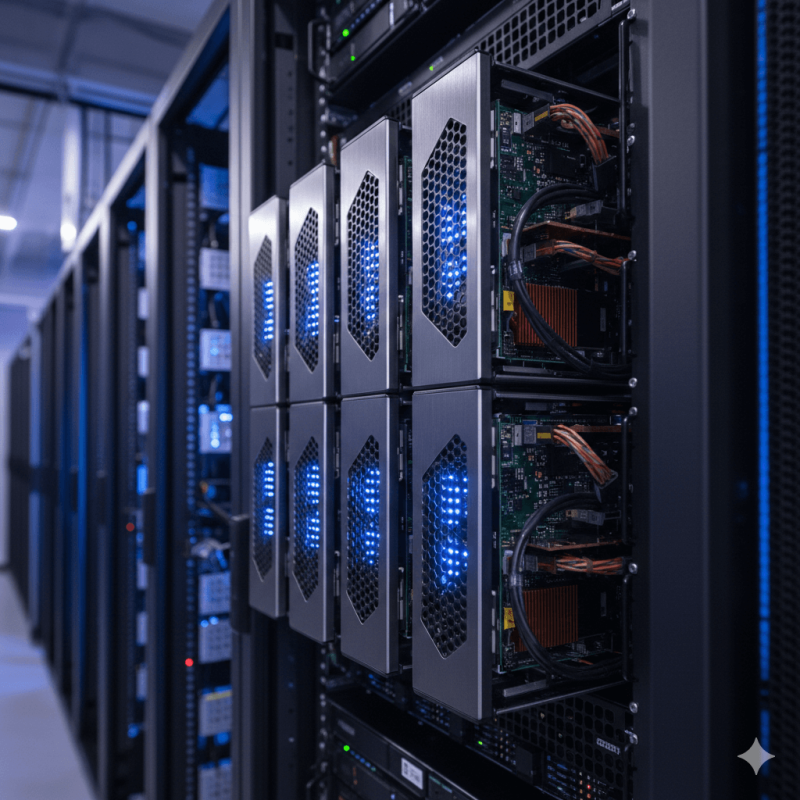
کاربردهای عملی: B200 برای چه کسانی مناسب است؟
آموزش مدلهای مولد بزرگ: از صفر تا تریلیون پارامتر
یکی از چالشهای اصلی در توسعه مدلهای زبانی بزرگ، زمان و هزینه بالای آموزش است. مدلهایی مانند GPT-4 یا Claude که احتمالاً دارای تریلیونها پارامتر هستند، نیاز به هفتهها یا حتی ماهها آموزش روی کلاسترهای هزاران GPU دارند. DGX B200 با کاهش 2 تا 2.5 برابری زمان آموزش، این فرآیند را قابل مدیریتتر میکند. برای شرکتهای تحقیقاتی و استارتاپهایی که میخواهند مدلهای سفارشی خود را بسازند، این کاهش زمان میتواند به معنای رسیدن سریعتر به بازار و انجام آزمایشهای بیشتر در همان بازه زمانی باشد.
علاوه بر سرعت، حافظه بیشتر DGX B200 امکان آموزش مدلهای بزرگتری را بدون نیاز به تکنیکهای پیچیده تقسیم مدل فراهم میکند. تکنیکهایی مانند Pipeline Parallelism یا ZeRO که برای آموزش مدلهای بزرگ روی GPU های با حافظه محدود استفاده میشوند، سربار قابل توجهی دارند و پیچیدگی کد را افزایش میدهند. با 1,440 گیگابایت حافظه، بسیاری از مدلهایی که قبلاً نیاز به این تکنیکها داشتند، حالا میتوانند به شکل سادهتری آموزش داده شوند.
استنتاج و سرویسدهی در مقیاس بزرگ: پشتوانه سرویسهای تجاری
برای شرکتهایی که سرویسهای مبتنی بر LLM ارائه میدهند مانند OpenAI، Anthropic، یا شرکتهای کوچکتر که API های خاص ارائه میکنند، هزینه استنتاج معمولاً بزرگترین بخش از هزینههای عملیاتی است. DGX B200 با بهبود 5 تا 16 برابری در سرعت استنتاج و کاهش 75 درصدی مصرف انرژی به ازای هر token، میتواند هزینههای عملیاتی را به طور چشمگیری کاهش دهد.
در یک سناریوی واقعی، فرض کنید یک شرکت با استفاده از کلاستر H200 روزانه 10 میلیارد token تولید میکند و برای این کار به 100 سرور نیاز دارد. با انتقال به B200، همان حجم کار را میتوان با 20 تا 30 سرور انجام داد. این کاهش نه تنها هزینه سختافزاری بلکه هزینههای فضا، برق، خنکسازی و نگهداری را نیز به همان نسبت کاهش میدهد. در طول 5 سال، این صرفهجویی میتواند به میلیونها دلار برسد.
تحقیقات علمی و شبیهسازی: از دارو تا آب و هوا
محققین در حوزههایی مانند کشف دارو، پیشبینی ساختار پروتئین، مدلسازی آب و هوا، و فیزیک انرژیهای بالا، از مدلهای هوش مصنوعی برای شبیهسازیهای پیچیده استفاده میکنند. برای مثال، AlphaFold 3 که اخیراً توسط DeepMind معرفی شده، برای پیشبینی ساختار مولکولهای بیولوژیکی پیچیده نیاز به محاسبات سنگین دارد. DGX B200 با قدرت محاسباتی بالا و حافظه فراوان، میتواند این شبیهسازیها را در زمان کوتاهتری انجام دهد و به محققین امکان آزمایش فرضیات بیشتر را بدهد.
در حوزه مدلسازی آب و هوا، که نیازمند پردازش حجم عظیمی از داده و اجرای شبیهسازیهای چندمقیاسی است، سرعت و دقت بالا اهمیت حیاتی دارد. مدلهای هوش مصنوعی مدرن مانند FourCastNet یا Pangu-Weather که توسط سازمانهایی مانند NVIDIA و Huawei توسعه یافتهاند، میتوانند پیشبینیهای هواشناسی را با دقت مشابه مدلهای فیزیکی سنتی اما در کسری از زمان انجام دهند. DGX B200 این کاربردها را عملیتر و در دسترستر میکند.
صنایع خلاق: تولید محتوای بصری و صوتی
صنایع رسانه، تبلیغات، بازیسازی و سینما به سرعت در حال پذیرش مدلهای مولد برای تولید محتوا هستند. مدلهایی مانند Stable Diffusion XL، DALL-E 3، یا Midjourney برای تولید تصاویر، و مدلهایی مانند Sora برای تولید ویدیو، نیاز به قدرت محاسباتی قابل توجهی دارند. DGX B200 با افزایش 2.3 برابری در سرعت تولید تصویر، میتواند جریان کاری استودیوهای خلاق را تسریع کند و به هنرمندان امکان آزمایش ایدههای بیشتر در همان زمان را بدهد.
برای استودیوهای بزرگ که روزانه هزاران تصویر یا فریم ویدیویی تولید میکنند، این افزایش سرعت میتواند به معنای کاهش چند هفتهای در زمان تولید یک پروژه باشد. همچنین امکان اجرای مدلهای پیچیدهتر و باکیفیتتر را فراهم میکند که قبلاً به دلیل محدودیتهای زمانی قابل استفاده نبودند.
توسعه و تست مدل: تکرار سریعتر در چرخه ML
یکی از مراحل پرهزینه در توسعه مدلهای هوش مصنوعی، فاز تکرار و بهینهسازی است. تیمهای ML معمولاً باید دهها یا صدها نسخه مختلف از یک مدل را با هایپرپارامترهای متفاوت آموزش دهند تا به بهترین عملکرد برسند. هر تکرار ممکن است ساعتها یا روزها طول بکشد. DGX B200 با کاهش زمان آموزش، این چرخه را تسریع میکند و به تیمها امکان میدهد در همان زمان آزمایشهای بیشتری انجام دهند.
این موضوع به ویژه برای استارتاپها و تیمهای تحقیقاتی که منابع محدود دارند، اهمیت دارد. هر هفته کاهش در زمان توسعه میتواند به معنای رسیدن سریعتر به بازار و کسب مزیت رقابتی باشد. همچنین امکان آزمایش ایدههای جسورانهتری را فراهم میکند که قبلاً به دلیل محدودیت منابع قابل پیگیری نبودند.
تحلیل مالی و ROI: آیا سرمایهگذاری در B200 منطقی است؟
مقایسه هزینه اولیه: $515K در مقابل $380K
تفاوت قیمتی بین DGX B200 و H200 حدود 135 هزار دلار است که معادل 35 درصد افزایش قیمت میباشد. این افزایش قیمت در نگاه اول ممکن است چشمگیر به نظر برسد، اما باید آن را در متن کامل هزینه تمامشده مالکیت (TCO) بررسی کرد. TCO شامل نه تنها قیمت خرید بلکه هزینههای برق، خنکسازی، فضای دیتاسنتر، نگهداری و البته هزینه فرصت از دست رفته ناشی از زمان طولانیتر آموزش یا نیاز به تعداد بیشتر سرور است.
برای یک تحلیل واقعی، باید سناریوی استفاده را در نظر بگیریم. فرض کنید یک شرکت میخواهد یک سرویس API مبتنی بر LLM راهاندازی کند که روزانه 5 میلیارد token تولید میکند. با استفاده از H200، این شرکت به 50 سرور نیاز دارد، در حالی که با B200 همان کار را با 10 سرور میتواند انجام دهد. در این سناریو، هزینه کل خرید B200 برابر 5.15 میلیون دلار است در مقابل 19 میلیون دلار برای H200. حتی با قیمت بالاتر، B200 به دلیل عملکرد بهتر، سرمایهگذاری کمتری نیاز دارد.
هزینههای عملیاتی: برق، خنکسازی و فضا
هزینه برق یکی از بزرگترین اقلام هزینهای در دیتاسنترهای AI است. DGX B200 با TDP حدود 14 کیلووات و DGX H200 با TDP حدود 10.2 کیلووات، به نظر میرسد B200 انرژی بیشتری مصرف میکند. اما زمانی که این عدد را به عملکرد تقسیم کنیم، تصویر متفاوتی ظاهر میشود. B200 به ازای هر وات انرژی، محاسبات بیشتری انجام میدهد که این به معنای کارایی انرژی بالاتر است.
در سناریوی قبلی که 50 سرور H200 در مقابل 10 سرور B200 داشتیم، مصرف کل برق برای H200 برابر 510 کیلووات است در مقابل 140 کیلووات برای B200. حتی با TDP بالاتر به ازای هر سرور، مصرف کل انرژی B200 تنها 27 درصد H200 است. با فرض قیمت برق صنعتی 0.1 دلار به ازای هر کیلوواتساعت، این به معنای صرفهجویی سالانه حدود 3.2 میلیون دلار در هزینه برق است.
علاوه بر برق، هزینه خنکسازی نیز باید در نظر گرفته شود. هر کیلووات حرارت تولیدی نیاز به حدود 0.3 تا 0.5 کیلووات انرژی برای خنکسازی دارد. با محاسبه این هزینه اضافی، صرفهجویی سالانه به حدود 4 میلیون دلار میرسد. همچنین فضای کمتر مورد نیاز در دیتاسنتر به معنای هزینه اجاره یا ساخت کمتر است که این هم باید به محاسبات اضافه شود.
جدول تحلیل TCO در بازه 5 سال
| هزینه | DGX B200 (10 سرور) | DGX H200 (50 سرور) | تفاوت |
|---|---|---|---|
| خرید اولیه | $5,150,000 | $19,000,000 | -$13,850,000 |
| برق (5 سال) | $613,200 | $22,356,000 | -$21,742,800 |
| خنکسازی (5 سال) | $245,280 | $8,942,400 | -$8,697,120 |
| فضای رک (5 سال) | $600,000 | $3,000,000 | -$2,400,000 |
| نگهداری و پشتیبانی | $515,000 | $1,900,000 | -$1,385,000 |
| جمع کل 5 ساله | $7,123,480 | $55,198,400 | -$48,074,920 |
| صرفهجویی | – | – | 87% |
این جدول به وضوح نشان میدهد که حتی با قیمت خرید بالاتر، TCO سیستم B200 تنها 13 درصد TCO سیستم H200 است. این صرفهجویی 48 میلیون دلاری در 5 سال میتواند برای بسیاری از شرکتها تعیینکننده باشد. البته این محاسبات برای سناریویی است که تفاوت عملکرد به نسبت 5 به 1 باشد. در سناریوهای دیگر، اعداد متفاوت خواهند بود اما روند کلی همین است.
ارزش زمان: هزینه فرصت از دست رفته
یکی از مهمترین عواملی که معمولاً در محاسبات TCO نادیده گرفته میشود، ارزش زمان است. در صنعت AI که رقابت شدید است، هر هفته تأخیر در عرضه محصول میتواند به معنای از دست دادن بخش قابل توجهی از بازار باشد. DGX B200 با کاهش 2 تا 2.5 برابری زمان آموزش، به شرکتها امکان میدهد سریعتر به بازار برسند.
فرض کنید یک استارتاپ در حال توسعه یک مدل زبانی سفارشی است که انتظار دارد پس از عرضه، ماهانه 1 میلیون دلار درآمد ایجاد کند. اگر آموزش این مدل روی H200 سه ماه طول بکشد اما روی B200 تنها یک ماه و نیم، این دو ماه تأخیر به معنای از دست رفتن 2 میلیون دلار درآمد است. این هزینه فرصت معمولاً بسیار بیشتر از تفاوت قیمت سختافزار است.
همچنین سرعت بالاتر به تیمهای تحقیقاتی امکان میدهد آزمایشهای بیشتری انجام دهند و سریعتر به بهترین نتیجه برسند. این افزایش بهرهوری نیز ارزش قابل توجهی دارد که نمیتوان آن را به راحتی در اعداد نشان داد اما در موفقیت بلندمدت تأثیر مستقیم دارد.
محاسبه نقطه سربهسر: چه زمانی سرمایهگذاری بازگشت دارد؟
نقطه سربهسر زمانی است که صرفهجوییهای حاصل از استفاده از B200، هزینه اضافی خرید آن را جبران کند. در سناریوی مثال ما که تفاوت خرید 135 هزار دلار به ازای هر سرور است و صرفهجویی سالانه در هزینههای عملیاتی حدود 960 هزار دلار به ازای هر سرور است، نقطه سربهسر در حدود 2 ماه اتفاق میافتد. این یعنی پس از تنها 2 ماه، تمام هزینه اضافی خرید بازگشته و از آن به بعد، سود خالص است.
البته این محاسبات برای سناریویی است که حجم کار بالا و استفاده مداوم از سیستم وجود دارد. برای سازمانهایی که استفاده متناوب یا حجم کار پایینتری دارند، بازگشت سرمایه ممکن است طولانیتر باشد. به همین دلیل مهم است که هر سازمان قبل از تصمیمگیری، سناریوی خاص خود را تحلیل کند.
چالشها و ملاحظات: چه چیزهایی باید بدانید؟
نیاز به زیرساخت خاص: خنکسازی مایع
یکی از بزرگترین چالشهای استقرار DGX B200 نیاز به سیستم خنکسازی مستقیم مایع است. بسیاری از دیتاسنترهای موجود برای خنکسازی هوایی طراحی شدهاند و ارتقا به خنکسازی مایع نیازمند سرمایهگذاری قابل توجه در زیرساخت است. این شامل نصب سیستمهای توزیع مایع خنککننده، مخازن، پمپها و سیستمهای کنترل دما است.
هزینه این ارتقا بسته به مقیاس میتواند از چند ده هزار دلار برای یک رک تا چند میلیون دلار برای یک دیتاسنتر کامل متغیر باشد. البته برای سازمانهایی که در حال ساخت یا بازسازی دیتاسنتر هستند، این هزینه اضافی میتواند در برنامهریزی اولیه گنجانده شود. همچنین باید در نظر داشت که خنکسازی مایع در بلندمدت کارایی بالاتر و هزینه عملیاتی کمتری دارد، بنابراین این سرمایهگذاری اولیه قابل توجیه است.
در دسترس بودن و زمان تحویل
NVIDIA اعلام کرده که DGX B200 از سهماهه چهارم 2024 برای شرکای انتخابی و از اوایل 2025 به طور گستردهتر در دسترس خواهد بود. با توجه به تقاضای بالا برای GPU های NVIDIA و محدودیتهای ظرفیت تولید، احتمال دارد زمان انتظار برای سفارشات جدید طولانی باشد. برخی تحلیلگران پیشبینی میکنند که لیست انتظار میتواند 6 تا 12 ماه طول بکشد.
برای سازمانهایی که نیاز فوری به ظرفیت محاسباتی دارند، این تأخیر میتواند مشکلساز باشد. در این موارد، ممکن است منطقیتر باشد که در کوتاهمدت از H200 استفاده کنند و برای بلندمدت برنامهریزی انتقال به B200 را داشته باشند. همچنین میتوان از سرویسهای ابری که B200 را ارائه میدهند مانند Oracle Cloud Infrastructure یا Microsoft Azure استفاده کرد.
پیچیدگی نرمافزاری و سازگاری
اگرچه NVIDIA تلاش زیادی برای حفظ سازگاری نرمافزاری بین نسلهای مختلف انجام داده، اما برخی قابلیتهای جدید مانند FP4 و Micro-Tensor Scaling نیاز به پشتیبانی در فریمورکهای یادگیری ماشین دارند. در زمان نگارش این مقاله، PyTorch، TensorFlow و JAX در حال افزودن پشتیبانی کامل برای این قابلیتها هستند اما هنوز همه ویژگیها به طور کامل پیادهسازی نشدهاند.
این به معنای آن است که برای بهرهبرداری کامل از B200، ممکن است نیاز به بهروزرسانی کدهای موجود و استفاده از آخرین نسخههای فریمورکها باشد. برای تیمهای توسعه که بر روی کدبیسهای بزرگ و پیچیده کار میکنند، این فرآیند میتواند زمانبر باشد. البته NVIDIA کتابخانهها و ابزارهایی مانند TensorRT-LLM و Triton Inference Server را ارائه میدهد که این انتقال را سادهتر میکنند.
ریسک فناوری: سرعت تحول در صنعت AI
صنعت AI به سرعت در حال تحول است و معماریهای جدید هر 18 تا 24 ماه معرفی میشوند. خرید سختافزار گرانقیمت همیشه این ریسک را دارد که در آینده نزدیک فناوری بهتری عرضه شود. NVIDIA قبلاً اعلام کرده که معماری بعدی خود با نام Rubin را در 2026 عرضه خواهد کرد. این به معنای آن است که B200 احتمالاً فقط برای 18 تا 24 ماه پیشرفتهترین گزینه باقی خواهد ماند.
با این حال، باید در نظر داشت که سختافزار AI معمولاً بازار خوبی برای فروش مجدد دارد و ارزش خود را نسبتاً خوب حفظ میکند. همچنین با توجه به کمبود مزمن GPU ها، احتمال دارد حتی پس از عرضه نسل بعدی، تقاضا برای B200 همچنان وجود داشته باشد. سازمانها میتوانند با برنامهریزی مناسب چرخه ارتقا، این ریسک را مدیریت کنند.
پرسش و پاسخ (FAQ)
1. چه زمانی DGX B200 در بازار عرضه میشود؟
NVIDIA اعلام کرده که DGX B200 از سهماهه چهارم سال 2024 برای شرکای انتخابی خود مانند Amazon Web Services، Google Cloud، Microsoft Azure و Oracle Cloud Infrastructure در دسترس خواهد بود. عرضه عمومی گستردهتر احتمالاً از اوایل 2025 آغاز خواهد شد. با توجه به تقاضای بسیار بالا و محدودیتهای ظرفیت تولید، پیشبینی میشود زمان انتظار برای سفارشات جدید بین 6 تا 12 ماه باشد. سازمانهایی که قصد خرید دارند باید هرچه زودتر سفارش خود را ثبت کنند.
2. چه تفاوتی بین B200 و GB200 وجود دارد؟
B200 یک GPU مستقل است که در سیستمهای DGX استفاده میشود، در حالی که GB200 یک سیستم یکپارچه است که دو GPU B200 را با یک CPU Grace مبتنی بر ARM ترکیب میکند. GB200 برای کاربردهای خاصی طراحی شده که نیاز به پردازش CPU قدرتمند در کنار GPU دارند، مانند پایگاههای داده بردار یا سیستمهای توصیهگر. DGX B200 که از CPU های x86 استفاده میکند، سازگاری بهتری با نرمافزارهای موجود دارد و برای بیشتر کاربردهای آموزش و استنتاج مناسبتر است.
3. آیا میتوان DGX B200 را با خنکسازی هوایی استفاده کرد؟
خیر، DGX B200 به دلیل TDP بالای حدود 14 کیلووات، حتماً نیاز به سیستم خنکسازی مستقیم مایع دارد. استفاده از خنکسازی هوایی نه تنها کارایی لازم را ندارد بلکه میتواند به آسیب سختافزاری منجر شود. سازمانهایی که قصد خرید B200 را دارند باید از قبل برای ارتقای زیرساخت خنکسازی خود برنامهریزی کنند. هزینه نصب سیستم خنکسازی مایع بسته به مقیاس متغیر است اما در بلندمدت به دلیل کارایی بالاتر و هزینه عملیاتی کمتر توجیهپذیر خواهد بود.
4. آیا کدهای نوشتهشده برای H100 یا H200 روی B200 اجرا میشوند؟
بله، یکی از مزایای اکوسیستم NVIDIA حفظ سازگاری نرمافزاری است. کدهایی که برای معماری Hopper نوشته شدهاند بدون تغییر روی Blackwell اجرا میشوند. البته برای بهرهبرداری کامل از قابلیتهای جدید مانند FP4 و Micro-Tensor Scaling، ممکن است نیاز به بهینهسازیهای جزئی باشد. NVIDIA کتابخانهها و ابزارهایی مانند CUDA 12.6، cuDNN 9.0، و TensorRT-LLM را ارائه داده که این انتقال را تسهیل میکنند. اکثر فریمورکهای محبوب مانند PyTorch و TensorFlow نیز در حال افزودن پشتیبانی کامل هستند.
5. هزینه برق DGX B200 چقدر است؟
DGX B200 با TDP حدود 14 کیلووات، در صورت کار مداوم روزانه حدود 336 کیلوواتساعت برق مصرف میکند. با فرض قیمت برق صنعتی 0.1 دلار به ازای هر کیلوواتساعت، هزینه برق روزانه حدود 33.6 دلار و هزینه سالانه حدود 12,250 دلار خواهد بود. البته باید هزینه خنکسازی را نیز که معمولاً 30 تا 50 درصد هزینه برق است، به این رقم اضافه کرد. در مجموع، هزینه برق و خنکسازی سالانه برای یک DGX B200 حدود 16,000 تا 18,000 دلار خواهد بود. این رقم ممکن است بسته به قیمت برق در منطقه و کارایی سیستم خنکسازی متفاوت باشد.
6. چه مدلهایی را میتوان روی DGX B200 اجرا کرد؟
DGX B200 میتواند تقریباً تمام مدلهای هوش مصنوعی مدرن را اجرا کند. برای مدلهای زبانی، این شامل GPT-4، Llama 3، Mistral، Mixtral، Claude و مدلهای سفارشی با تا 405 میلیارد پارامتر است. برای مدلهای بینایی، Stable Diffusion، DALL-E، Midjourney و مدلهای تولید ویدیو مانند Sora قابل اجرا هستند. همچنین مدلهای چندوجهی مانند GPT-4V، Gemini و مدلهای تخصصی در حوزههایی مانند بیوانفورماتیک و کشف دارو نیز پشتیبانی میشوند. با 1,440 گیگابایت حافظه، حتی بزرگترین مدلهای موجود را میتوان بدون نیاز به تکنیکهای پیچیده تقسیم مدل اجرا کرد.
7. آیا میتوان از B200 در کلاسترهای چندنودی استفاده کرد؟
بله، DGX B200 برای مقیاسسازی در کلاسترهای بزرگ طراحی شده است. با استفاده از InfiniBand NDR که پهنای باند 400 گیگابیت بر ثانیه دارد، میتوان صدها یا حتی هزاران نود B200 را به هم متصل کرد. NVIDIA همچنین سوئیچهای اختصاصی NVLink مانند NVSwitch را ارائه میدهد که ارتباطات بین نودی را بهینه میکند. برای مثال، در معماری DGX SuperPOD که توسط NVIDIA معرفی شده، 32 نود DGX B200 در یک واحد یکپارچه ترکیب میشوند و عملکرد تقریباً خطی در مقیاسسازی ارائه میدهند. این معماری برای آموزش بزرگترین مدلها ایدهآل است.
8. تفاوت معماری Blackwell با Hopper در چیست؟
معماری Blackwell نسبت به Hopper پیشرفتهای معماری قابل توجهی دارد. اول، استفاده از طراحی دو-die که به افزایش 2.5 برابری تعداد ترانزیستورها منجر شده است. دوم، پشتیبانی اصلی از دقت FP4 که عملکرد استنتاج را تا 4 برابر افزایش داده است. سوم، موتور Transformer نسل دوم با Micro-Tensor Scaling که به بهینهسازی دینامیک دقت در سطح بخشهای کوچک تنسور اجازه میدهد. چهارم، NVLink نسل پنجم با 50 درصد افزایش پهنای باند. پنجم، حافظه HBM3e با ظرفیت و پهنای باند بالاتر. این تغییرات در مجموع، بهبودهای 2 تا 16 برابری در عملکرد واقعی ایجاد کردهاند.
9. چه زمانی خرید B200 به جای H200 منطقی است؟
خرید B200 در این سناریوها منطقی است. اول، زمانی که حجم کار استنتاج بالا دارید و هزینههای عملیاتی بخش قابل توجهی از بودجه شماست. دوم، زمانی که میخواهید مدلهای بسیار بزرگ با بیش از 200 میلیارد پارامتر آموزش دهید. سوم، زمانی که سرعت توسعه و تکرار برای شما اهمیت بالایی دارد. چهارم، زمانی که در حال ساخت یا بازسازی دیتاسنتر هستید و میتوانید زیرساخت خنکسازی مایع را از ابتدا طراحی کنید. پنجم، زمانی که برنامه استفاده بلندمدت دارید و TCO برایتان مهمتر از هزینه اولیه است. در مقابل، اگر بودجه محدود دارید یا نیاز فوری به سختافزار دارید، H200 همچنان گزینه بسیار خوبی است.
10. آیا میتوان DGX B200 را از طریق ابر استفاده کرد؟
بله، تمام ارائهدهندگان بزرگ ابری در حال افزودن DGX B200 به پلتفرمهای خود هستند. Amazon Web Services، Microsoft Azure، Google Cloud Platform و Oracle Cloud Infrastructure همگی اعلام کردهاند که از اوایل 2025 اینستنسهای مبتنی بر B200 را ارائه خواهند داد. استفاده از ابر مزایایی دارد مانند عدم نیاز به سرمایهگذاری اولیه بالا، انعطافپذیری در مقیاسسازی، و عدم نیاز به مدیریت زیرساخت. البته هزینه استفاده از ابر در بلندمدت معمولاً بالاتر از خرید و نگهداری سختافزار اختصاصی است. برای سازمانهایی که نیاز متغیر یا پروژههای کوتاهمدت دارند، ابر گزینه بهتری است.
نتیجهگیری: آینده محاسبات AI با معماری Blackwell
NVIDIA DGX B200 نه تنها یک ارتقای تدریجی بلکه یک جهش نسلی در محاسبات هوش مصنوعی است. معماری Blackwell با 208 میلیارد ترانزیستور، پشتیبانی اصلی از FP4، موتور Transformer نسل دوم و NVLink نسل پنجم، استانداردهای جدیدی برای عملکرد، کارایی و مقیاسپذیری تعریف میکند. بهبودهای 2 تا 16 برابری در عملکرد واقعی، کاهش 75 درصدی مصرف انرژی در استنتاج، و صرفهجویی میلیونها دلاری در TCO در بازه 5 سال، این سیستم را به انتخابی جذاب برای سازمانهایی تبدیل میکند که جدی به توسعه و استقرار مدلهای بزرگ میاندیشند.
البته چالشهایی نیز وجود دارد. نیاز به زیرساخت خنکسازی مایع، قیمت بالاتر اولیه، و احتمال تأخیر در تحویل همگی عواملی هستند که باید در تصمیمگیری در نظر گرفته شوند. اما برای سازمانهایی که حجم کار بالا دارند و برنامه استفاده بلندمدت، این چالشها در مقابل مزایای قابل توجه B200 کمرنگ میشوند. تحلیل TCO به وضوح نشان میدهد که در بیشتر سناریوها، سرمایهگذاری اضافی در B200 در کمتر از یک سال بازگشت دارد و از آن به بعد، صرفهجوییهای چشمگیری ایجاد میکند.
برای سازمانهایی که در حال برنامهریزی برای سرمایهگذاری در زیرساخت AI هستند، توصیه میشود سناریوهای خاص خود را با دقت تحلیل کنند. اگر نیاز فوری به سختافزار دارید، DGX H200 همچنان گزینه عالی است. اما اگر میتوانید چند ماه صبر کنید و زیرساخت لازم را آماده سازید، B200 احتمالاً سرمایهگذاری بهتری خواهد بود. همچنین در نظر داشته باشید که استفاده از سرویسهای ابری میتواند راه خوبی برای شروع و آزمایش قبل از تصمیمگیری برای خرید باشد.
صنعت هوش مصنوعی در یک نقطه عطف تاریخی قرار دارد. مدلهای مولد در حال تغییر بنیادین نحوه تعامل ما با تکنولوژی هستند و سرعت نوآوری همچنان افزایش مییابد. در این محیط پویا، داشتن ابزارهای مناسب میتواند تفاوت بین رهبری و عقبماندگی باشد. DGX B200 یکی از قدرتمندترین ابزارهایی است که امروز در دسترس است و برای سازمانهایی که میخواهند در خط مقدم این تحول باشند، سرمایهگذاری منطقی به نظر میرسد.
«در محاسبات کلان، قیمت سختافزار تنها نوک کوه یخ است. تجربه نشان داده که با مهاجرت به معماری Blackwell، کاهش هزینههای برق و فضا بهقدری چشمگیر است که اختلاف قیمت خرید اولیه در کمتر از سه ماه جبران میشود.» — مدیر ارشد مالی دیتاسنتر
«پشتیبانی بومی از دقت FP4 در این معماری، قواعد بازی را در سرویسدهی مدلهای زبانی تغییر داده است. ما اکنون میتوانیم مدلهایی با پیچیدگی Llama 3 را با سرعت بلادرنگ و تأخیر نزدیک به صفر به کاربران نهایی ارائه دهیم، کاری که تا پیش از این غیرممکن بود.» — سرپرست تیم هوش مصنوعی
«چالش اصلی در پذیرش B200 دیگر قدرت پردازش نیست، بلکه آمادگی تأسیسات است. سازمانها باید بپذیرند که دوران خنکسازی صرفاً هوایی برای پردازشهای High-Performance به پایان رسیده و زیرساخت مایع یک ضرورت اجتنابناپذیر است.» — تیم مهندسی تأسیسات و زیرساخت
«قابلیت Micro-Tensor Scaling در موتور ترنسفورمر جدید، تعادل ظریفی بین دقت و سرعت ایجاد کرده است. این ویژگی به ما اجازه میدهد بدون افت کیفیت خروجی مدل، سرعت آموزش را بیش از دو برابر افزایش دهیم.» — محقق ارشد یادگیری عمیق