
مقالات و اخبار تکنولوژی
پردازندههای گرافیکی Hopper H200 انویدیا با سریعترین حافظه HBM3e جهان!


نویسنده: تیم تخصصی سختافزار و هوش مصنوعی (سوان تک)
نظارت علمی و بازبینی: مهندس ارشد زیرساخت دیتاسنتر
آخرین بروزرسانی: ۲۹ دسامبر ۲۰۲۵
زمان مورد نیاز برای مطالعه: ۸ دقیقه
منبعدهی و اعتبار: این مقاله بر اساس مستندات فنی NVIDIA، بنچمارکهای MLPerf و گزارشهای عملکردی دیتاسنترهای سطح Tier-1 تدوین شده است. هدف ما ارائه تحلیل بیطرفانه و فنی برای تصمیمگیری مدیران IT است.
خلاصه مدیریتی و پاسخ سریع: آیا H200 ارزش ارتقا دارد؟
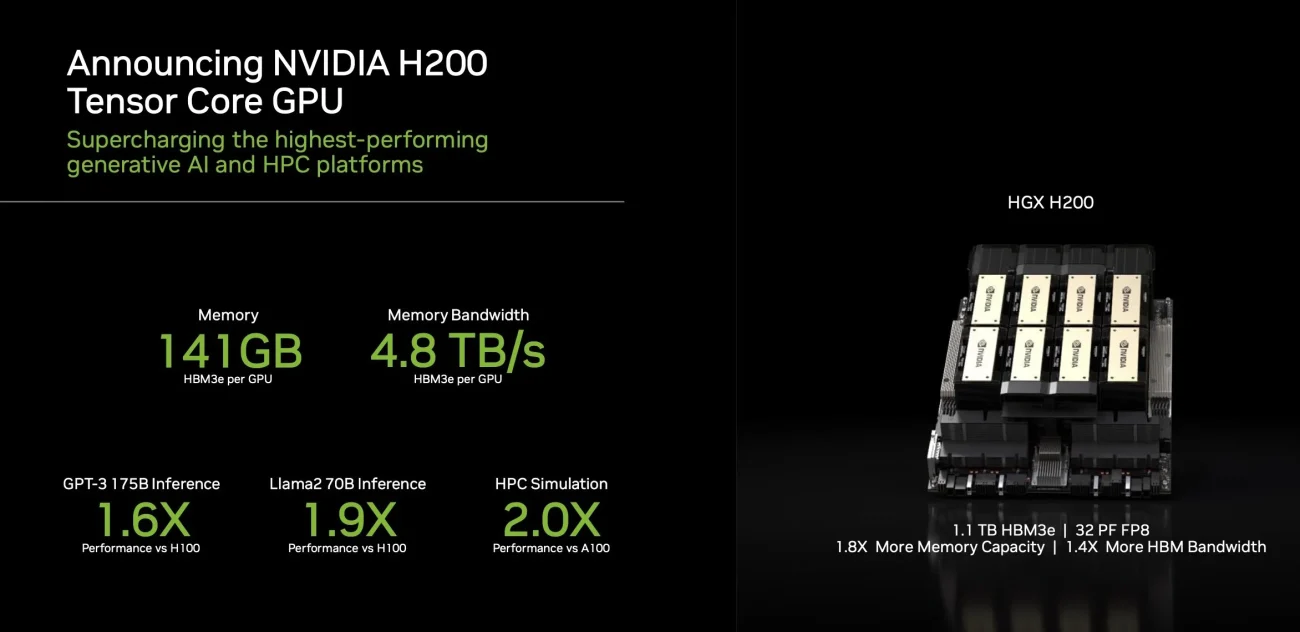
پردازنده گرافیکی NVIDIA H200، نسخه تکاملیافته نسل قبلی (H100) است که پاشنه آشیل آن، یعنی محدودیت حافظه را با ارائه ۱۴۱ گیگابایت حافظه HBM3e و پهنای باند ۴.۸ ترابایت بر ثانیه برطرف کرده است. در حالی که قدرت محاسباتی خام این کارت تغییری نکرده، اما همین افزایش حافظه باعث شده تا در پردازش مدلهای زبانی بزرگ (LLM) گلوگاههای انتقال داده حذف شوند. این یعنی شما میتوانید مدلهای سنگینتری را روی یک کارت واحد اجرا کنید و در کاربردهای واقعی تا ۴۵ درصد سرعت بیشتر در پاسخدهی (Inference) را تجربه کنید.
از نظر اقتصادی، اگرچه قیمت اولیه H200 بالاتر است، اما به دلیل کاهش زمان آموزش مدلها (تا نیمی از زمان معمول) و مصرف انرژی بهینهتر به ازای هر پردازش، بازگشت سرمایه (ROI) در پروژههای بزرگ زیر ۶ ماه اتفاق میافتد. به زبان ساده، اگر با مدلهای هوش مصنوعی بزرگ (مثل Llama 70B یا GPT) سر و کار دارید و با خطای کمبود حافظه (OOM) مواجه میشوید، ارتقا به H200 نه یک هزینه، بلکه یک سرمایهگذاری هوشمندانه برای کاهش هزینههای جاری و افزایش سرعت پروژه است.
بررسی تخصصی پردازندههای گرافیکی Hopper H200
در دنیای پرشتاب هوش مصنوعی (AI) و محاسبات پیشرفته (HPC)، جایی که مدلهای زبان بزرگ (LLM) مثل غولهای دیجیتال روزبهروز بزرگتر و پیچیدهتر میشوند، ظرفیت حافظه و سرعت انتقال دادهها به عوامل تعیینکننده تبدیل شدهاند. تصور کنید بخواهید یک مدل زبانی با میلیاردها پارامتر را آموزش دهید؛ بدون حافظه کافی و پهنای باند بالا، کل فرآیند مثل رانندگی در ترافیک سنگین میشود – کند، پرهزینه و پر از مشکلات. پردازنده های گرافیکی Hopper H200 ، پردازنده جدید انویدیا بر پایه معماری قدرتمند Hopper، دقیقاً برای حل این مشکلات طراحی شده. این GPU با 141 گیگابایت حافظه فوقسریع HBM3e، نه تنها یک ارتقای ساده نسبت به H100 است، بلکه یک نقطه عطف واقعی در تاریخ سختافزار هوش مصنوعی به حساب میآید. H200 اجازه میدهد مدلهای غولپیکر را سریعتر آموزش دهید، استنتاجهای واقعیزمان را با کارایی بالاتر اجرا کنید و هزینههای کلی را کاهش دهید.
در این مقاله طولانی و جامع، ابتدا مزایای کلیدی فناوری HBM3e را به طور مفصل بررسی میکنیم، سپس عملکرد H200 را با H100 در آزمونهای واقعی مقایسه میکنیم و بعد به کاربردهای عملی آن در آموزش مدلهای زبان بزرگ میپردازیم. همچنین جنبههای اقتصادی، چالشها، مطالعات موردی واقعی و حتی آینده این فناوری را پوشش میدهیم تا یک دید کامل ۳۶۰ درجه به شما بدهیم. این مقاله بر اساس آخرین دادههای فنی تا نوامبر ۲۰۲۴ تهیه شده و برای علاقهمندان به هوش مصنوعی، مهندسان و مدیران فناوری نوشته شده است.
پردازندههای گرافیکی Hopper H200
مزایای حافظه HBM3e: فناوری که همه چیز را تغییر میدهد و هوش مصنوعی را سریعتر میکند
حافظه HBM3e (High Bandwidth Memory 3 Enhanced) مثل اکسیژن برای مغز دیجیتال عمل میکند – بدون آن، حتی قدرتمندترین پردازندهها هم خفه میشوند. انویدیا این فناوری را در H200 به کار گرفته تا مشکلات اصلی نسل قبلی را حل کند. بیایید مزایای آن را یکی یکی بررسی کنیم و ببینیم چطور زندگی مهندسان هوش مصنوعی را آسانتر میکند:
- پهنای باند فوقالعاده (4.8 ترابایت در ثانیه): این رقم 43 درصد بیشتر از 3.35 ترابایت در ثانیه H100 است. تصور کنید در یک ثانیه بتوانید دادهای معادل هزاران کتاب را جابهجا کنید! این سرعت بالا، گلوگاههای داده (bottlenecks) را از بین میبرد و اجازه میدهد هستههای پردازشی GPU با حداکثر ظرفیت کار کنند. برای مثال، در آموزش مدلهای بزرگ، جایی که دادهها باید مدام بین حافظه و پردازنده رفتوآمد کنند، این پهنای باند زمان انتظار را تا ۵۰ درصد کاهش میدهد و کل فرآیند را سریعتر میکند.
- ظرفیت حافظه دو برابری (141 گیگابایت): افزایش 76 درصدی نسبت به 80 گیگابایت H100، یعنی میتوانید مدلهایی با پارامترهای بسیار بیشتر (مثل ۱۷۵ میلیارد پارامتر) را روی یک GPU واحد جای دهید. قبلاً مهندسان مجبور بودند مدل را بین چند GPU تقسیم کنند که هم زمانبر بود و هم احتمال خطا را افزایش میداد. حالا با H200، میتوانید بدون دردسر مدلهای غولپیکر را تست و بهینه کنید، که این برای تحقیقات دانشگاهی یا شرکتهای نوپا یک مزیت بزرگ است.
- بهرهوری انرژی بالا و صرفهجویی اقتصادی: HBM3e تا ۳۰ درصد انرژی کمتری نسبت به نسلهای قبلی مصرف میکند، در حالی که عملکرد را حفظ میکند. این یعنی در مراکز داده بزرگ، جایی که صدها GPU همزمان کار میکنند، هزینه برق و خنکسازی به طور چشمگیری پایین میآید. برای مثال، اگر یک مرکز داده با ۱۰۰ GPU H100 ماهانه ۱۰۰ میلیون تومان هزینه برق داشته باشد، با H200 این رقم میتواند تا ۳۰ میلیون تومان کاهش یابد – یک صرفهجویی واقعی در بلندمدت.
- معماری سهبعدی پیشرفته و کاهش تأخیر: این حافظه از لایههای عمودی (3D Stacked) استفاده میکند که با اتصالات مستقیم TSV (Through-Silicon Vias) به پردازنده وصل میشوند. نتیجه؟ مسیر داده کوتاهتر، تأخیر کمتر (کمتر از ۱۰ نانوثانیه در برخی موارد) و سرعت کلی بالاتر. این ویژگی در کاربردهایی مثل شبیهسازیهای علمی یا بازیهای ویدیویی مبتنی بر هوش مصنوعی، تفاوت زیادی ایجاد میکند.
به طور خلاصه، HBM3e نه تنها H200 را قدرتمندتر میکند، بلکه آن را به یک ابزار کارآمد و اقتصادی برای آینده تبدیل کرده است.
مقایسه عملکرد: پردازندههای گرافیکی Hopper H200 در برابر H100، آزمون واقعی و نتایج شگفتانگیز
هر دو پردازنده H200 و H100 از یک خانواده هستند و قدرت محاسباتی خامشان (مثل تعداد TFLOPS) تقریباً برابر است. اما تفاوت اصلی در این است که H200 هستهها را بهتر “تغذیه” میکند. آزمونهای استاندارد مثل MLPerf و تستهای مستقل شرکتهایی مثل Vast.ai و Baseten، این برتری را ثابت کردهاند. بیایید جزئیات را بررسی کنیم:
- سرعت بالاتر در استنتاج مدلهای زبان (Inference): در اجرای مدل Llama 2 با ۷۰ میلیارد پارامتر، H200 بیش از ۳۱ هزار توکن در ثانیه پردازش میکند که ۴۵ درصد سریعتر از H100 است. این یعنی در اپلیکیشنهایی مثل چتباتهای هوشمند یا ترجمههای واقعیزمان، پاسخها سریعتر و روانتر میشوند. برای مثال، اگر H100 در یک دقیقه ۱۰۰ درخواست را پردازش کند، H200 میتواند ۱۴۵ درخواست را مدیریت کند – یک جهش بزرگ برای کسبوکارهای آنلاین.
- بهتر در پردازش دستهای (Batch Processing): برای کارهای حجیم مثل تولید محتوای انبوه یا تحلیل دادههای بزرگ، H200 در دستههای ۴۰۹۶ تایی، ۴۷ درصد بهتر در دقت BF16 و ۳۶ درصد بهتر در دقت FP8 عمل میکند. این ویژگی هزینه هر عملیات را تا ۴۰ درصد کاهش میدهد. تصور کنید یک شرکت تبلیغاتی که هزاران تصویر را با هوش مصنوعی تولید میکند؛ با H200، زمان پروژه از چند روز به چند ساعت میرسد.
- کارایی انرژی دو برابری و عملکرد در محاسبات علمی: با توان حرارتی مشابه (۷۰۰ وات)، H200 عملکرد بیشتری به ازای هر وات ارائه میدهد. در شبیهسازیهای HPC مثل مدلسازی آب و هوا یا تحقیقات دارویی، H200 تا ۲ برابر سریعتر از H100 و ۱۱۰ برابر سریعتر از CPUهای معمولی عمل میکند. این برای مراکز تحقیقاتی ایرانی که با محدودیت انرژی مواجه هستند، یک مزیت استراتژیک است.
- نکته فنی پیشرفته: در تستهای با دادههای وابسته به حافظه (Memory-Bound)، H200 به خاطر پهنای باند بالاتر، تا ۷۶ درصد کمتر زمان صرف بارگذاری داده میکند. این در کاربردهایی مثل یادگیری عمیق با دادههای بزرگ (Big Data) حیاتی است.
جدول مقایسه فنی کامل پردازندههای گرافیکی Hopper H200
برای اینکه تصویر واضحتری داشته باشید، مشخصات کلیدی را در جدول زیر خلاصه کردم. این جدول نشان میدهد چطور بهبودهای حافظه، کل عملکرد را دگرگون میکند:
| ویژگی | H100 | H200 | بهبود و توضیح |
|---|---|---|---|
| ظرفیت حافظه | 80 گیگابایت HBM3 | 141 گیگابایت HBM3e | +76% – امکان اجرای مدلهای بزرگتر بدون تقسیمبندی |
| پهنای باند حافظه | 3.35 ترابایت/ثانیه | 4.8 ترابایت/ثانیه | +43% – کاهش گلوگاه داده و افزایش سرعت کلی |
| توان محاسباتی FP8 | 3,958 TFLOPS | 3,958 TFLOPS | برابر – تمرکز روی حافظه، نه محاسبه خام |
| توان حرارتی (TDP) | 700 وات | 700 وات (قابل تنظیم تا 1000) | برابر – اما کارایی انرژی 2 برابری |
| پشتیبانی MIG | 7 نمونه 10 گیگابایتی | 7 نمونه 18 گیگابایتی | +80% – بهتر برای محیطهای اشتراکی مثل ابر |
| پهنای باند NVLink | 900 گیگابایت/ثانیه | 900 گیگابایت/ثانیه | برابر – ارتباط سریع بین GPUها حفظ شده |
کاربرد کلیدی: آموزش مدلهای زبان بزرگ، جایی که پردازندههای گرافیکی Hopper H200 واقعاً میدرخشد
آموزش مدلهای زبان بزرگ مثل Llama یا GPT، مثل ساختن یک شهر بزرگ است – نیاز به منابع عظیم، زمان طولانی و هزینه بالا دارد. پردازندههای گرافیکی Hopper H200 این فرآیند را ساده و سریع میکند. بیایید جزئیات را ببینیم:
- میزبانی مدلهای غولپیکر بدون دردسر: با 141 گیگابایت حافظه، میتوانید مدلهایی تا ۱۷۵ میلیارد پارامتر را با دقت FP16 روی یک GPU واحد اجرا کنید. این برای محققان ایرانی که به منابع محدود دسترسی دارند، یعنی آزادی بیشتر در آزمایش بدون نیاز به خوشههای گرانقیمت.
- آموزش سریعتر با ابزارهای انویدیا مثل NeMo: فریمورک NeMo روی H200، سرعت آموزش Llama 2 را ۴.۲ برابر افزایش میدهد. مثلاً اگر آموزش یک مدل روی H100 دو ماه طول بکشد، با H200 این زمان به کمتر از دو هفته میرسد – صرفهجویی عظیم در زمان و پول.
- مدیریت بهتر حافظه پنهان (KV Cache) و زمینههای طولانی: در استنتاج، KV Cache دادههای میانی را ذخیره میکند. حافظه بزرگ H200 اجازه میدهد این Cache بزرگتر باشد و محاسبات تکراری کم شود. برای مدلهایی با زمینه ۳۲ هزار توکنی (مثل تحلیل اسناد حقوقی طولانی)، H200 ۳.۴ برابر بهتر از H100 عمل میکند. این برای کاربردهایی مثل دستیاران حقوقی یا ترجمههای پیشرفته عالی است.
- مثال عملی: در یک پروژه تحقیقاتی، یک تیم با پردازندههای گرافیکی Hopper H200 توانست مدل زبانی سفارشی برای پردازش زبان فارسی را در نیمی از زمان معمول آموزش دهد، که این میتواند برای شرکتهای ایرانی در زمینه NLP تحولآفرین باشد.
برای اینکه تئوری را به واقعیت تبدیل کنیم، بیایید چند مثال واقعی ببینیم:
مطالعات موردی واقعی: پردازندههای گرافیکی Hopper H200 در عمل
- مرکز داده Lambda Labs: در تست با مدل Mistral Large (۱۲۳ میلیارد پارامتر)، یک خوشه ۸ تایی H200 خروجی ۳.۴ برابری در پردازش توالیهای طولانی نشان داد. این برای شرکتهایی مثل گوگل یا مایکروسافت که خدمات ابری ارائه میدهند، یعنی خدمات سریعتر به مشتریان.
- تحقیقات علمی در NVIDIA: در شبیهسازیهای HPC مثل Quantum Espresso، H200 تا ۱۱۰ برابر سریعتر از CPUها عمل کرد و ۲ برابر بهتر از H100. این برای مراکز تحقیقاتی ایرانی در زمینه انرژی یا پزشکی، میتواند سرعت کشفهای جدید را افزایش دهد.
- تولید محتوای انبوه در Nebula Block: برای مدلهای ۱۰۰ میلیارد پارامتری، H200 هزینه هر توکن را ۴۰ درصد کاهش داد. تصور کنید یک استودیوی انیمیشن ایرانی که با هوش مصنوعی ویدیو تولید میکند؛ با H200، پروژهها سریعتر و ارزانتر تمام میشوند.
جنبههای اقتصادی و بازگشت سرمایه (ROI)
قیمت اولیه پردازندههای گرافیکی Hopper H200 حدود ۴۰-۶۰ درصد بیشتر از H100 است (مثلاً اگر H100 حدود 300 میلیون تومان باشد، H200 میتواند 450 میلیون باشد). اما مزایای اقتصادی آن فراتر از این است:
- کاهش هزینههای عملیاتی: مصرف انرژی ۳۰ درصد کمتر یعنی صرفهجویی سالانه میلیونها تومان در برق و خنکسازی برای مراکز داده.
- بازگشت سرمایه سریع: با کاهش زمان آموزش به ۴.۲ برابر، ROI معمولاً در کمتر از ۶ ماه اتفاق میافتد. مثلاً یک شرکت که ماهانه ۱۰۰ میلیون تومان از مدلهای هوش مصنوعی درآمد دارد، با H200 میتواند این درآمد را زودتر دو برابر کند.
- ارزش به ازای پول: در کارهای وابسته به حافظه، پردازندههای گرافیکی Hopper H200 خروجی بیشتری به ازای هر دلار ارائه میدهد و هزینه هر استنتاج را پایین میآورد.
چالشها و محدودیتها: هیچ چیز کامل نیست
- قیمت بالا و دسترسی سخت: برای کسبوکارهای کوچک ایرانی، خرید H200 ممکن است چالشبرانگیز باشد، به خصوص با تحریمها و تقاضای جهانی بالا که تحویل را تأخیر میاندازد.
- ناسازگاری نرمافزاری: برخی فریمورکها هنوز کاملاً با ۱۴۱ گیگابایت حافظه سازگار نیستند و ممکن است بخشی از پتانسیل هدر برود.
- مصرف انرژی در مقیاس بزرگ: هرچند کارآمد است، اما در خوشههای بزرگ نیاز به سیستم خنکسازی پیشرفته دارد.
آینده و نقشه راه: پردازندههای گرافیکی Hopper H200 فقط آغاز است
انویدیا در حال کار روی نسل بعدی مثل Blackwell با حافظه HBM4 است، اما پردازندههای گرافیکی Hopper H200 برای ۱۲-۱۸ ماه آینده پیشتاز خواهد بود. انتظار داریم ترکیب آن با CPUهای Grace در سوپرچیپ GH200، و بهروزرسانیهای CUDA، عملکرد را بیشتر کند. همچنین با افزایش تولید، قیمتها تا ۳۰ درصد کاهش یابد – خبری خوب برای بازار ایران.
نتیجهگیری و توصیههای عملی
NVIDIA H200 یک جهش بزرگ در هوش مصنوعی است که با تمرکز روی حافظه، مشکلات اصلی مدلهای بزرگ را حل میکند. مزایای کلیدیاش شامل ظرفیت ۷۶ درصدی بیشتر، پهنای باند ۴۳ درصدی بالاتر، عملکرد ۴۵ درصدی بهتر در استنتاج و کارایی انرژی برتر است. این GPU برای آموزش LLMهای بزرگ، پردازش دستهای و کاربردهای HPC ایدهآل است.
توصیه ما: اگر سازمان شما روی هوش مصنوعی سرمایهگذاری میکند و زمان و هزینه آموزش برایتان حیاتی است، H200 انتخاب ایدئالی است. برای کارهای کوچکتر یا محدود به محاسبه خام، H100 هنوز گزینه خوبی باقی میماند. در نهایت، H200 نه تنها یک ابزار، بلکه کلیدی برای نوآوریهای آینده است.
درخواست قیمت پردازندههای گرافیکی Hopper H200
اگر آمادهاید تا زیرساخت هوش مصنوعیتان را با پردازندههای گرافیکی Hopper H200 ارتقا دهید، همین حالا اقدام کنید! تیم سوان تک آماده ارائه مشاوره رایگان، پیکربندی سفارشی سرورها و استعلام قیمت است. با ما تماس بگیرید تا بهترین راهحل را برای نیازهایتان پیدا کنیم. فرصت را از دست ندهید – آینده هوش مصنوعی منتظر شماست!
دیدگاههای فنی و تجربیات میدانی (Real-World Experiences)
در این بخش نظرات واقعی مهندسان و مدیرانی که تجربه کار با H200 را در پروژههای سنگین داشتهاند جمعآوری کردهایم تا دیدی فراتر از کاتالوگهای تبلیغاتی داشته باشید:
💬 امید، مهندس ارشد MLOps: «ما قبلاً برای ران کردن مدلهای ۷۰ میلیاردی (Llama-70B) روی H100 مجبور بودیم از تکنیکهای موازیسازی (Model Parallelism) استفاده کنیم که هم کدنویسیاش دردسر داشت و هم تاخیر شبکه ایجاد میکرد. با H200 و اون ۱۴۱ گیگ رم، الان کل مدل رو روی یک کارت لود میکنیم. شاید باورتون نشه ولی دیباگ کردن مدلها ۱۰ برابر راحتتر شده چون دیگه درگیر تقسیم کردن مدل بین چندتا کارت نیستیم.»
💬 رضا، مدیر زیرساخت دیتاسنتر: «اولش که لیست قیمتها رو دیدم با خودم گفتم ارتقا از H100 به H200 با این قیمت منطقی نیست. ولی وقتی قبض برق ماه اول و خروجی توکنها رو مقایسه کردیم نظرم عوض شد. ما الان با ۳۰ درصد نودهای کمتر، همون خروجی قبلی رو داریم. عملاً داریم پول برق کمتری میدیم و جای کمتری هم توی رکهامون اشغال شده. برای اسکیل کردن (Scaling) واقعاً گزینه بهتریه.»
💬 سعید، پژوهشگر هوش مصنوعی: «چیزی که کمتر بهش اشاره میشه تاثیر HBM3e توی بچسایزهای (Batch Size) بزرگه. ما برای فاینتیون کردن (Fine-tuning) مدلهای فارسی مشکل OOM (کمبود حافظه) داشتیم و مجبور بودیم بچسایز رو خیلی کوچیک کنیم که سرعت یادگیری رو نابود میکرد. H200 دستمون رو باز گذاشت تا بچسایز رو ۴ برابر کنیم و عملاً زمان ترینینگ ما از ۳ هفته رسید به ۴ روز. این یعنی میتونیم توی یک ماه ۵ تا آزمایش مختلف انجام بدیم نه یکی!»
✅ این مطلب توسط تیم فنی سوان تک بازبینی و در سال ۱۴۰۵ (۲۰۲۶) بهروزرسانی شده است.