




توضیحات
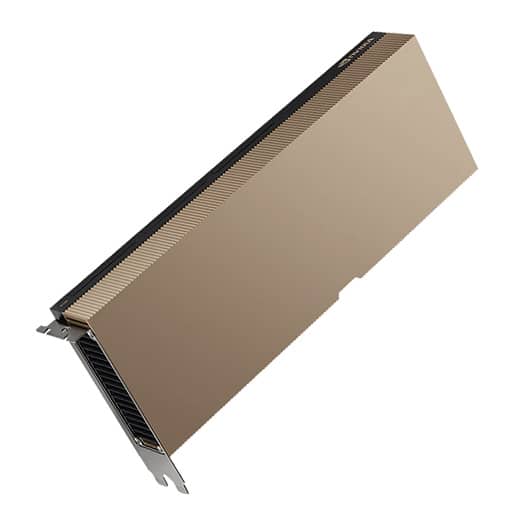
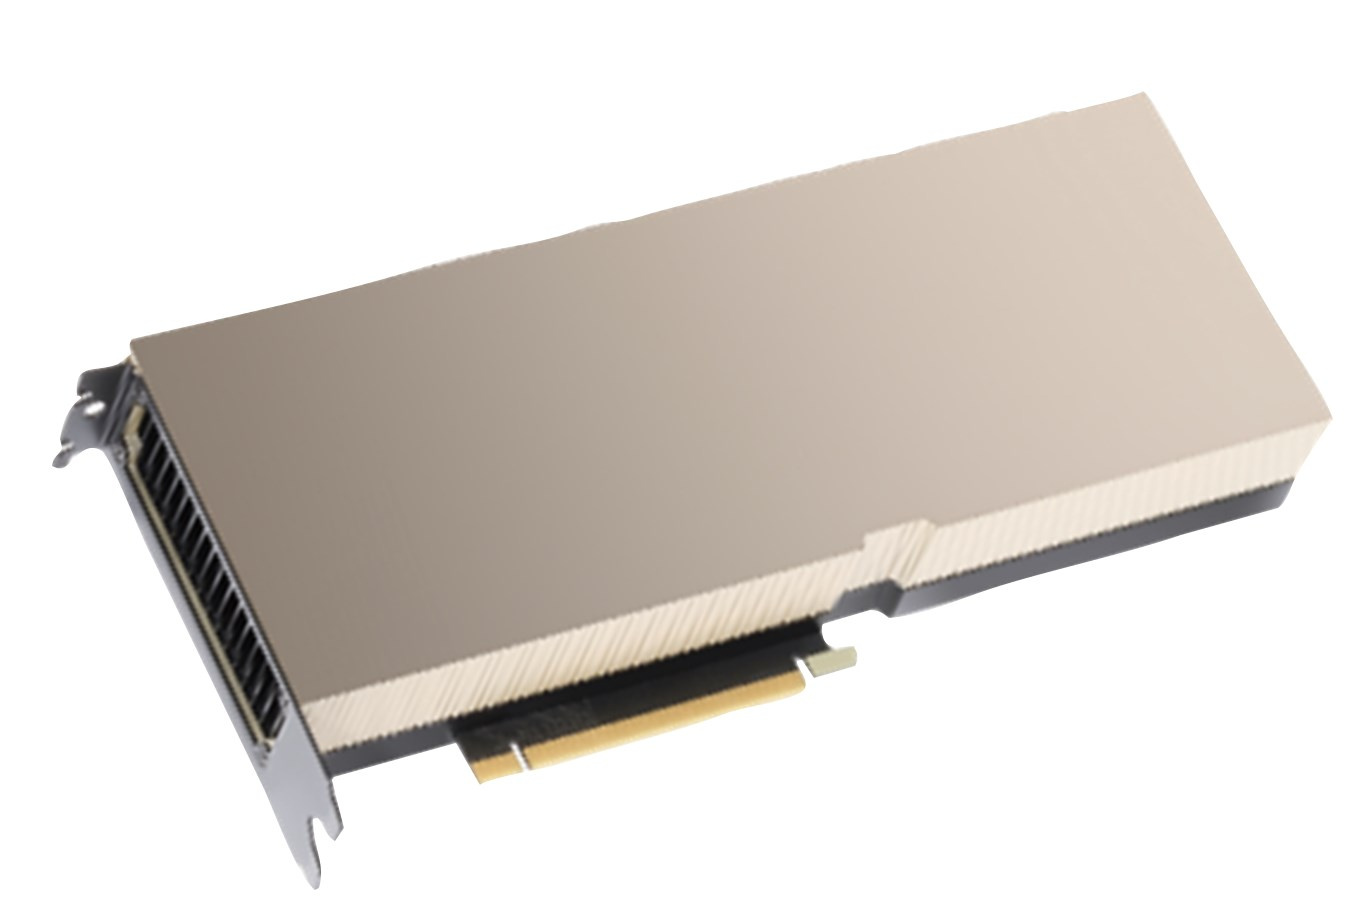
کارت گرافیک کارت گرافیک انویدیا H100 ظرفیت ۸۰ گیگابایت PCIE: راهنمای جامع فنی و تحلیل عملکرد
پردازنده انقلابی هوش مصنوعی
کارت گرافیک انویدیا H100 ظرفیت ۸۰ گیگابایت PCIE نمایانگر یک جهش کوانتومی در پردازش هوش مصنوعی و محاسبات با کارایی بالا است. این پردازنده گرافیکی سازمانی که بر پایه معماری نوآورانه Hopper ساخته شده، قدرت محاسباتی بیسابقهای را برای آموزش هوش مصنوعی، استنتاج، مدلهای زبانی بزرگ (LLM) و بارهای کاری محاسبات علمی ارائه میدهد.
H100 که در اکتبر 2022 منتشر شد، 80 گیگابایت حافظه HBM2e را با اتصال PCIe نسل 5 ترکیب میکند و آن را به انتخابی ایدهآل برای سازمانهایی تبدیل میکند که به دنبال استقرار زیرساخت هوش مصنوعی پیشرفته بدون نیاز به پیکربندیهای سرور تخصصی SXM5 هستند.
مشخصات کلیدی کارت گرافیک انویدیا H100 ظرفیت ۸۰ گیگابایت PCIE
| مشخصات | کارت گرافیک انویدیا H100 ظرفیت ۸۰ گیگابایت PCIE |
|---|---|
| معماری GPU | NVIDIA Hopper (GH100) |
| فرآیند ساخت | TSMC 4N (5 نانومتر) |
| تعداد ترانزیستورها | 80 میلیارد |
| اندازه تراشه | 814 میلیمتر مربع |
| هستههای CUDA | 14,592 |
| چندپردازنده جریانی (SM) | 114 |
| هستههای Tensor (نسل چهارم) | 456 |
| ظرفیت حافظه | 80GB HBM2e |
| رابط حافظه | 5120-بیتی |
| پهنای باند حافظه | 2.0 ترابایت بر ثانیه |
| کلاک پایه | 1095 مگاهرتز |
| کلاک تقویتشده | 1755 مگاهرتز |
| عملکرد FP64 | 24 تراف لاپس |
| عملکرد FP32 | 48 تراف لاپس |
| Tensor Core TF32 | 400 تراف لاپس (800 با Sparsity) |
| Tensor Core FP16/BF16 | 800 تراف لاپس (1600 با Sparsity) |
| Tensor Core FP8 | 1600 تراف لاپس (3200 با Sparsity) |
| TDP (توان مصرفی طراحی) | 350 وات (قابل تنظیم 300-350 وات) |
| فرم فکتور | دو اسلاته، PCIe Gen 5 x16 |
| کانکتور برق | 1x 16-پین PCIe |
| ابعاد | 268 میلیمتر (طول) × 111 میلیمتر (ارتفاع) |
| پشتیبانی NVLink | NVLink نسل چهارم |
| خروجیهای تصویر | ندارد (GPU محاسباتی خالص) |
معماری Hopper: انقلابی در مهندسی
چه چیزی معماری Hopper را انقلابی میکند؟
معماری NVIDIA Hopper پنج نوآوری پیشگامانه را معرفی میکند:
1. هستههای Tensor نسل چهارم
- 6 برابر سریعتر در مقایسه با A100 در بارهای کاری معادل
- 4 برابر افزایش توان عملیاتی با استفاده از فرمت دقت جدید FP8
- پشتیبانی از انواع داده FP64، FP32، TF32، FP16، BF16، FP8 و INT8
- پراکندگی شتابدهندهشده سختافزاری برای 2 برابر تقویت عملکرد در شبکههای عصبی پراکنده
2. موتور Transformer با دقت FP8
موتور Transformer انقلابی، فناوری سفارشی Tensor Core Hopper را با نرمافزار هوشمند ترکیب میکند تا:
- تا 9 برابر آموزش سریعتر هوش مصنوعی برای مدلهای زبانی بزرگ (GPT-3، BERT، T5) ارائه دهد
- تا 30 برابر استنتاج سریعتر در مدلهای تریلیون-پارامتری فراهم کند
- بهطور خودکار مقیاسبندی دقت بین FP8 و FP16 را مدیریت کند
- ردپای حافظه را 50٪ کاهش دهد در مقایسه با FP16
3. چندپردازنده جریانی (SM) پیشرفته
هر یک از 114 SM شامل:
- 128 هسته CUDA FP32 (14,592 در مجموع)
- 64 هسته FP64 در هر SM (7,296 در مجموع)
- 64 هسته INT32 در هر SM
- 4 هسته Tensor نسل چهارم در هر SM
- 256 کیلوبایت حافظه ترکیبی L1/shared (1.33 برابر بزرگتر از A100)
4. زیرسیستم حافظه پیشرفته
- حافظه 80GB HBM2e با پهنای باند 2.0 ترابایت بر ثانیه
- کش L2 به ظرفیت 50 مگابایت برای بهبود محلیسازی داده
- فناوری فشردهسازی و رفع فشردهسازی پیشرفته
- الگوهای دسترسی حافظه بهینهشده برای عملیات تانسور
5. خوشههای Thread Block
یک سلسلهمراتب برنامهنویسی جدید که امکان میدهد:
- اجرای اشتراکی در چندین SM
- حافظه مشترک توزیعشده (DSMEM) برای ارتباط مستقیم SM به SM
- 7 برابر تبادل داده سریعتر بین بلوکهای thread در مقایسه با حافظه سراسری
معیارهای عملکرد: H100 در مقابل A100
عملکرد آموزش هوش مصنوعی
| بار کاری | NVIDIA A100 | NVIDIA H100 80GB PCIe | افزایش سرعت |
|---|---|---|---|
| آموزش GPT-3 175B | خط پایه | 2.4 برابر سریعتر | 2.4x |
| آموزش BERT-Large | خط پایه | 2.2 برابر سریعتر | 2.2x |
| آموزش ResNet-50 | خط پایه | 1.8 برابر سریعتر | 1.8x |
| Mixture of Experts (395B پارامتر) | خط پایه | تا 4 برابر سریعتر | 4x |
عملکرد استنتاج هوش مصنوعی
| مدل | NVIDIA A100 | NVIDIA H100 80GB PCIe | افزایش سرعت |
|---|---|---|---|
| استنتاج Llama 2 70B | خط پایه | 1.5-2 برابر سریعتر | 1.5-2x |
| چتبات GPT-3 530B | خط پایه | تا 30 برابر سریعتر | 30x |
| Stable Diffusion XL | خط پایه | 1.6 تصویر/ثانیه | بهبود قابل توجه |
محاسبات با کارایی بالا (HPC)
| کاربرد | بهبود عملکرد |
|---|---|
| 3D FFT (4K³) | 7 برابر سریعتر از A100 |
| توالییابی ژنوم (Smith-Waterman) | 7 برابر سریعتر با دستورات DPX |
| دینامیک مولکولی | 3 برابر سریعتر |
| شبیهسازی آب و هوا | تا 3 برابر سریعتر |
ویژگیها و فناوریهای کلیدی
1. دستورات DPX برای برنامهنویسی پویا
H100 دستورات تخصصی DPX را معرفی میکند که الگوریتمهای برنامهنویسی پویا را تسریع میبخشند:
- الگوریتم Smith-Waterman برای توالییابی DNA/پروتئین: 7 برابر سریعتر
- الگوریتم Floyd-Warshall برای بهینهسازی مسیر رباتیک: 7 برابر سریعتر
- حیاتی برای ژنومیک، لجستیک و تحلیل گراف
2. رابط PCIe نسل 5
- پهنای باند دوطرفه 128 گیگابایت بر ثانیه (64 گیگابایت بر ثانیه در هر جهت)
- 2 برابر سریعتر از PCIe نسل 4
- یکپارچهسازی یکپارچه با جدیدترین CPUهای x86 و SmartNIC/DPU
- سازگاری گسترده سرور بدون نیاز به مادربوردهای تخصصی
3. NVLink نسل چهارم
- پهنای باند کل 900 گیگابایت بر ثانیه در هر GPU
- 3 برابر افزایش پهنای باند برای عملیات all-reduce
- 7 برابر سریعتر از PCIe نسل 5
- مقیاسپذیری چند GPU برای آموزش توزیعشده
4. محاسبات محرمانه (Confidential Computing)
- اولین GPU جهان با محاسبات محرمانه داخلی
- محیط اجرای قابل اعتماد (TEE) مبتنی بر سختافزار
- محافظت از دادهها و مدلها در حین محاسبه
- ضروری برای بارهای کاری حساس بهداشتی، مالی و دولتی
5. GPU چند نمونهای نسل دوم (MIG)
- تقسیمبندی یک GPU به تا 7 نمونه مجزا
- 3 برابر ظرفیت محاسباتی بیشتر در هر نمونه در مقایسه با A100
- 2 برابر پهنای باند حافظه در هر نمونه
- هر نمونه شامل واحدهای اختصاصی NVDEC و NVJPG
- پشتیبانی از محاسبات محرمانه در سطح MIG
H100 PCIe در مقابل H100 SXM5: تفاوتهای کلیدی
| ویژگی | H100 PCIe 80GB | H100 SXM5 80GB |
|---|---|---|
| فرم فکتور | PCIe Gen 5 دو اسلاته | ماژول SXM5 |
| TDP | 350 وات | 700 وات |
| چندپردازنده جریانی | 114 SM | 132 SM |
| هسته CUDA | 14,592 | 16,896 |
| هسته Tensor | 456 | 528 |
| نوع حافظه | HBM2e | HBM3 |
| پهنای باند حافظه | 2.0 ترابایت/ثانیه | 3.35 ترابایت/ثانیه |
| کلاک تقویتشده | 1755 مگاهرتز | ~1755 مگاهرتز |
| عملکرد Tensor FP8 | 1600 تراف لاپس | 2000 تراف لاپس |
| سازگاری سرور | سرورهای استاندارد PCIe | سرورهای تخصصی SXM5 |
| قیمت | 25,000-30,000 دلار | 35,000-40,000 دلار |
| موارد استفاده | استقرار انعطافپذیر، زیرساخت موجود | حداکثر عملکرد، خوشههای مقیاس بزرگ |
چه زمانی H100 PCIe را انتخاب کنیم:
- زیرساخت سرور مبتنی بر PCIe موجود
- استقرارهای با بودجه محدود
- پیکربندیهای تک نود یا چند GPU کوچک
- محیطهای مرکز داده استاندارد
چه زمانی H100 SXM5 را انتخاب کنیم:
- نیازهای حداکثر عملکرد
- خوشههای چند GPU مقیاس بزرگ (8+ GPU)
- استقرارهای سیستم سوئیچ NVLink
- بارهای کاری با بالاترین پهنای باند حافظه
کاربردهای واقعی و موارد استفاده
1. آموزش مدل زبانی بزرگ (LLM)
- مدلهای خانواده GPT-3، GPT-4، LLaMA
- مدلهای transformer BERT، T5، RoBERTa
- آموزش مدلها با صدها میلیارد پارامتر
- کاهش زمان آموزش از چند هفته به چند روز
2. هوش مصنوعی تولیدی و خلق محتوا
- تولید تصویر به سبک Stable Diffusion، DALL-E، Midjourney
- تبدیل متن به ویدیو
- ویرایش تصویر و ویدیو ریل تایم
- ابزارهای طراحی مبتنی بر هوش مصنوعی
3. استنتاج هوش مصنوعی در مقیاس بزرگ
- چتباتها و هوش مصنوعی مکالمهای (برنامههای شبیه ChatGPT)
- موتورهای توصیه محور برای تجارت الکترونیک و استریمینگ
- ترجمه در زمان واقعی و تشخیص گفتار
- کامپیوتر ویژن برای خودروهای خودران و نظارت
4. محاسبات علمی و HPC
- دینامیک سیالات محاسباتی (CFD)
- مدلسازی اقلیمی و پیشبینی آب و هوا
- شبیهسازی شیمی کوانتومی
- شبیهسازی اخترفیزیک و کیهانشناسی
5. ژنومیک و علوم زیستی
- توالییابی DNA و تاخوردگی پروتئین (AlphaFold)
- کشف دارو و داکینگ مولکولی
- تحلیل تصویربرداری پزشکی (CT، MRI، PET)
- تحقیقات سرطانی و پزشکی کاستومایز شده
6. خدمات مالی
- مدلسازی ریسک و تشخیص تقلب
- الگوریتمهای معاملات با فرکانس بالا
- بهینهسازی پورتفولیو
- امتیازدهی اعتباری با یادگیری عمیق
7. سیستمهای خودکار
- ادراک و برنامهریزی خودروی خودران
- ناوبری و دستکاری رباتیک
- سیستمهای پرواز خودکار پهپاد
- اتوماسیون صنعتی
قیمتگذاری کلاود و لوکال
قیمت خرید (مستقیم)
- قیمت خردهفروشی: 29,000 – 35,000 دلار به ازای هر GPU
- سرور 8-GPU: 300,000 – 500,000 دلار (شامل زیرساخت)
کارت گرافیک انویدیا H100 ظرفیت ۸۰ گیگابایت
قیمت اجاره GPU ابری
| ارائهدهنده ابری | نرخ ساعتی | نرخ ماهانه (24/7) |
|---|---|---|
| GMI Cloud | 2.10 دلار/ساعت | ~1,500 دلار/ماه |
| AWS (تخمینی) | 3.50-5.00 دلار/ساعت | ~2,500-3,600 دلار/ماه |
| Google Cloud | 3.00-4.50 دلار/ساعت | ~2,200-3,200 دلار/ماه |
| Microsoft Azure | 3.50-5.00 دلار/ساعت | ~2,500-3,600 دلار/ماه |
ملاحظات هزینه کل مالکیت (TCO)
- مصرف برق: 350 وات × 8 GPU = 2.8 کیلووات (سربار خنککننده اضافه شود)
- زیرساخت خنککننده: 1,000-2,000 دلار به ازای هر کیلووات سالانه
- شبکه: InfiniBand یا اترنت پرسرعت برای راهاندازی چند GPU
- ذخیرهسازی: NVMe با کارایی بالا برای دسترسی به مجموعه داده
اکوسیستم نرمافزاری و پشتیبانی فریمورک
فریمورکهای هوش مصنوعی
- PyTorch (با پشتیبانی CUDA 9.0+)
- TensorFlow (بهینهشده برای Hopper)
- JAX (فریمورک ML گوگل)
- MXNet
- ONNX Runtime
پشتیبانی نرمافزاری NVIDIA AI
- NVIDIA AI Enterprise: پلتفرم هوش مصنوعی آماده تولید با اشتراک 5 ساله
- NVIDIA NIM: میکروسرویسها برای استقرار هوش مصنوعی تولیدی
- RAPIDS: کتابخانههای علم داده شتابیافته GPU
- cuDNN: کتابخانه شبکه عصبی عمیق
- TensorRT: بهینهساز استنتاج با کارایی بالا
- سرور استنتاج Triton: سرویس استنتاج چند فریمورکی
محاسبات علمی و HPC
- CUDA Toolkit 11.8+
- OpenACC برای برنامهنویسی مبتنی بر دستورالعمل
- OpenMP offloading
- HPC-X (MPI با کارایی بالا)
- Quantum ESPRESSO، GROMACS، LAMMPS (شتابیافته)
سوالات متداول (FAQ)
1. تفاوت بین H100 PCIe و H100 SXM5 چیست؟
H100 PCIe از رابط استاندارد PCIe Gen 5 استفاده میکند (TDP 350 وات) که آن را با زیرساخت سرور موجود سازگار میکند. H100 SXM5 عملکرد بالاتری ارائه میدهد (TDP 700 وات، 132 SM، حافظه HBM3) اما نیاز به سرورهای تخصصی SXM5 دارد. PCIe انعطافپذیرتر و مقرونبهصرفهتر است؛ SXM5 حداکثر عملکرد را برای استقرارهای مقیاس بزرگ ارائه میدهد.
2. آیا H100 80GB PCIe برای بازی قابل استفاده است؟
خیر. H100 یک GPU محاسباتی خالص بدون خروجی تصویر و بدون پشتیبانی DirectX/Vulkan است. این کارت منحصراً برای آموزش هوش مصنوعی، استنتاج و محاسبات علمی طراحی شده است. برای بازی، GPUهای مصرفکننده مانند RTX 4090 یا GPUهای ایستگاه کاری حرفهای مانند RTX 6000 Ada را در نظر بگیرید.
3. کارت گرافیک انویدیا H100 در مقایسه با A100 برای آموزش هوش مصنوعی چقدر سریعتر است؟
H100 بسته به بار کاری آموزش 2-4 برابر سریعتر ارائه میدهد:
- GPT-3 175B: 2.4 برابر سریعتر
- Transformers بزرگ با FP8: تا 4 برابر سریعتر
- ResNet-50: 1.8 برابر سریعتر
- افزایش عملکرد در مدلهای مبتنی بر transformer که از موتور Transformer استفاده میکنند، بالاتر است.
4. آیا کارت گرافیک انویدیا H100 از ray tracing پشتیبانی میکند؟
خیر. کارت گرافیک انویدیا H100 هسته RT ندارد و برای رندرینگ گرافیکی یا ray tracing طراحی نشده است. این یک شتابدهنده محاسباتی خالص برای بارهای کاری هوش مصنوعی و HPC است.
5. مصرف برق و نیاز خنککننده چقدر است؟
- TDP: 350 وات (قابل تنظیم 300-350 وات)
- خنککننده: خنککننده غیرفعال یا فعال دو اسلاته (نیاز به خنککننده سازمانی)
- توصیه PSU: 750 وات+ برای سیستمهای تک GPU؛ 1200 وات+ برای چند GPU
- اطمینان از جریان هوای کافی مرکز داده و در نظر گرفتن خنککننده مایع برای استقرارهای متراکم
6. آیا میتوانم از H100 برای استنتاج LLM مانند ChatGPT استفاده کنم؟
قطعاً. H100 در استنتاج LLM عالی است:
- Llama 2 70B: استنتاج بلادرنگ با تاخیر کم
- GPT-3 530B: تا 30 برابر استنتاج سریعتر از A100
- موتور Transformer استفاده از حافظه و توان عملیاتی را بهینه میکند
- ایدهآل برای استقرار چتباتهای تولیدی، سیستمهای RAG و هوش مصنوعی مکالمهای
7. گارانتی و پشتیبانی چیست؟
- گارانتی استاندارد: 3 سال (بسته به فروشنده متفاوت است)
- NVIDIA AI Enterprise: اشتراک 5 ساله همراه با H100 NVL؛ اختیاری برای PCIe
- پشتیبانی: پشتیبانی سازمانی از طریق شرکای NVIDIA و ارائهدهندگان ابری
8. آیا H100 با کد CUDA موجود سازگار است؟
بله. H100 از CUDA 9.0+ پشتیبانی میکند و با برنامههای CUDA موجود سازگار به عقب است. با این حال، برای بهرهبرداری از ویژگیهای جدید (موتور Transformer، دستورات DPX، خوشههای Thread Block)، بهروزرسانی کد با استفاده از آخرین CUDA Toolkit توصیه میشود.
9. MIG (GPU چند نمونهای) در H100 چگونه کار میکند؟
MIG امکان تقسیمبندی H100 به تا 7 نمونه GPU مجزا را فراهم میکند که هر کدام دارای موارد اختصاصی زیر هستند:
- منابع محاسباتی (SM، Tensor Cores)
- پهنای باند حافظه
- واحدهای NVDEC/NVJPG
- TEE محاسبات محرمانه ایدهآل برای محیطهای چند مستأجره، استقرارهای Kubernetes و حداکثرسازی استفاده از GPU.
نتیجهگیری: آیا سرمایهگذاری در کارت گرافیک انویدیا H100 ارزشش را دارد؟
کارت گرافیک انویدیا H100 ظرفیت ۸۰ گیگابایت PCIE نمایانگر اوج فناوری شتابدهی هوش مصنوعی و HPC است. معماری انقلابی Hopper آن، همراه با 80 گیگابایت حافظه با پهنای باند بالا و هستههای Tensor نسل چهارم، ارائه میدهد:
- تا 6 برابر بهبود عملکرد نسبت به A100
- قابلیتهای پیشرو صنعت در آموزش و استنتاج هوش مصنوعی
- استقرار انعطافپذیر PCIe Gen 5 در زیرساخت موجود
- اکوسیستم نرمافزاری جامع (CUDA، PyTorch، TensorFlow)
- ویژگیهای قابلیت اطمینان و امنیت سازمانی
چه کسانی باید در کارت گرافیک انویدیا H100 ظرفیت ۸۰ گیگابایت PCIEسرمایهگذاری کنند؟
- مراکز تحقبقاتی هوش مصنوعی که مدلهای زبانی بزرگ را آموزش میدهند
- ارائهدهندگان خدمات ابری که GPU-as-a-Service ارائه میدهند
- شرکتها که هوش مصنوعی تولیدی را در تولید مستقر میکنند
- مراکز HPC که شبیهسازیهای مقیاس بزرگ اجرا میکنند
- شرکتهای ژنومیک و داروسازی که تحقیقات را تسریع میبخشند
بازگشت سرمایه (ROI):
در حالی که قیمت 28,000-35,000 دلاری قابل توجه است، کارت گرافیک انویدیا H100 میتواند:
- زمان آموزش هوش مصنوعی را 50-75٪ کاهش دهد، زمان عرضه به بازار را تسریع کند
- هزینههای عملیاتی را کاهش دهد از طریق بهبود کارایی انرژی (عملکرد به ازای هر وات)
- جریانهای درآمد جدید را فعال کند از طریق توسعه و استقرار سریعتر مدل
- زیرساخت را برای 3-5 سال آینده پیشرفت هوش مصنوعی آماده آینده کند
برای سازمانهایی که در مورد هوش مصنوعی و مزیت محاسباتی جدی هستند، کارت گرافیک انویدیا H100 یک سرمایهگذاری ضروری است.
محصولات مرتبط
نقد و بررسیها
پاککردن فیلترهاهنوز بررسیای ثبت نشده است.