
مقالات و اخبار تکنولوژی
ایستگاه کاری Soika 4×H100: ابررایانه میزی برای پردازش هوش مصنوعی


در دنیای پیشرفته هوش مصنوعی و یادگیری عمیق، تفاوت بین موفقیت و شکست اغلب در توان پردازشی سختافزار نهفته است. ایستگاههای کاری مجهز به پردازندههای گرافیکی قدرتمند دیگر صرفاً ابزاری برای محققان و متخصصان نیستند، بلکه به زیرساخت ضروری برای هر سازمانی برای پردازش هوش مصنوعی تبدیل شدهاند که میخواهد در عصر هوش مصنوعی پیشرو باشد. در این میان، ایستگاه کاری Soika 4×H100 به عنوان یک ابررایانه میزی، استانداردهای جدیدی را در صنعت تعریف میکند و تواناییهایی فراهم میآورد که تا همین اواخر تنها در مراکز داده بزرگ در دسترس بود.
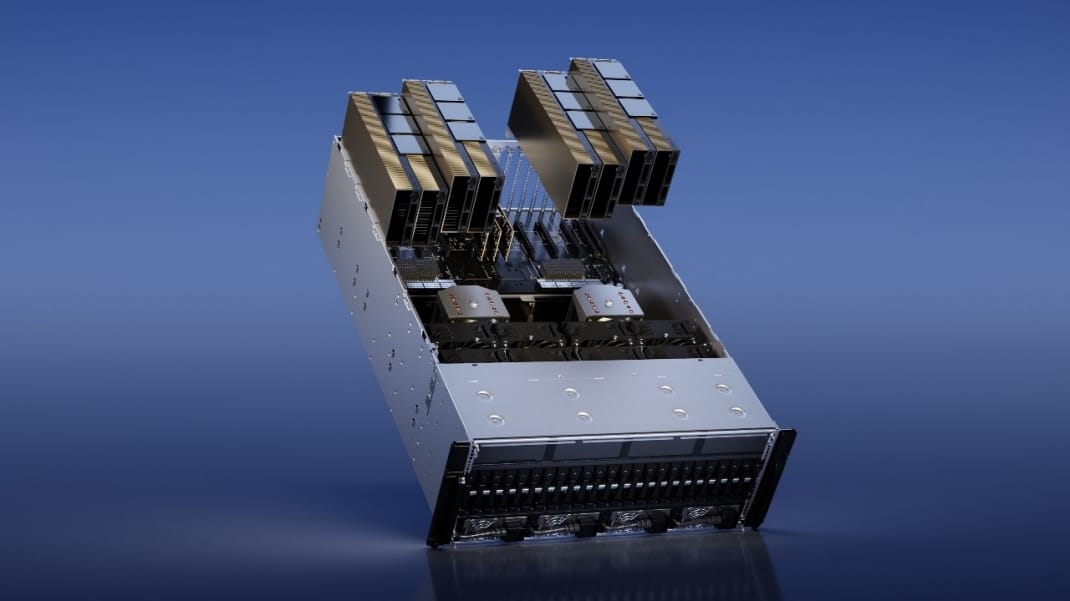
پردازش هوش مصنوعی
این ایستگاه کاری که حول محور چهار واحد پردازش گرافیکی NVIDIA H100 طراحی شده، نه تنها قدرت محاسباتی بینظیری ارائه میدهد، بلکه رویکردی کاملاً متفاوت به پردازش دادههای پیچیده و آموزش مدلهای زبانی بزرگ ارائه میکند. در این مقاله جامع، به بررسی دقیق مشخصات فنی، کاربردهای عملی و مزایای رقابتی این ایستگاه کاری میپردازیم و نشان میدهیم چگونه این سیستم میتواند تحولی اساسی در نحوه کار با هوش مصنوعی ایجاد کند.
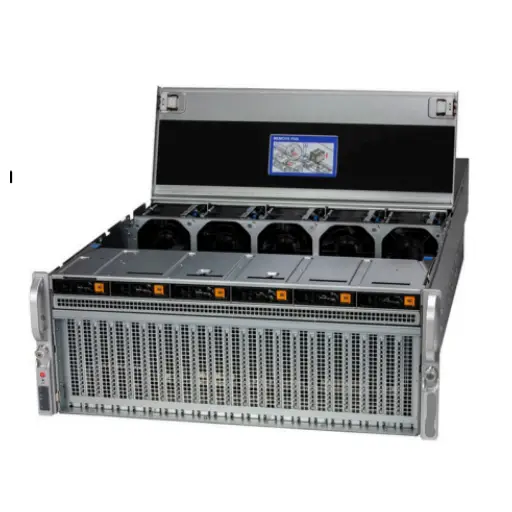
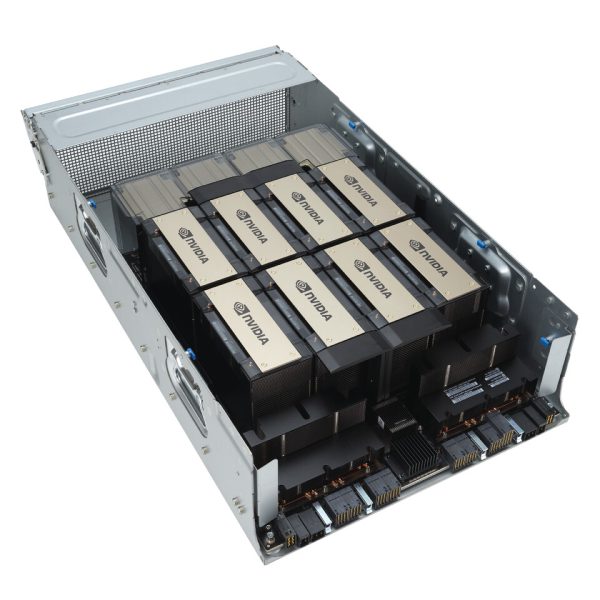
معماری Hopper و انقلاب پردازش هوش مصنوعی موازی
یکی از مهمترین ویژگیهای ایستگاه کاری Soika 4×H100 استفاده از معماری نسل جدید Hopper در پردازندههای گرافیکی NVIDIA H100 است. این معماری که در سال ۲۰۲۲ معرفی شد، نمایانگر یک جهش کیفی در طراحی پردازندههای گرافیکی برای کاربردهای هوش مصنوعی است. برخلاف نسلهای قبلی که عمدتاً بر افزایش تعداد هستههای پردازشی متمرکز بودند، معماری Hopper با معرفی قابلیتهایی مانند Transformer Engine و پشتیبانی از دقت FP8، رویکردی هوشمندانهتر به بهینهسازی عملکرد در حوزه یادگیری عمیق اتخاذ کرده است.
هسته تنسور نسل چهارم در H100 میتواند عملیات ماتریسی را با دقتهای مختلف از FP64 تا FP8 انجام دهد و این تنوع امکان بهینهسازی دقیق بار کاری را بر اساس نیازهای خاص هر پروژه فراهم میکند. برای مثال، در آموزش مدلهای زبانی بزرگ که نیاز به دقت بالایی دارند، میتوان از دقتهای بالاتر استفاده کرد، در حالی که برای استنتاج سریع مدلها، دقت FP8 با سرعتی ۹ برابر سریعتر از نسل قبل، عملکرد استثنایی ارائه میدهد. این انعطافپذیری به معنای این است که یک ایستگاه کاری میتواند بهطور همزمان پاسخگوی نیازهای متنوع پروژههای مختلف باشد.
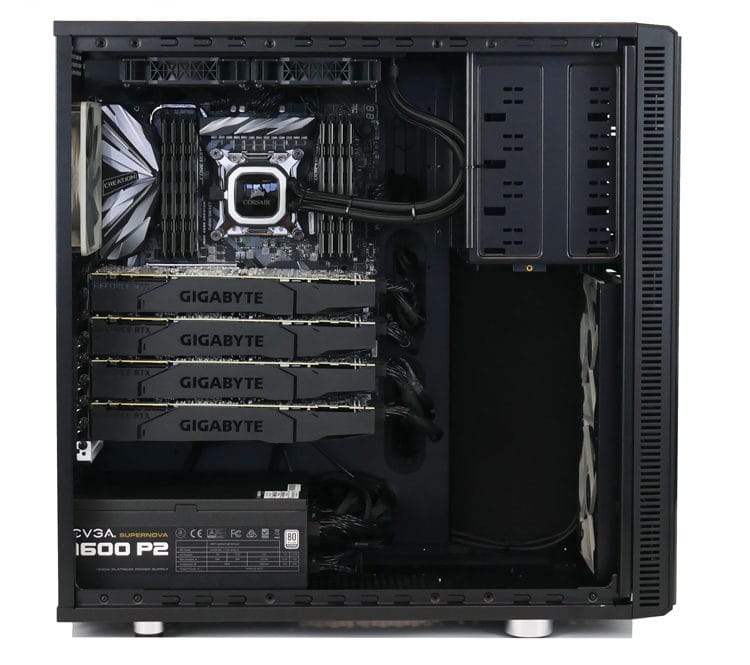
یکی از نوآوریهای کلیدی در معماری Hopper، Transformer Engine است که بهطور خاص برای تسریع آموزش و استنتاج مدلهای مبتنی بر معماری Transformer طراحی شده است. این موتور بهطور خودکار دقت محاسبات را در طول فرآیند آموزش تنظیم میکند و بدون نیاز به دخالت دستی برنامهنویس، بهینهترین تعادل بین سرعت و دقت را برقرار میسازد. این قابلیت بهویژه برای مدلهای زبانی بزرگ مانند GPT، BERT و Claude که دارای میلیاردها پارامتر هستند، اهمیت حیاتی دارد و میتواند زمان آموزش را تا ۳۰ درصد کاهش دهد.
قدرت پردازش هوش مصنوعی بینظیر با چهار H100
وقتی صحبت از ایستگاه کاری Soika 4×H100 میشود، باید از یک قدرت محاسباتی فوقالعاده سخن بگوییم که تا پیش از این تنها در اختیار مراکز داده سازمانی بود. هر پردازنده H100 بهتنهایی میتواند عملکرد تئوری ۹۸۹ ترافلاپ در دقت TF32 و ۳۹۵۸ ترافلاپ در دقت FP8 را ارائه دهد. با ترکیب چهار واحد این پردازنده در یک ایستگاه کاری، سیستم Soika قادر است عملیات محاسباتی معادل ۱۶ پتافلاپ در دقت FP8 را انجام دهد که این رقم برای بسیاری از کاربردهای پیشرفته هوش مصنوعی کاملاً کافی و حتی بیش از حد است.
این قدرت محاسباتی عظیم به این معنا است که پژوهشگران و متخصصان داده میتوانند مدلهای پیچیدهای را که قبلاً نیاز به روزها یا حتی هفتهها زمان پردازش داشتند، در عرض چند ساعت آموزش دهند. برای درک بهتر این موضوع، تصور کنید میخواهید یک مدل زبانی با ۷۰ میلیارد پارامتر را آموزش دهید. در یک سیستم مبتنی بر GPU نسل قبل، این کار ممکن است چندین هفته زمان ببرد، اما در ایستگاه Soika 4×H100، همین کار را میتوان در کمتر از یک هفته انجام داد. این تفاوت زمانی میتواند تأثیر مستقیمی بر سرعت نوآوری و توسعه محصول در یک سازمان داشته باشد.
علاوه بر سرعت محاسباتی، حافظه HBM3 با ظرفیت ۸۰ گیگابایت در هر H100 و پهنای باند کلی ۳.۳۵ ترابایت بر ثانیه، امکان پردازش مجموعه دادههای عظیم را بدون نیاز به تبادل مکرر دادهها با حافظه اصلی فراهم میکند. در یک پیکربندی چهار GPU، این سیستم دسترسی به ۳۲۰ گیگابایت حافظه اختصاصی GPU دارد که برای آموزش مدلهای بزرگ و پردازش مجموعه دادههای چند میلیون رکوردی کاملاً مناسب است. این ظرفیت حافظه بالا به معنای این است که میتوانید مدلهای پیچیدهتری را بدون نگرانی از محدودیت حافظه طراحی کنید و از تکنیکهای پیشرفتهتری مانند Gradient Accumulation با بچهای بزرگتر استفاده نمایید.
مشخصات سختافزاری پیشرفته
برای دستیابی به عملکرد بهینه از چهار پردازنده H100، ایستگاه کاری Soika نیازمند یک پلتفرم سختافزاری قدرتمند است که بتواند از پتانسیل کامل این پردازندهها بهره ببرد. در قلب این سیستم، دو پردازنده Intel Xeon w9-3595X با مجموع ۱۲۰ هسته و ۲۴۰ رشته قرار دارد که توانایی مدیریت همزمان بارهای کاری پیچیده CPU را دارند. این پردازندهها نه تنها باید خطوط PCIe کافی برای اتصال چهار GPU فراهم کنند، بلکه باید قادر به پردازش وظایف مکمل مانند پیشپردازش داده، مدیریت حافظه و هماهنگی بین GPUها باشند.
| مشخصات | جزئیات |
|---|---|
| پردازنده مرکزی | دو عدد Intel Xeon w9-3595X (۱۲۰ هسته، ۲۴۰ رشته) |
| پردازنده گرافیکی | چهار عدد NVIDIA H100 80GB |
| حافظه رم | ۵۱۲ گیگابایت DDR5-4800 ECC RDIMM |
| فضای ذخیرهسازی | ۳۲ ترابایت NVMe (۴×۸TB) |
| حافظه GPU | ۳۲۰ گیگابایت HBM3 (مجموع) |
| پهنای باند حافظه GPU | ۱۳.۴ ترابایت/ثانیه (مجموع) |
| توان مصرفی هر GPU | تا ۷۰۰ وات (قابل تنظیم) |
| اتصال GPU | NVLink با پهنای باند ۶۰۰ گیگابایت/ثانیه |
| اتصال PCIe | Gen5 با پهنای باند ۱۲۸ گیگابایت/ثانیه |
حافظه رم ECC با ظرفیت ۵۱۲ گیگابایت و تکنولوژی DDR5-4800، پایگاهی پایدار برای عملیات حساس فراهم میکند و از صحت دادهها در طول پردازشهای طولانی مدت اطمینان میدهد. تکنولوژی ECC (Error-Correcting Code) بهطور خودکار خطاهای حافظه را شناسایی و تصحیح میکند که این امر برای محاسبات علمی و آموزش مدلهای هوش مصنوعی که ممکن است روزها طول بکشند، حیاتی است. یک خطای کوچک حافظه میتواند باعث شود که یک فرآیند آموزش چند روزه از ابتدا دوباره آغاز شود، بنابراین حافظه ECC یک سرمایهگذاری ضروری برای حفظ قابلیت اطمینان سیستم است.
فضای ذخیرهسازی NVMe با ظرفیت ۳۲ ترابایت که از چهار درایو ۸ ترابایتی تشکیل شده، نه تنها فضای کافی برای ذخیره مجموعه دادههای عظیم را فراهم میکند، بلکه با سرعت خواندن و نوشتن بالای خود، گلوگاه انتقال داده بین دیسک و حافظه را به حداقل میرساند. در پروژههای یادگیری عمیق که نیاز به بارگذاری مکرر دادهها در طول آموزش دارند، این سرعت بالا میتواند تفاوت قابلتوجهی در زمان کلی آموزش ایجاد کند. بهعلاوه، امکان پیکربندی این درایوها در آرایه RAID میتواند هم سرعت و هم امنیت داده را بیشتر افزایش دهد.
اتصال و ارتباط بین پردازندهها
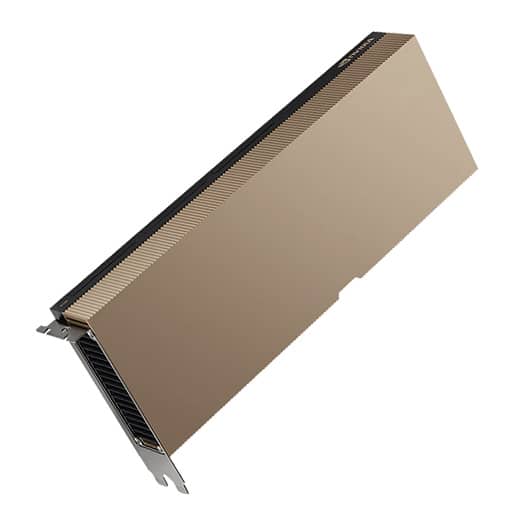
یکی از چالشهای اساسی در طراحی سیستمهای چند GPU، برقراری ارتباط سریع و کارآمد بین پردازندههای گرافیکی است. در بسیاری از بارهای کاری یادگیری عمیق، GPUها نیاز دارند که بهطور مکرر اطلاعات Gradient و وزنهای مدل را با یکدیگر به اشتراک بگذارند، و هرگونه تأخیر در این ارتباط میتواند بهشدت بر کارایی کلی سیستم تأثیر بگذارد. ایستگاه کاری Soika 4×H100 از تکنولوژی NVLink نسل جدید استفاده میکند که پهنای باند ۶۰۰ گیگابایت بر ثانیه را برای هر GPU فراهم میآورد و این رقم تقریباً ۵ برابر سریعتر از ارتباط استاندارد PCIe Gen5 است.
این پهنای باند بالا به این معنا است که GPUها میتوانند بهطور همزمان روی بخشهای مختلف یک مدل بزرگ کار کنند و بهطور مؤثر یک پردازنده گرافیکی منطقی با قدرت محاسباتی چهار برابری و حافظه چهار برابری ایجاد کنند. این قابلیت که به آن Model Parallelism میگویند، برای آموزش مدلهای بسیار بزرگی که در حافظه یک GPU جا نمیشوند، ضروری است. برای مثال، یک مدل زبانی با ۱۷۵ میلیارد پارامتر مانند GPT-3 نمیتواند در حافظه یک GPU قرار گیرد، اما با استفاده از NVLink و توزیع لایههای مختلف مدل بین چهار H100، میتوان چنین مدلی را بهطور مؤثر آموزش داد.
علاوه بر NVLink، پشتیبانی از PCIe نسل پنجم با پهنای باند ۱۲۸ گیگابایت بر ثانیه برای هر GPU، امکان انتقال سریع دادهها بین CPU و GPU را فراهم میکند. این امر بهویژه برای مراحل اولیه بارگذاری داده و پیشپردازش که معمولاً توسط CPU انجام میشود، اهمیت دارد. پهنای باند بالای PCIe Gen5 تضمین میکند که GPUها زمان زیادی را منتظر دریافت داده از CPU نمیمانند و میتوانند بیشتر وقت خود را صرف انجام محاسبات مفید کنند. در نتیجه، بهرهوری کلی سیستم افزایش مییابد و زمان صرف شده برای آموزش مدلها کاهش پیدا میکند.

کاربردهای تخصصی در صنایع مختلف
یکی از جنبههای بسیار مهم ایستگاه کاری Soika 4×H100، تنوع و گستردگی کاربردهای آن در صنایع مختلف است. در حوزه پزشکی و سلامت، این سیستم میتواند برای آموزش مدلهای پیشرفته تشخیص بیماری از تصاویر رادیولوژی، تحلیل ژنومیک برای پزشکی شخصیسازیشده، و حتی کشف داروهای جدید از طریق شبیهسازی مولکولی استفاده شود. مدلهای یادگیری عمیق آموزش دیده بر روی میلیونها تصویر پزشکی میتوانند الگوهایی را شناسایی کنند که حتی برای چشم متخصصان باتجربه قابل مشاهده نیستند، و این امر میتواند به تشخیص زودهنگام بیماریهایی مانند سرطان کمک کند.
در صنعت مالی، قدرت پردازشی H100 برای تحلیل دادههای مالی پیچیده، پیشبینی روند بازار، شناسایی کلاهبرداریهای مالی و ارزیابی ریسک بهکار میرود. مدلهای یادگیری ماشین میتوانند الگوهای معاملاتی مشکوک را در میلیونها تراکنش روزانه شناسایی کنند و بهطور خودکار آنها را برای بررسی بیشتر علامتگذاری کنند. همچنین، مدلهای پیشبینی مبتنی بر یادگیری عمیق میتوانند با تحلیل دادههای تاریخی، اخبار، و حتی احساسات شبکههای اجتماعی، پیشبینیهای دقیقتری از روندهای بازار ارائه دهند که این امر میتواند تصمیمگیری سرمایهگذاران و مدیران را بهبود بخشد.

در حوزه خودروهای خودران و رباتیک، ایستگاه کاری Soika میتواند برای آموزش مدلهای پیچیده درک محیط، برنامهریزی مسیر و تصمیمگیری در زمان واقعی استفاده شود. سیستمهای خودران نیاز دارند که بهطور همزمان دادههای دوربین، لیدار، رادار و حسگرهای دیگر را پردازش کنند و در عرض میلیثانیه تصمیمات حیاتی بگیرند. آموزش چنین مدلهایی نیاز به پردازش مجموعه دادههای عظیمی از سناریوهای مختلف رانندگی دارد که بدون قدرت محاسباتی سیستمهای چند GPU عملی نیست. با استفاده از ایستگاه Soika، شرکتهای توسعهدهنده خودروهای خودران میتوانند چرخه توسعه خود را تسریع کنند و به سرعت نسخههای بهبود یافته الگوریتمهای خود را آزمایش نمایند.
در صنعت تجارت الکترونیک و بازاریابی، مدلهای هوش مصنوعی برای سیستمهای توصیه شخصیسازیشده، تحلیل احساسات مشتریان، پیشبینی رفتار خرید و بهینهسازی زنجیره تأمین استفاده میشوند. یک فروشگاه آنلاین بزرگ ممکن است میلیونها مشتری و میلیاردها نقطه داده تعامل داشته باشد، و تحلیل این حجم از دادهها برای ارائه توصیههای دقیق و بهموقع نیاز به قدرت پردازشی قابلتوجهی دارد. با استفاده از ایستگاه کاری Soika، شرکتها میتوانند مدلهای پیچیدهتری را آموزش دهند که نه تنها به تاریخچه خرید، بلکه به الگوهای مرور، دادههای جمعیتشناختی و حتی روندهای فصلی نیز توجه میکنند.
مقایسه با راهکارهای ابری و مراکز داده
یکی از سؤالات مهمی که سازمانها هنگام تصمیمگیری برای سرمایهگذاری در زیرساخت هوش مصنوعی با آن مواجه میشوند، این است که آیا باید یک ایستگاه کاری اختصاصی خریداری کنند یا از خدمات ابری GPU استفاده نمایند. هر دو رویکرد مزایا و معایب خاص خود را دارند و انتخاب بهینه بستگی به نیازها و شرایط خاص هر سازمان دارد. خدمات ابری GPU مانند Google Cloud، AWS و Azure انعطافپذیری بالایی ارائه میدهند و امکان مقیاسپذیری سریع بدون نیاز به سرمایهگذاری اولیه بالا را فراهم میکنند. برای پروژههای کوتاهمدت یا آزمایشی که نیاز به منابع محاسباتی فشرده برای مدت محدودی دارند، استفاده از خدمات ابری میتواند گزینه اقتصادیتری باشد.
با این حال، برای سازمانهایی که بهطور مداوم نیاز به پردازش حجم زیادی از دادهها و آموزش مدلهای متعدد دارند، مالکیت یک ایستگاه کاری اختصاصی مانند Soika 4×H100 میتواند در بلندمدت مقرونبهصرفهتر باشد. هزینه اجاره یک سرور مجهز به چهار H100 در خدمات ابری میتواند به سرعت به رقمهای قابلتوجهی برسد، بهطوری که در عرض یک تا دو سال، هزینه کل اجاره ممکن است از هزینه خرید یک سیستم اختصاصی فراتر رود. علاوه بر این، داشتن زیرساخت اختصاصی به سازمانها کنترل کامل بر دادههای حساس خود میدهد و نگرانیهای امنیتی مرتبط با ارسال دادهها به سرویسهای ابری را کاهش میدهد.
یکی دیگر از مزایای مهم ایستگاه کاری اختصاصی، عدم وابستگی به اتصال اینترنت و کاهش تأخیرهای ناشی از انتقال داده است. در پروژههای بزرگ که نیاز به انتقال تعداد زیادی فایل بزرگ بین محیط محلی و سرویس ابری دارند، پهنای باند اینترنت میتواند به یک گلوگاه جدی تبدیل شود. حتی با اتصال اینترنت پرسرعت، انتقال چندین ترابایت داده میتواند ساعتها طول بکشد، در حالی که در یک سیستم محلی، همین دادهها میتوانند در عرض دقایق منتقل شوند. این تفاوت میتواند تأثیر قابلتوجهی بر سرعت چرخه توسعه و زمان رسیدن به بازار داشته باشد. بهعلاوه، برای سازمانهایی که در مناطقی با دسترسی محدود به اینترنت پرسرعت قرار دارند، داشتن زیرساخت محلی تقریباً یک ضرورت است.
بهینهسازی مصرف انرژی و مدیریت حرارت
یکی از چالشهای اساسی در طراحی و بهرهبرداری از سیستمهای چند GPU قدرتمند، مدیریت مصرف انرژی و تولید گرمای قابلتوجه است. هر پردازنده H100 میتواند تا ۷۰۰ وات توان مصرف کند، که این به معنای توان مصرفی کل تا ۲۸۰۰ وات فقط برای GPUها است، بدون احتساب پردازنده مرکزی، حافظه و سایر اجزا. در نتیجه، یک سیستم کامل Soika 4×H100 ممکن است توان کلی بیش از ۳۵۰۰ وات را مصرف کند که این رقم معادل مصرف انرژی یک آپارتمان کوچک است. این میزان مصرف انرژی نه تنها هزینههای عملیاتی را افزایش میدهد، بلکه چالشهای جدی در زمینه تأمین برق و سیستم خنککاری ایجاد میکند.
برای مدیریت مؤثر این مصرف انرژی، ایستگاه کاری Soika از سیستمهای خنککاری پیشرفته استفاده میکند که ممکن است شامل ترکیبی از خنککاری هوایی با فنهای قدرتمند و خنککاری مایع برای اجزای حساس باشد. خنککاری مایع بهویژه برای GPUها و پردازندههای مرکزی که بیشترین گرما را تولید میکنند، بسیار مؤثر است و میتواند دمای سیستم را تا ۲۰ درجه سانتیگراد کاهش دهد. این کاهش دما نه تنها به حفظ عملکرد بهینه سیستم کمک میکند، بلکه طول عمر اجزا را نیز افزایش میدهد و احتمال خرابی را کاهش میدهد. در محیطهای حرفهای، سرمایهگذاری در سیستم خنککاری مناسب میتواند در بلندمدت صرفهجویی قابلتوجهی در هزینههای تعمیر و نگهداری ایجاد کند.
علاوه بر سیستم خنککاری، GPUهای H100 دارای قابلیتهای هوشمند مدیریت توان هستند که میتوانند مصرف انرژی را بر اساس بار کاری واقعی تنظیم کنند. به عنوان مثال، زمانی که GPU در حال انجام محاسبات سبک است یا در حالت آمادهباش قرار دارد، بهطور خودکار فرکانس کاری و ولتاژ خود را کاهش میدهد تا انرژی کمتری مصرف کند. این قابلیت که به آن Dynamic Power Management میگویند، میتواند مصرف انرژی کل را تا ۳۰ درصد کاهش دهد، بهویژه در سناریوهایی که سیستم بهطور مداوم در حداکثر ظرفیت خود کار نمیکند. برای سازمانهایی که دغدغههای زیستمحیطی دارند یا میخواهند هزینههای انرژی را کاهش دهند، این ویژگی بسیار ارزشمند است.
پلتفرم نرمافزاری و پشتیبانی از چارچوبهای یادگیری عمیق
یکی از نکات کلیدی که موفقیت یک ایستگاه کاری هوش مصنوعی را تضمین میکند، پشتیبانی جامع از پلتفرمهای نرمافزاری و چارچوبهای یادگیری عمیق است. ایستگاه کاری Soika 4×H100 با سیستم عامل Ubuntu که یکی از محبوبترین توزیعهای لینوکس در میان جامعه علمی و توسعهدهندگان است، عرضه میشود. این انتخاب تصادفی نیست، چرا که اکثر ابزارها و کتابخانههای یادگیری عمیق برای محیط لینوکس بهینه شدهاند و عملکرد بهتری نسبت به سیستمهای عامل دیگر ارائه میدهند. Ubuntu همچنین دسترسی آسان به مخازن بزرگی از بستههای نرمافزاری علمی و ابزارهای توسعه را فراهم میکند که نصب و پیکربندی محیط کاری را تسهیل مینماید.
علاوه بر سیستم عامل، این ایستگاه کاری با پلتفرمهای اختصاصی Soika Stack و Soika Mockingjay ارائه میشود که راهحلهای یکپارچهای برای مدیریت خوشههای GPU و توسعه عاملهای هوش مصنوعی فراهم میکنند. Soika Stack بهطور خاص برای سادهسازی پیچیدگیهای راهاندازی و مدیریت زیرساختهای یادگیری عمیق طراحی شده است و شامل ابزارهایی برای کلاسترسازی GPU، تنظیم مدلهای زبانی بزرگ، عملیات همزمان چندین مدل و Fine-tuning است. این پلتفرم به کاربران اجازه میدهد که بدون نگرانی از جزئیات فنی پیچیده زیرساخت، روی توسعه و بهبود مدلهای خود تمرکز کنند.
از سوی دیگر، GPUهای H100 بهطور کامل با تمام چارچوبهای محبوب یادگیری عمیق مانند TensorFlow، PyTorch، Keras، MXNet و JAX سازگار هستند. این چارچوبها از قابلیتهای پیشرفته H100 مانند Tensor Cores نسل چهارم و Transformer Engine بهصورت بومی پشتیبانی میکنند و میتوانند بهطور خودکار از بهینهسازیهای سختافزاری بهره ببرند. برای مثال، PyTorch 2.0 و نسخههای بالاتر میتوانند بهطور خودکار دقت محاسبات را بین FP32، FP16 و FP8 تغییر دهند تا بهینهترین تعادل بین سرعت و دقت را بر اساس نوع عملیات به دست آورند. این سازگاری کامل به این معنا است که توسعهدهندگان میتوانند کد موجود خود را با تغییرات بسیار کم روی ایستگاه Soika اجرا کنند و فوراً از افزایش قابلتوجه سرعت بهرهمند شوند.
امنیت و محاسبات محرمانه
در دنیای امروز که نگرانیهای امنیتی و حریم خصوصی دادهها به یکی از اولویتهای اصلی سازمانها تبدیل شده است، ویژگیهای امنیتی سختافزار نیز اهمیت بسیاری یافتهاند. یکی از قابلیتهای برجسته GPUهای H100، پشتیبانی از Confidential Computing است که امکان پردازش دادههای حساس را در یک محیط امن و ایزوله فراهم میکند. این تکنولوژی با استفاده از رمزنگاری سختافزاری، دادهها را حتی در حین پردازش در حافظه GPU محافظت میکند و از دسترسی غیرمجاز به آنها جلوگیری مینماید. این قابلیت بهویژه برای صنایعی مانند بانکداری، بهداشت و درمان و دولتی که با دادههای بسیار حساس سر و کار دارند، حیاتی است.
با استفاده از Confidential Computing، سازمانها میتوانند حتی در محیطهای مشترک یا ابری، اطمینان داشته باشند که دادههای آنها در برابر تهدیدات داخلی و خارجی محافظت میشوند. برای مثال، یک بیمارستان میتواند دادههای پزشکی بیماران را برای آموزش مدلهای تشخیص بیماری استفاده کند، بدون اینکه نگران افشای اطلاعات شخصی بیماران باشد. GPU رمزنگاری لایهای فراهم میکند که حتی در صورت نفوذ به سیستم، مهاجم نمیتواند به دادههای واقعی دسترسی پیدا کند. این سطح از امنیت میتواند به سازمانها کمک کند تا الزامات قانونی مربوط به حفاظت از دادهها مانند GDPR و HIPAA را رعایت کنند.
علاوه بر Confidential Computing، ایستگاه کاری Soika با استفاده از حافظه ECC، لایه دیگری از حفاظت در برابر خطاهای داده فراهم میکند. این تکنولوژی نه تنها خطاهای تصادفی حافظه را تصحیح میکند، بلکه میتواند از حملات خاصی که سعی در تغییر عمدی محتوای حافظه دارند نیز محافظت کند. ترکیب این ویژگیهای امنیتی با سیاستهای دسترسی قوی و رمزنگاری دیسک، یک محیط امن و قابل اعتماد برای پردازش دادههای حساس ایجاد میکند. سازمانها میتوانند با خیال راحت پروژههای مهم خود را روی این پلتفرم اجرا کنند و اطمینان داشته باشند که دادههای آنها در سطح سازمانی محافظت میشوند.
قابلیت Multi-Instance GPU و بهینهسازی منابع
یکی از چالشهای رایج در محیطهای چند کاربره یا پروژههای متعدد، تخصیص بهینه منابع GPU به کارهای مختلف است. در گذشته، یک GPU یا کاملاً به یک وظیفه اختصاص مییافت یا باید بین چندین وظیفه به اشتراک گذاشته میشد که هر دو حالت میتوانستند منجر به عدم بهرهوری شوند. قابلیت Multi-Instance GPU یا MIG در H100 این مشکل را با اجازه دادن به تقسیم یک GPU فیزیکی به تا ۷ نمونه منطقی مجزا حل میکند. هر نمونه MIG دارای منابع اختصاصی خود شامل هستههای محاسباتی، حافظه و باندویدث حافظه است و میتواند بهطور مستقل به یک کاربر یا وظیفه اختصاص یابد.
این قابلیت امکان استفاده همزمان از یک GPU توسط چندین کاربر یا پروژه را بدون تداخل یا کاهش عملکرد فراهم میکند. برای مثال، در یک محیط دانشگاهی یا تحقیقاتی که چندین پژوهشگر نیاز به دسترسی به منابع GPU دارند، میتوان یک H100 را به هفت نمونه ۱۸ گیگابایتی تقسیم کرد و هر نمونه را به یک پژوهشگر اختصاص داد. هر پژوهشگر احساس میکند که یک GPU اختصاصی دارد و کار سایر پژوهشگران هیچ تأثیری بر عملکرد او ندارد. این امر نه تنها بهرهوری منابع را افزایش میدهد، بلکه امنیت و ایزولاسیون بین پروژههای مختلف را نیز تضمین میکند.
در سطح سازمانی، MIG میتواند برای اجرای چندین مدل استنتاج بهصورت همزمان یا برای آزمایش و توسعه موازی چندین نسخه از یک مدل استفاده شود. برای مثال، یک شرکت میتواند یک نمونه بزرگ MIG را برای آموزش مدلهای جدید، و چندین نمونه کوچکتر را برای ارائه خدمات استنتاج به کاربران نهایی اختصاص دهد. این انعطافپذیری به سازمانها اجازه میدهد که منابع GPU گرانقیمت خود را بهطور بهینه استفاده کنند و بازگشت سرمایه خود را افزایش دهند. در ایستگاه کاری Soika با چهار H100، این به معنای توانایی ایجاد تا ۲۸ نمونه MIG مستقل است که میتواند نیازهای بسیار متنوعی را پوشش دهد.
پشتیبانی و گارانتی
یکی از جنبههای مهمی که هنگام سرمایهگذاری در زیرساختهای گرانقیمت باید به آن توجه کرد، کیفیت پشتیبانی و شرایط گارانتی است. ایستگاه کاری Soika 4×H100 با گارانتی سهساله برای قطعات و خدمات فنی زنده ارائه میشود که این امر اطمینان خاطری برای سرمایهگذاری قابلتوجه در این سیستم فراهم میکند. این گارانتی شامل پشتیبانی فنی تخصصی برای هر گونه مشکل نرمافزاری یا سختافزاری است و تیم پشتیبانی آماده است تا در صورت بروز هر گونه مشکل، راهنماییهای لازم را ارائه دهد. اگرچه سرویس On-site در بسته استاندارد گنجانده نشده، اما امکان ارتقا به سطوح بالاتر پشتیبانی که شامل بازدید فیزیکی و SLA مشخص میشود، وجود دارد.
علاوه بر گارانتی سختافزار، Soika پشتیبانی جامعی برای نرمافزارهای خود از جمله Soika Stack و Soika Mockingjay ارائه میدهد که شامل بهروزرسانیهای منظم، رفع اشکال و اضافه شدن ویژگیهای جدید است. این پشتیبانی نرمافزاری برای اطمینان از سازگاری با جدیدترین چارچوبهای یادگیری عمیق و فناوریهای نوظهور بسیار حیاتی است. دنیای هوش مصنوعی بهسرعت در حال تغییر است و ابزارها و کتابخانههای جدید بهطور مداوم منتشر میشوند، بنابراین داشتن یک تیم پشتیبانی که میتواند در مورد بهترین شیوهها و راهحلهای نوین مشاوره دهد، ارزش زیادی دارد.
برای سازمانهایی که نیاز به SLA مشخص یا پشتیبانی سریعتر دارند، بستههای پشتیبانی سفارشی نیز در دسترس است که میتواند شامل زمان پاسخ تضمینشده، دسترسی به مهندسان ارشد و حتی خدمات مشاورهای برای بهینهسازی بارهای کاری خاص باشد. این سطح از پشتیبانی میتواند برای سازمانهایی که زیرساختهای هوش مصنوعی آنها در مرکز عملیات کسبوکارشان قرار دارد و هرگونه خرابی میتواند بهطور مستقیم بر درآمد تأثیر بگذارد، ضروری باشد. سرمایهگذاری در پشتیبانی با کیفیت میتواند در بلندمدت صرفهجویی قابلتوجهی در هزینههای توقف سیستم و از دست رفتن بهرهوری ایجاد کند.
کتابخانه مدلهای هوش مصنوعی
یکی از مزایای ویژه ایستگاه کاری Soika، دسترسی به کتابخانه گستردهای از بیش از ۲۰۰ مدل منبع باز و تخصصیشده هوش مصنوعی است که برای کاربردهای مختلف بهینهسازی شدهاند. این کتابخانه شامل مدلهای زبانی پیشرفتهای مانند Qwen، Grok، DeepSeek، Mistral و Claude AI است که هر کدام برای کاربردهای خاصی طراحی شدهاند. برای مثال، مدلهای Qwen برای پردازش زبانهای چند زبانه بهینه شدهاند و میتوانند بهطور همزمان متنهای انگلیسی، چینی و زبانهای دیگر را پردازش کنند، در حالی که مدلهای DeepSeek بر استدلال ریاضی و کدنویسی تمرکز دارند.
علاوه بر مدلهای زبانی عمومی، این کتابخانه شامل مدلهای تخصصی برای حوزههای خاص نیز هست. MONAI و Meditron مدلهایی هستند که بهطور خاص برای تحلیل تصاویر پزشکی و کاربردهای بهداشتی آموزش دیدهاند و میتوانند در تشخیص بیماریها، برنامهریزی درمان و تحلیل دادههای بالینی به کار روند. OpenCV که کتابخانه معروف بینایی کامپیوتر است، برای پردازش تصویر و ویدئو بهینهسازی شده و میتواند در برنامههای شناسایی اشیا، تشخیص چهره و ردیابی حرکت استفاده شود. این تنوع مدلها به کاربران امکان میدهد که به سرعت پروژههای خود را آغاز کنند بدون اینکه نیاز باشد از ابتدا یک مدل را آموزش دهند.
دسترسی به این کتابخانه گسترده میتواند زمان توسعه را بهطور قابلتوجهی کاهش دهد و به سازمانها اجازه میدهد که سریعتر محصولات و خدمات مبتنی بر هوش مصنوعی خود را به بازار عرضه کنند. به جای صرف هفتهها یا ماهها برای جمعآوری داده، آموزش و تنظیم یک مدل از ابتدا، توسعهدهندگان میتوانند با یک مدل از پیش آموزشدیده شروع کنند و تنها با Fine-tuning روی دادههای خاص خود، به نتایج مطلوب برسند. این رویکرد Transfer Learning نامیده میشود و یکی از محبوبترین روشها در یادگیری عمیق مدرن است که هم هزینه محاسباتی و هم زمان توسعه را بهطور چشمگیری کاهش میدهد.
تصمیمگیری خرید و ملاحظات اقتصادی
تصمیم به خرید یک ایستگاه کاری در سطح Soika 4×H100 یک تصمیم استراتژیک است که باید با در نظر گرفتن عوامل مختلف اقتصادی و فنی گرفته شود. هزینه اولیه چنین سیستمی قابلتوجه است و بسته به پیکربندی دقیق میتواند بین ۱۵۰ تا ۴۰۰ هزار دلار متغیر باشد. با این حال، برای ارزیابی صحیح این سرمایهگذاری، باید به کل هزینه مالکیت (TCO) در طول چند سال نگاه کرد و آن را با هزینههای جایگزین مانند استفاده از خدمات ابری مقایسه نمود. همانطور که قبلاً اشاره شد، هزینه اجاره منابع مشابه در سرویسهای ابری میتواند بهسرعت افزایش یابد و ممکن است در عرض یک تا دو سال از هزینه خرید فراتر رود.
علاوه بر هزینه سختافزار، سازمانها باید هزینههای عملیاتی مانند برق، خنککاری و نگهداری را نیز در نظر بگیرند. با توان مصرفی بالغ بر ۳۵۰۰ وات، هزینه برق میتواند به یک عامل قابلتوجه تبدیل شود، بهویژه در مناطقی با نرخ برق بالا. با این حال، در مقابل این هزینهها، مزایای قابل ملاحظهای نیز وجود دارد: کنترل کامل بر دادهها و زیرساخت، عدم وابستگی به اتصال اینترنت، تأخیر پایینتر برای دسترسی به منابع، و امکان استفاده نامحدود بدون نگرانی از هزینههای اضافی. برای سازمانهایی که بهطور مداوم نیاز به منابع محاسباتی دارند، این مزایا میتواند ارزش زیادی ایجاد کند.
یک عامل مهم دیگر در تصمیمگیری، برنامههای بلندمدت سازمان برای هوش مصنوعی است. اگر یک سازمان بهطور جدی تصمیم دارد که هوش مصنوعی را در مرکز استراتژی کسبوکار خود قرار دهد و چندین پروژه فعال در این حوزه دارد، سرمایهگذاری در زیرساخت اختصاصی میتواند توجیهپذیر باشد. از سوی دیگر، اگر نیاز به منابع GPU فقط برای پروژههای موقت یا آزمایشی است، استفاده از خدمات ابری ممکن است گزینه منطقیتری باشد. برخی سازمانها رویکرد ترکیبی را اتخاذ میکنند: زیرساخت محلی برای بارهای کاری مداوم و پایه، و منابع ابری برای نیازهای موقت یا پیکهای استفاده. این رویکرد میتواند بهترین تعادل بین کنترل، انعطافپذیری و هزینه را ارائه دهد.
آینده هوش مصنوعی و نقش ایستگاههای کاری
با توجه به روند رو به رشد پیچیدگی مدلهای هوش مصنوعی و افزایش کاربردهای آن در صنایع مختلف، نیاز به زیرساختهای محاسباتی قدرتمند تنها افزایش خواهد یافت. مدلهای زبانی بزرگ که امروزه دارای میلیاردها پارامتر هستند، در آینده ممکن است به تریلیونها پارامتر برسند و برای آموزش و اجرای آنها به منابع محاسباتی بیشتری نیاز باشد. در چنین محیطی، ایستگاههای کاری قدرتمندی مانند Soika 4×H100 نقش حیاتی در توانمندسازی پژوهشگران و متخصصان برای نوآوری در مرزهای هوش مصنوعی ایفا خواهند کرد.
یکی از روندهای مهم در آینده، دموکراتیزه شدن هوش مصنوعی است که به معنای در دسترس قرار گرفتن ابزارها و منابع پیشرفته برای طیف وسیعتری از سازمانها و افراد است. در گذشته، تنها شرکتهای بزرگ فناوری با منابع مالی عظیم میتوانستند روی پروژههای هوش مصنوعی پیشرفته کار کنند، اما با در دسترس شدن ایستگاههای کاری قدرتمند و مدلهای منبع باز، شرکتهای کوچکتر و استارتاپها نیز میتوانند در این حوزه رقابت کنند. این امر میتواند به تسریع نوآوری و ظهور راهحلهای خلاقانه در حوزههای مختلف منجر شود.
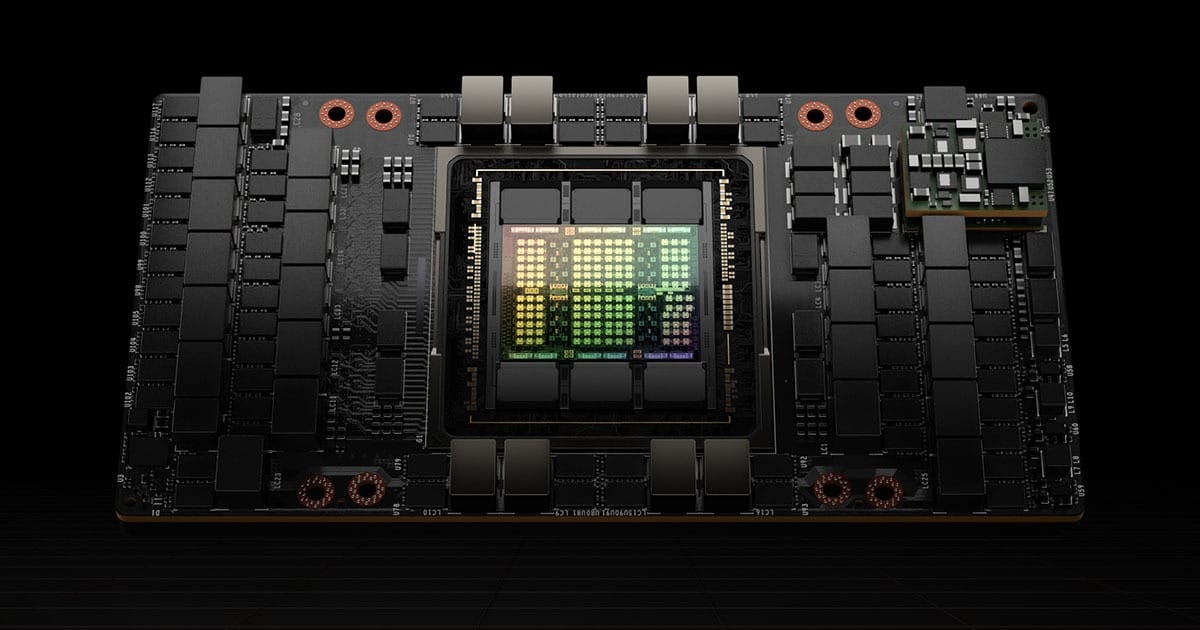
از سوی دیگر، با پیشرفت تکنولوژیهای جدید مانند کامپیوتینگ کوانتومی و نورومورفیک، معماریهای محاسباتی آینده ممکن است بسیار متفاوت از آنچه امروز داریم باشند. با این حال، تا زمانی که این تکنولوژیها به بلوغ کامل برسند و بهصورت تجاری در دسترس قرار گیرند، GPUهای پیشرفته مانند H100 همچنان اسب کاری اصلی هوش مصنوعی خواهند بود. سرمایهگذاری در چنین زیرساختی امروز، میتواند به سازمانها کمک کند تا برای آینده آماده شوند و در موج جدید تحول دیجیتال پیشرو باشند.
پاسخ به سوالات متداول
۱. آیا ایستگاه کاری Soika 4×H100 برای استارتاپهای کوچک مناسب است؟
این سیستم در درجه اول برای سازمانهایی طراحی شده که نیاز جدی و مداوم به پردازش حجم بالای دادهها و آموزش مدلهای پیچیده دارند. برای استارتاپهای کوچکی که در مراحل اولیه هستند و هنوز مدل کسبوکار خود را در حال اعتبارسنجی میکنند، استفاده از خدمات ابری GPU ممکن است گزینه مناسبتری باشد. با این حال، اگر استارتاپ شما در حوزهای فعالیت میکند که در آن داده محور اصلی کسبوکار است و برنامههای بلندمدت برای توسعه محصولات مبتنی بر هوش مصنوعی دارید، سرمایهگذاری در زیرساخت اختصاصی میتواند مزیت رقابتی قابلتوجهی ایجاد کند.
۲. چقدر زمان میبرد تا یک مدل زبانی بزرگ را روی این سیستم آموزش داد؟
زمان آموزش بستگی زیادی به اندازه مدل و حجم دادههای آموزشی دارد. بهعنوان مثال، یک مدل مشابه GPT-3 با ۱۷۵ میلیارد پارامتر ممکن است چندین هفته زمان ببرد، در حالی که مدلهای کوچکتر با چند میلیارد پارامتر میتوانند در عرض چند روز آموزش ببینند. با معماری Hopper و قابلیتهای FP8، ایستگاه Soika میتواند این زمانها را تا ۴۰ درصد نسبت به نسل قبلی GPUها کاهش دهد. برای Fine-tuning مدلهای از پیش آموزشدیده روی دادههای خاص، زمان معمولاً بسیار کمتر است و میتواند از چند ساعت تا چند روز متغیر باشد.
۳. آیا میتوان این سیستم را در آینده ارتقا داد؟
بله، معماری ایستگاه کاری Soika بهگونهای طراحی شده که امکان ارتقای اجزای مختلف را فراهم میکند. حافظه رم را میتوان تا ظرفیت حداکثری که پردازندهها پشتیبانی میکنند افزایش داد، فضای ذخیرهسازی NVMe را میتوان با درایوهای بزرگتر جایگزین کرد، و حتی GPUها را میتوان در آینده با نسلهای جدیدتر ارتقا داد. البته ارتقای GPUها سرمایهگذاری قابلتوجهی است و باید بر اساس نیازهای واقعی و بازگشت سرمایه ارزیابی شود. یکی از مزایای داشتن زیرساخت محلی این است که میتوانید بهصورت مرحلهای و بر اساس نیاز ارتقا کنید، برخلاف خدمات ابری که معمولاً باید برای کل پیکربندی جدید هزینه پرداخت کنید.
۴. امنیت دادهها در این سیستم چگونه تضمین میشود؟
ایستگاه کاری Soika چندین لایه امنیتی دارد. در سطح سختافزار، قابلیت Confidential Computing در GPUهای H100 از رمزنگاری دادهها حتی در حین پردازش محافظت میکند. حافظه ECC از خطاهای داده محافظت میکند و میتواند از برخی انواع حملات نیز جلوگیری کند. در سطح نرمافزار، سیستم عامل Ubuntu بهطور منظم بهروزرسانیهای امنیتی دریافت میکند و میتوان سیاستهای دسترسی پیچیده و رمزنگاری دیسک را پیکربندی کرد. از آنجایی که سیستم بهصورت محلی است، کنترل کامل بر دسترسی فیزیکی و شبکهای به آن در اختیار سازمان است که این خود یک مزیت امنیتی بزرگ است.
۵. چه میزان تخصص فنی برای راهاندازی و نگهداری این سیستم نیاز است؟
راهاندازی اولیه نیاز به تخصص متوسط تا پیشرفته در زمینه سیستمهای لینوکس و زیرساختهای GPU دارد، اما پلتفرم Soika Stack برای سادهسازی بسیاری از پیچیدگیها طراحی شده است. برای نگهداری روزانه، یک تیم IT با تجربه در مدیریت سرورهای لینوکس کافی است. برای بهینهسازی بارهای کاری خاص و استفاده حداکثری از قابلیتهای پیشرفته، داشتن متخصصان یادگیری عمیق که با چارچوبهای مختلف آشنایی دارند توصیه میشود. با این حال، با پشتیبانی فنی سهساله که ارائه میشود، میتوان در صورت نیاز از تیم Soika راهنمایی گرفت.
نتیجهگیری
ایستگاه کاری Soika 4×H100 نمایانگر نسل جدیدی از ابزارهای محاسباتی است که قدرت پردازشی مراکز داده سازمانی را به محیطهای محلی و دسترسیپذیرتر میآورد. با ترکیب چهار پردازنده گرافیکی H100 مبتنی بر معماری پیشرفته Hopper، این سیستم قادر است بارهای کاری پیچیده یادگیری عمیق، آموزش مدلهای زبانی بزرگ و استنتاج سریع را با کارایی بینظیری انجام دهد. برای سازمانهایی که بهطور جدی در حوزه هوش مصنوعی سرمایهگذاری میکنند و نیاز به کنترل کامل بر دادهها و زیرساخت خود دارند، این ایستگاه کاری میتواند یک سرمایهگذاری استراتژیک و بلندمدت باشد که نه تنها هزینههای عملیاتی را در طول زمان کاهش میدهد، بلکه امکان نوآوری سریعتر و مزیت رقابتی در بازار را نیز فراهم میکند.