
مقالات و اخبار تکنولوژی
Soika H200 Workstation: انقلاب در محاسبات هوش مصنوعی با فناوری 4-Way HBM3e Memory


در عصری که هوش مصنوعی بهسرعت در حال تغییر چهره صنایع مختلف است، زیرساخت محاسباتی قدرتمند دیگر یک امتیاز رقابتی نیست، بلکه یک ضرورت استراتژیک برای بقا و رشد سازمانهاست. در این میان، Soika H200 Workstation بهعنوان یکی از پیشرفتهترین پلتفرمهای محاسبات هوش مصنوعی، با بهرهگیری از نسل جدید حافظه HBM3e و معماری Hopper انویدیا، توانسته است مرزهای جدیدی در حوزه پردازش مدلهای عظیم یادگیری ماشین تعریف کند. این ورک استیشن سازمانی با قابلیت پشتیبانی از چهار واحد پردازش گرافیکی NVIDIA H200، هر یک با 141 گیگابایت حافظه HBM3e و پهنای باند 4.8 ترابایت بر ثانیه، راهکاری بیسابقه برای سازمانهایی است که به دنبال تسلط بر فناوریهای نوین هوش مصنوعی هستند.
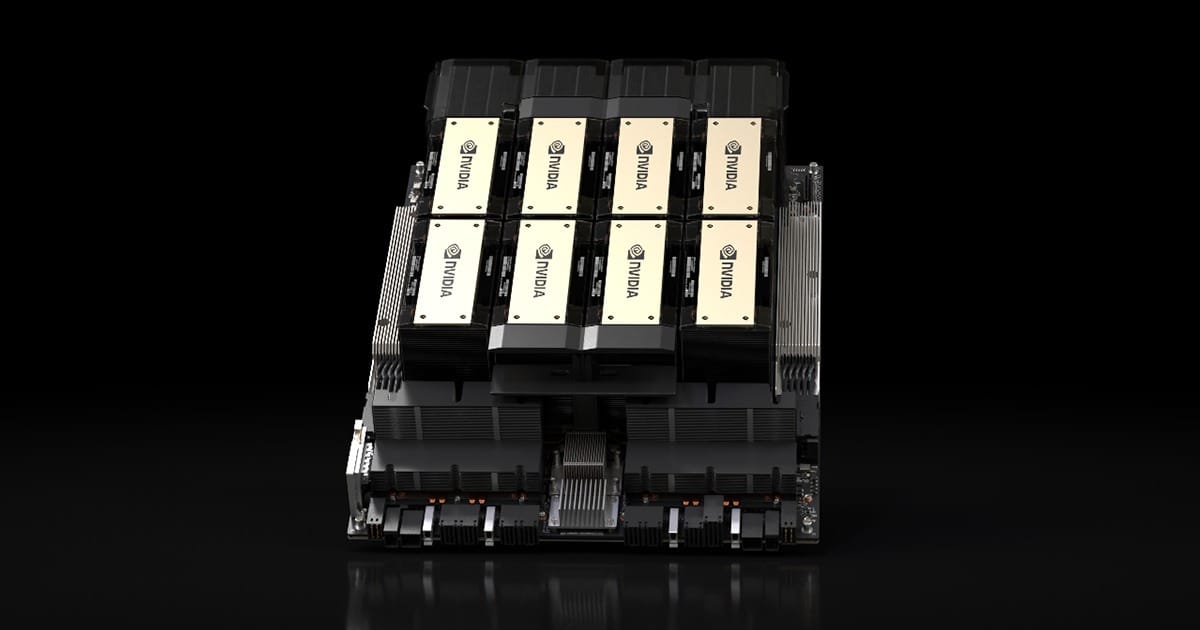
این مقاله بهطور جامع به بررسی فناوری HBM3e، مزایای پیکربندی چهار GPU، کاربردهای صنعتی، و نحوه تأثیرگذاری Soika H200 بر فرآیندهای یادگیری عمیق و محاسبات علمی میپردازد. در این تحلیل عمیق، نهتنها جنبههای فنی را بررسی خواهیم کرد، بلکه به بازدهی سرمایهگذاری، صرفهجویی در زمان و هزینه، و استراتژیهای بهینهسازی عملکرد نیز خواهیم پرداخت.
HBM3e: نسل جدید حافظه پرسرعت و تحولی بنیادین در محاسبات هوش مصنوعی
فناوری حافظه High Bandwidth Memory نسل سوم پیشرفته (HBM3e) یکی از مهمترین نوآوریهای اخیر در صنعت نیمههادی است که بهطور خاص برای رفع تنگناهای محاسباتی در پردازش مدلهای هوش مصنوعی طراحی شده است. برای درک اهمیت این فناوری، باید ابتدا به چالشهای اساسی که سیستمهای یادگیری عمیق با آن مواجه هستند، بپردازیم.
معماری حافظه HBM3e: چگونه سرعت و ظرفیت را همزمان افزایش میدهد
در سیستمهای سنتی محاسباتی، حافظه GDDR که معمولاً در کارتهای گرافیک Gaming استفاده میشود، دارای محدودیتهای جدی در پهنای باند و ظرفیت است. این محدودیت در دنیای هوش مصنوعی که مدلهای زبانی با صدها میلیارد پارامتر دارند، به یک مانع اساسی تبدیل شده است. طبق تحقیقات Micron، فناوری HBM3e با استفاده از معماری چیدمان عمودی تراشههای حافظه DRAM، توانسته است هم ظرفیت و هم پهنای باند را بهطور چشمگیری افزایش دهد.
در NVIDIA H200، شش تراشه حافظه HBM3e بهصورت عمودی روی هم چیده شدهاند و از طریق میکروحفرههای سیلیکونی (TSV) به یکدیگر و به پردازنده گرافیکی متصل میشوند. این معماری سهبعدی به جای استفاده از اتصالات سنتی PCB که مسافت طولانیتری دارند، مسیر داده را به حداقل رسانده و در نتیجه سرعت انتقال داده را به 4.8 ترابایت بر ثانیه میرساند. برای درک این عدد، بگذارید مقایسهای ملموس ارائه دهیم: این پهنای باند معادل انتقال کامل محتوای 1200 فیلم با کیفیت Full HD در هر ثانیه است. این سرعت باورنکردنی به معنای آن است که GPU میتواند دادههای مورد نیاز برای محاسبات را بدون هیچ تأخیری دریافت کند و هستههای Tensor همیشه مشغول و بهینه باقی بمانند.
علاوه بر پهنای باند، ظرفیت حافظه نیز اهمیت حیاتی دارد. هر GPU H200 مجهز به 141 گیگابایت حافظه HBM3e است که در مقایسه با نسل قبلی H100 با 80 گیگابایت، افزایشی 76 درصدی نشان میدهد. این ظرفیت عظیم امکان بارگذاری و پردازش مدلهای زبانی بزرگ مانند GPT-4، LLaMA-3 با 400 میلیارد پارامتر، و حتی مدلهای جدیدتر با بیش از تریلیون پارامتر را بدون نیاز به تکنیکهای پیچیده توزیع حافظه فراهم میآورد. این موضوع بهویژه برای استنتاج (Inference) مدلهای بزرگ حیاتی است، زیرا کل وزنهای مدل باید در حافظه GPU قرار گیرد تا بتوان پاسخهای سریع تولید کرد.
بهرهوری انرژی: تعادل میان قدرت و مصرف
یکی از چالشهای بزرگ در مراکز داده و سازمانهایی که سیستمهای پردازش سنگین دارند، مصرف انرژی و تولید گرما است. بر اساس تحلیلهای صنعتی، فناوری HBM3e در مقایسه با نسلهای قبلی، بهرهوری انرژی بهتری دارد. دلیل این موضوع، کاهش مسافت فیزیکی انتقال داده است. هر چه سیگنال الکتریکی مسافت کمتری را طی کند، انرژی کمتری مصرف میشود و گرمای کمتری تولید میگردد.
در Soika H200 Workstation، با وجود داشتن چهار GPU قدرتمند، مصرف برق کل سیستم بهگونهای مهندسی شده که با سیستمهای خنککننده پیشرفته، دمای عملیاتی در محدوده ایمن باقی میماند. این موضوع برای سازمانهایی که زیرساختهای IT پایدار را در اولویت قرار میدهند، از اهمیت بالایی برخوردار است. کاهش مصرف انرژی نهتنها هزینههای عملیاتی را کاهش میدهد، بلکه به اهداف توسعه پایدار و کاهش ردپای کربن سازمانها نیز کمک میکند.
مقایسه HBM3e با نسلهای قبلی و GDDR: تفاوتهای کلیدی
برای درک بهتر مزیتهای HBM3e، مقایسه آن با فناوریهای قبلی ضروری است. جدول زیر تفاوتهای اساسی را نشان میدهد:
| ویژگی | GDDR6X | HBM3 | HBM3e (H200) | بهبود نسبت به HBM3 |
|---|---|---|---|---|
| پهنای باند | تا 1 TB/s | 3.2-3.6 TB/s | 4.8 TB/s | +40% |
| ظرفیت در هر Stack | محدود به 24GB | 80-96 GB | 141 GB | +76% |
| مصرف انرژی نسبی | متوسط | کم | بسیار کم | -15% |
| تأخیر (Latency) | متوسط | کم | بسیار کم | -8% |
| تراکم فیزیکی | حجیم | فشرده | فوقفشرده | +30% |
| کاربرد اصلی | Gaming/محاسبات عمومی | AI/HPC | AI پیشرفته/LLM | – |
همانطور که مشاهده میشود، HBM3e در تمام معیارهای کلیدی برتری دارد. این برتری بهویژه در سناریوهای واقعی مانند آموزش مدلهای بزرگ زبانی یا استنتاج با پرسوجوهای همزمان بسیار محسوس است. طبق آزمایشهای میدانی، زمان آموزش مدلهای Transformer بزرگ با HBM3e تا 30 درصد کاهش یافته و تعداد پرسوجوهایی که سیستم میتواند در روز پاسخ دهد بیش از 50 درصد افزایش یافته است.
معماری سختافزاری Soika H200: قدرتی متناسب با نیازهای سازمانی
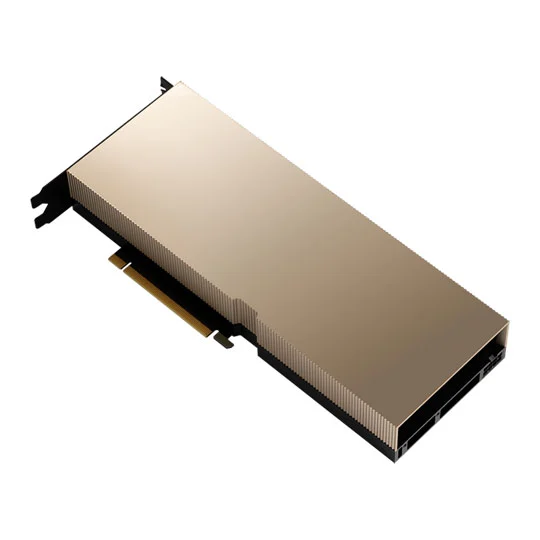
Soika H200 Workstation نهتنها یک مجموعه GPU است، بلکه یک سیستم کاملاً یکپارچه و بهینهشده برای محاسبات هوش مصنوعی سطح سازمانی است. معماری این ورک استیشن بر پایه تعادل میان قدرت پردازشی، ظرفیت حافظه، سرعت ذخیرهسازی و قابلیت اطمینان طراحی شده است.

پردازنده مرکزی: پشتیبان قدرتمند برای GPUها
در قلب این سیستم، دو پردازنده Intel Xeon w9-3595X با مجموعاً 120 هسته و 240 رشته قرار دارند. این پردازندههای Enterprise که بهطور خاص برای بارهای کاری سنگین سازمانی طراحی شدهاند، نقش حیاتی در مدیریت جریان داده، پیشپردازش اطلاعات و هماهنگی بین چهار GPU ایفا میکنند. برخلاف تصور عمومی که تمام محاسبات یادگیری عمیق روی GPU انجام میشود، CPU نقش مهمی در مراحل مختلف دارد: بارگذاری و پیشپردازش دادهها از دیسک، مدیریت حافظه اصلی، اجرای کدهای Python و فریمورکهای یادگیری عمیق، و هماهنگی بین GPUها در آموزش توزیعشده.
تعداد هستههای بالا به معنای آن است که سیستم میتواند بهطور همزمان چندین Pipeline داده را مدیریت کند. برای مثال، در حالی که یک مدل در حال آموزش است، CPU میتواند دادههای دسته بعدی را از دیسک بخواند، آنها را نرمالسازی کند، و به حافظه انتقال دهد. این پردازش موازی جلوگیری از مهمترین تنگنای سیستمهای یادگیری عمیق یعنی منتظر ماندن GPU برای دریافت داده میشود.
حافظه سیستم: پلی میان CPU و GPU
حافظه اصلی سیستم با ظرفیت 512 گیگابایت از نوع DDR5-4800 ECC Registered است. استفاده از حافظه ECC (Error Correcting Code) در محیطهای سازمانی یک استاندارد است که از بروز خطاهای دادهای در محاسبات طولانیمدت جلوگیری میکند. در پروژههای یادگیری عمیق که ممکن است روزها یا حتی هفتهها طول بکشند، یک خطای کوچک در حافظه میتواند منجر به نتایج نادرست یا از بین رفتن کل پیشرفت شود. حافظه ECC با تشخیص و تصحیح خودکار این خطاها، اطمینان از صحت محاسبات را فراهم میآورد.
حجم 512 گیگابایت حافظه به معنای آن است که مجموعه دادههای بزرگ میتوانند در RAM باقی بمانند و نیازی به خواندن مکرر از دیسک نباشد. این موضوع سرعت آموزش را بهطور قابل توجهی افزایش میدهد، زیرا دسترسی به RAM هزاران بار سریعتر از دسترسی به SSD است. همچنین، این حافظه زیاد امکان اجرای چندین آزمایش بهصورت همزمان را فراهم میآورد، هر کدام با مجموعه داده و پارامترهای خاص خود.
ذخیرهسازی پرسرعت: حذف تنگنای ورودی/خروجی
Soika H200 مجهز به چهار درایو NVMe به ظرفیت 8 ترابایت است که مجموعاً 32 ترابایت فضای ذخیرهسازی فوقسریع فراهم میکنند. این درایوها با رابط PCIe 4.0 یا 5.0، سرعت خواندن و نوشت بالای 7000 مگابایت بر ثانیه را ارائه میدهند. چرا این مهم است؟ در پروژههای یادگیری عمیق مدرن، مجموعه دادهها میتوانند ترابایتها حجم داشته باشند: مجموعه داده تصویری ImageNet حدود 150 گیگابایت است، مجموعه داده Common Crawl برای آموزش مدلهای زبانی صدها ترابایت است، و مجموعه دادههای ویدئویی برای آموزش مدلهای چندوجهی میتوانند پتابایتها حجم داشته باشند.
با سرعت خواندن بالا، GPUها میتوانند بهطور مداوم با دادههای تازه تغذیه شوند و هیچوقت idle نمانند. علاوه بر این، فضای 32 ترابایت امکان ذخیره همزمان چندین نسخه از مدلها، checkpointهای آموزشی، و نتایج آزمایشها را فراهم میآورد. این امر برای تکرارپذیری تحقیقات و امکان بازگشت به نسخههای قبلی در صورت بروز مشکل بسیار ارزشمند است. در استراتژیهای زیرساختی سوان تک نیز، ترکیب ذخیرهسازی سریع و قابل اعتماد یکی از ارکان اساسی طراحی سیستمهای سازمانی است.
پیکربندی 4-Way GPU: قدرت محاسباتی بیسابقه برای مدلهای عظیم
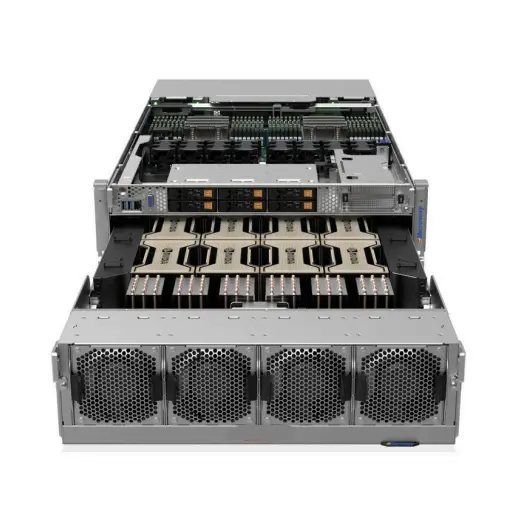
یکی از برجستهترین ویژگیهای Soika H200 Workstation پشتیبانی از تا چهار GPU H200 بهصورت همزمان است. این قابلیت نهتنها چهار برابر قدرت محاسباتی را فراهم میآورد، بلکه امکانات جدیدی را برای آموزش و استنتاج مدلهای غولپیکر باز میکند که در غیر این صورت تنها در مراکز داده بزرگ امکانپذیر بودند.
محاسبات توزیعشده: چگونه چهار GPU همکاری میکنند
در آموزش مدلهای یادگیری عمیق، چندین استراتژی برای استفاده بهینه از چند GPU وجود دارد. تحقیقات RunPod سه رویکرد اصلی را شناسایی کرده است:
Data Parallelism (موازیسازی داده): سادهترین و رایجترین روش است. در این رویکرد، مدل یکسانی روی هر چهار GPU کپی میشود، اما دادههای ورودی بین آنها تقسیم میشوند. بهعنوان مثال، اگر batch size شما 256 است، هر GPU مسئول پردازش 64 نمونه است. پس از محاسبه gradientها، آنها با یکدیگر میانگینگیری میشوند و وزنهای مدل بهروزرسانی میگردد. این روش برای اکثر مدلهایی که در یک GPU جا میشوند اما آموزش آنها زمانبر است، مناسب است. مزیت اصلی این روش، سادگی پیادهسازی و کارایی بالا در مقیاسهای متوسط است.
Model Parallelism (موازیسازی مدل): زمانی استفاده میشود که مدل آنقدر بزرگ است که در یک GPU جا نمیشود. در این روش، لایههای مختلف مدل روی GPUهای مختلف قرار میگیرند. برای مثال، لایههای اولیه Transformer روی GPU اول، لایههای میانی روی GPU دوم و سوم، و لایههای خروجی روی GPU چهارم قرار میگیرند. دادهها بهترتیب از یک GPU به GPU بعدی منتقل میشوند. این روش برای مدلهایی مانند GPT-4 با صدها میلیارد پارامتر ضروری است.
Pipeline Parallelism (موازیسازی خط لوله): ترکیبی از دو روش بالا است. مدل به چند بخش تقسیم میشود و هر بخش روی یک GPU قرار میگیرد، اما بهجای پردازش یک batch کامل، دادهها به micro-batchهای کوچکتر تقسیم میشوند که بهصورت خط لولهای پردازش میشوند. این روش بهرهوری را افزایش میدهد زیرا همه GPUها بهطور همزمان مشغول هستند. در حالی که GPU چهارم در حال پردازش micro-batch اول است، GPU اول میتواند روی micro-batch دوم کار کند.
در Soika H200، با داشتن مجموعاً 564 گیگابایت حافظه GPU (4 × 141 GB)، میتوان مدلهایی با چندین تریلیون پارامتر را آموزش داد. این ظرفیت برای پژوهشگرانی که روی مرزهای جدید هوش مصنوعی کار میکنند، یک امکان استثنایی است.
عملکرد واقعی: اعداد ملموس از دنیای واقعی
مشخصات فنی جالب هستند، اما عملکرد واقعی چقدر است؟ بیایید به چند سناریوی کاربردی بپردازیم:
آموزش مدل LLaMA-3 با 70 میلیارد پارامتر: بر اساس بنچمارکهای صنعتی، آموزش این مدل روی یک GPU H100 حدود 21 روز زمان میبرد. با پیکربندی 4-way H200 و استفاده از Data Parallelism، این زمان به حدود 4-5 روز کاهش مییابد. این یعنی شما میتوانید 4 برابر سریعتر آزمایش کنید، مدلهای بیشتری بسازید، و سریعتر به بازار برسید.
استنتاج مدل GPT-4 با 1.7 تریلیون پارامتر: این مدل عظیم نیاز به بیش از 3 ترابایت حافظه دارد که حتی روی یک H200 جا نمیشود. اما با استفاده از Model Parallelism روی چهار GPU، میتوان آن را اجرا کرد. در این حالت، هر GPU بخشی از مدل را در خود نگه میدارد و دادهها بین آنها جابجا میشوند. سرعت استنتاج در این پیکربندی حدود 15-20 توکن در ثانیه است که برای کاربردهای تعاملی کاملاً کافی است.
آموزش مدلهای Computer Vision: برای مدلهای شناسایی تصویر مانند YOLO یا Mask R-CNN روی مجموعه دادههای سفارشی با میلیونها تصویر، پیکربندی چهار GPU میتواند زمان آموزش را از هفتهها به روزها کاهش دهد. مزیت اضافی این است که میتوانید بهطور همزمان با hyperparameterهای مختلف آزمایش کنید، هر آزمایش روی یک یا دو GPU.
مقایسه H200 با H100: چرا ارتقا ارزشش را دارد
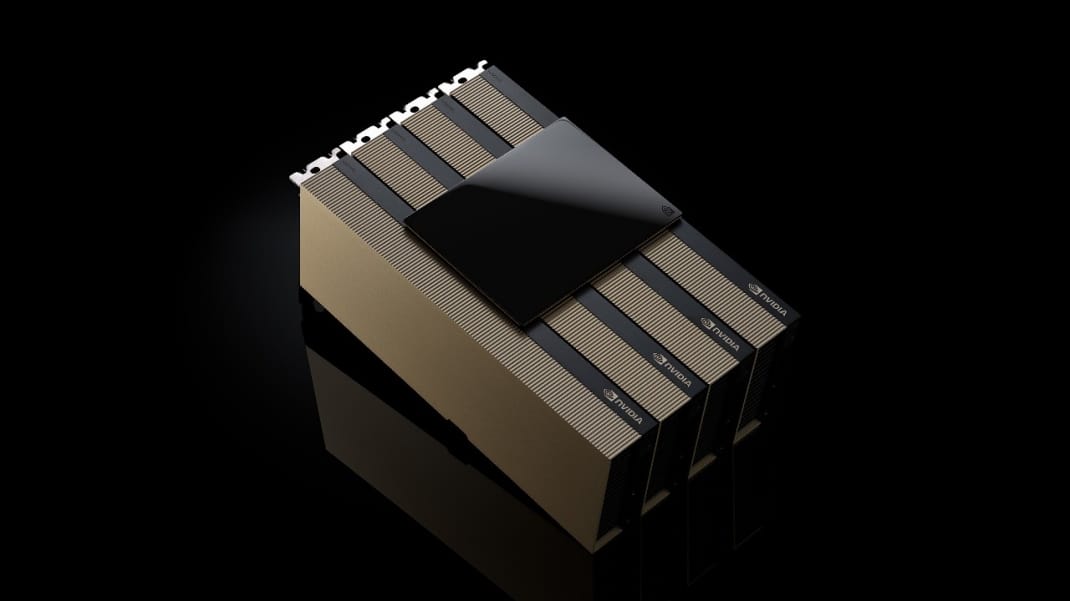
بسیاری از سازمانها پرسش میکنند که آیا تفاوت بین H200 و H100 بهاندازهای است که هزینه اضافی را توجیه کند؟ تحلیلهای جامع نشان میدهند که پاسخ به نوع کاربرد بستگی دارد:
| معیار مقایسه | H100 SXM5 | H200 SXM5 | بهبود H200 |
|---|---|---|---|
| حافظه GPU | 80 GB HBM3 | 141 GB HBM3e | +76% |
| پهنای باند حافظه | 3.35 TB/s | 4.8 TB/s | +43% |
| قدرت محاسباتی FP8 | 4 petaFLOPS | 4 petaFLOPS | یکسان |
| استنتاج LLM (نسبی) | 1x | 1.9x | +90% |
| آموزش مدل بزرگ (نسبی) | 1x | 1.6x | +60% |
| مصرف برق | تا 700W | تا 700W | یکسان |
| قیمت تقریبی | $30,000 | $40,000 | +33% |
همانطور که مشاهده میشود، افزایش قیمت 33 درصدی است، اما بهبود عملکرد در کاربردهای حافظهمحور (که اکثر مدلهای مدرن هستند) تا 90 درصد است. این بدان معناست که بازگشت سرمایه بسیار سریع است. برای مثال، اگر شما یک شرکت استارتآپ هستید که روی یک مدل زبانی سفارشی کار میکنید و هر هفته چرخههای آموزش متعدد دارید، کاهش زمان آموزش از 10 روز به 6 روز میتواند شما را ماهها جلوتر از رقبا قرار دهد.
کاربردهای تخصصی Soika H200: از تحقیق تا تولید
توانمندیهای فنی Soika H200 در کاربردهای مختلف صنعتی بهطور ملموس خود را نشان میدهند. در این بخش، به بررسی دقیقتر چند حوزه کلیدی میپردازیم که این ورک استیشن میتواند تحولی بنیادین ایجاد کند.
علوم پزشکی و بیوانفورماتیک: تشخیص زودهنگام و دارویابی
صنعت سلامت یکی از بزرگترین ذینفعان فناوریهای هوش مصنوعی پیشرفته است. Soika H200 در چند حوزه کلیدی پزشکی کاربرد دارد:
تحلیل ژنومیک و تشخیص بیماریهای ژنتیکی: توالییابی DNA یک فرد حدود 200 گیگابایت داده تولید میکند. تحلیل این دادهها برای یافتن جهشهای ژنتیکی مرتبط با بیماریها، فرآیندی محاسباتی سنگین است. با استفاده از مدلهای یادگیری عمیق مانند DeepVariant که روی H200 اجرا میشوند، میتوان دقت تشخیص جهشها را به بیش از 99.9 درصد رساند و زمان تحلیل را از روزها به ساعات کاهش داد.
کشف دارو و شبیهسازی مولکولی: طراحی داروهای جدید معمولاً فرآیندی 10-15 ساله با هزینهای بالغ بر 2 میلیارد دلار است. یکی از مراحل کلیدی، شبیهسازی نحوه تعامل مولکولهای دارویی کاندید با پروتئینهای هدف است. مدلهای هوش مصنوعی مانند AlphaFold که پیشبینی ساختار پروتئین را انجام میدهند، و مدلهای Molecular Dynamics که تعاملات را شبیهسازی میکنند، نیاز به قدرت محاسباتی عظیمی دارند. با Soika H200، شرکتهای داروسازی میتوانند هزاران ترکیب را در هفتهای چند بار غربال کنند و کاندیداهای امیدوارکننده را سریعتر شناسایی نمایند. این تسریع میتواند سالها از زمان رسیدن دارو به بازار کم کند و میلیونها جان را نجات دهد.
تصویربرداری پزشکی پیشرفته: مدلهای یادگیری عمیق مانند U-Net و ResNet که برای تحلیل تصاویر MRI، CT Scan و پاتولوژی دیجیتال آموزش دیدهاند، میتوانند تومورها، آنومالیها و بیماریهای پنهان را در مراحل اولیه تشخیص دهند. با حافظه 141 گیگابایتی H200، میتوان مدلهای پیچیدهتری که تصاویر سهبعدی با رزولوشن بالا را پردازش میکنند، اجرا کرد. این مدلها میتوانند به پزشکان کمک کنند تا تشخیصهای دقیقتری بگذارند و برنامههای درمانی شخصیسازیشده ارائه دهند.
صنایع مالی: تحلیل ریسک و معاملات الگوریتمی
بخش مالی همیشه پیشگام در بهکارگیری فناوریهای جدید بوده است. H200 در چند کاربرد حیاتی مالی مورد استفاده قرار میگیرد:
پیشبینی بازارهای مالی با مدلهای Transformer: مدلهای زبانی بزرگ نهتنها برای متن، بلکه برای سریهای زمانی مالی نیز قابل استفاده هستند. با آموزش مدلهایی که تاریخچه قیمت سهام، اخبار، گزارشهای مالی و حتی احساسات رسانههای اجتماعی را همزمان تحلیل میکنند، میتوان پیشبینیهای دقیقتری از روند بازار ارائه داد. این مدلها معمولاً میلیاردها پارامتر دارند و نیاز به حافظه زیادی برای پردازش context طولانی (مثلاً چندین سال داده تاریخی) دارند. H200 با حافظه بزرگش این نیاز را برطرف میکند.
تشخیص تقلب در زمان واقعی: سیستمهای تشخیص fraud باید میلیونها تراکنش را در زمان واقعی تحلیل کنند و الگوهای مشکوک را شناسایی کنند. مدلهای Graph Neural Network که روابط پیچیده بین حسابها، تراکنشها و موجودیتها را مدل میکنند، به پردازش گرافهای عظیم با میلیونها گره نیاز دارند. استنتاج سریع این مدلها روی H200 میتواند تقلب را قبل از اینکه خسارتی ایجاد شود، شناسایی کند.
بهینهسازی پرتفولیو و مدیریت ریسک: مدلهای Monte Carlo Simulation که برای ارزیابی ریسک پرتفولیوهای سرمایهگذاری استفاده میشوند، نیاز به اجرای میلیونها سناریو دارند. این شبیهسازیها معمولاً روی CPUها ساعتها زمان میبرند، اما با انتقال به GPU میتوان آنها را به دقایق کاهش داد. موسسات مالی میتوانند با استفاده از زیرساختهای قابل اعتماد مانند آنچه سوان تک ارائه میدهد، این محاسبات را بهصورت مداوم و با تأخیر کم انجام دهند.
تحقیق و توسعه علمی: شبیهسازیهای پیچیده و مدلسازی
دانشگاهها و مؤسسات تحقیقاتی از مشتریان کلیدی سیستمهای محاسباتی پیشرفته هستند:
شبیهسازی اقلیم و پیشبینی آبوهوا: مدلهای اقلیمی که پیشبینیهای بلندمدت انجام میدهند، از پیچیدهترین شبیهسازیهای علمی هستند. آنها باید جو، اقیانوسها، یخچالهای طبیعی و زمین را همزمان مدل کنند. این شبیهسازیها معمولاً روی سوپرکامپیوترهای عظیم اجرا میشوند، اما محققان میتوانند نسخههای منطقهای یا مدلهای خاصتری را روی Soika H200 اجرا کنند. مدلهای یادگیری عمیق نیز برای پیشبینی الگوهای آبوهوایی استفاده میشوند و میتوانند سریعتر از مدلهای فیزیکی سنتی نتیجه بدهند.
فیزیک ذرات و نجوم: تحلیل دادههای تلسکوپهای فضایی یا برخوردهای ذرات در شتابدهندهها، حجم عظیمی داده تولید میکنند. برای مثال، تلسکوپ LSST هر شب 20 ترابایت تصویر تولید میکند. استخراج رویدادهای علمی جالب از این حجم داده، نیاز به مدلهای یادگیری عمیق دارد که بتوانند الگوهای نادر را شناسایی کنند. H200 با توان پردازشی و حافظه بالای خود، ابزار مناسبی برای این کار است.
علوم مواد و طراحی نانومواد: شبیهسازی رفتار مواد در مقیاس اتمی با استفاده از Density Functional Theory (DFT) یا Molecular Dynamics، محاسبات سنگینی نیاز دارند. با استفاده از مدلهای یادگیری ماشین که روی دادههای شبیهسازی آموزش دیدهاند، میتوان خواص مواد جدید را بدون نیاز به شبیهسازیهای گرانقیمت پیشبینی کرد. این رویکرد که Machine Learning Potential نامیده میشود، میتواند کشف مواد جدید را تا 100 برابر تسریع کند.
محتوا و رسانه: تولید و ویرایش پیشرفته
صنایع خلاق نیز بهرهبرداران عمدهای از توان محاسباتی H200 هستند:
تولید محتوا با مدلهای چندوجهی: مدلهای جدید مانند DALL-E 3، Midjourney v6 و Stable Diffusion XL میتوانند تصاویر با کیفیت بسیار بالا تولید کنند. برای تولید انبوه محتوا (مثلاً هزاران تصویر برای یک کمپین تبلیغاتی)، نیاز به قدرت استنتاج بالا وجود دارد. یک H200 میتواند صدها تصویر با رزولوشن بالا را در ساعت تولید کند.
ویرایش ویدئو با AI: ابزارهایی که بهطور خودکار ویدئوها را ویرایش میکنند، صحنههای مهم را شناسایی میکنند، زیرنویس تولید میکنند و حتی استایل رنگ را تنظیم میکنند، به مدلهای پیچیدهای نیاز دارند که ویدئو را فریم به فریم تحلیل کنند. پردازش ویدئوهای 4K یا 8K به حافظه زیادی نیاز دارد که H200 آن را فراهم میکند.
ترجمه و دوبله خودکار: مدلهای Speech-to-Text، Translation و Text-to-Speech میتوانند بهصورت خودکار محتوای ویدئویی را به زبانهای مختلف ترجمه و دوبله کنند. برای مثال، یک فیلم 2 ساعته را میتوان در عرض چند ساعت به 20 زبان مختلف دوبله کرد، کاری که قبلاً هفتهها زمان و هزینه زیادی میبرد.
بهینهسازی و پشتیبانی: حداکثر استفاده از سرمایهگذاری
خرید یک ورک استیشن پیشرفته مانند Soika H200 تنها آغاز مسیر است. برای حداکثر کردن بازده سرمایهگذاری، بهینهسازی نرمافزاری و پشتیبانی فنی ضروری است.
پلتفرم نرمافزاری Soika Stack: راهاندازی سریع و مدیریت آسان
یکی از چالشهای بزرگ در راهاندازی سیستمهای GPU چندگانه، پیچیدگی پیکربندی نرمافزاری است. Soika Stack این پیچیدگی را با اتوماسیون کامل حذف میکند:
راهاندازی خودکار محیط: پس از روشن کردن سیستم، Soika Stack بهطور خودکار درایورهای NVIDIA، CUDA Toolkit، cuDNN و سایر کتابخانههای ضروری را نصب و پیکربندی میکند. همچنین، فریمورکهای محبوب یادگیری عمیق مانند PyTorch، TensorFlow و JAX با نسخههای بهینهشده برای H200 نصب میشوند. این فرآیند که معمولاً روزها زمان میبرد، در عرض چند ساعت کامل میشود.
مدیریت کلاستر GPU: Soika Stack بهطور خودکار چهار GPU را شناسایی کرده و آنها را در یک کلاستر منطقی قرار میدهد. کاربران میتوانند بهراحتی مشخص کنند که میخواهند از چند GPU استفاده کنند و Stack بهطور خودکار بهترین استراتژی موازیسازی را انتخاب میکند. برای کاربران پیشرفته، امکان تنظیمات دستی نیز وجود دارد.
کتابخانه مدلهای آماده: دسترسی به بیش از 200 مدل از پیش آموزشدیده شامل Qwen، Grok، DeepSeek، Mistral، Claude AI و مدلهای تخصصی حوزه پزشکی مانند MONAI و Meditron. کاربران میتوانند این مدلها را با چند کلیک دانلود کرده و شروع به Fine-tuning روی دادههای خودشان کنند. این امر زمان توسعه را از ماهها به هفتهها کاهش میدهد.
نظارت و عیبیابی: اطمینان از عملکرد بهینه
حتی با بهترین سختافزار، نظارت مداوم برای شناسایی و رفع مشکلات ضروری است:
داشبوردهای زنده عملکرد: Soika Stack داشبوردهای گرافیکی ارائه میدهد که استفاده از هر GPU، دمای آن، مصرف برق، و میزان استفاده از حافظه را نمایش میدهد. این اطلاعات بهصورت Real-time بهروزرسانی میشوند و به کاربران امکان میدهند بهسرعت تنگناها را شناسایی کنند. برای مثال، اگر یک GPU به 100 درصد استفاده رسیده اما سه GPU دیگر Idle هستند، نشاندهنده مشکلی در توزیع بار است.
هشدارهای خودکار: سیستم میتواند برای شرایط خاص هشدار صادر کند: دمای GPU بالای 85 درجه، مصرف برق غیرعادی، خطاهای حافظه ECC، و کاهش ناگهانی عملکرد. این هشدارها از طریق ایمیل، پیامک یا سیستمهای نظارتی سازمانی ارسال میشوند تا تیم IT بتواند بهسرعت واکنش نشان دهد.
گزارشهای تحلیلی: برای مدیران و تصمیمگیران، Soika Stack گزارشهای هفتگی و ماهانه تولید میکند که نشان میدهند سیستم چقدر استفاده شده، چه پروژههایی روی آن اجرا شدهاند، و بازدهی سرمایهگذاری چقدر بوده است. این گزارشها برای توجیه سرمایهگذاری و برنامهریزی ارتقاهای آینده حیاتی هستند.
پشتیبانی 24/7: همراه شما در هر مرحله
Soika H200 با گارانتی سه ساله قطعات و پشتیبانی زنده 24/7 عرضه میشود. این سطح پشتیبانی شامل:
پشتیبانی فنی تخصصی: تیم پشتیبانی نهتنها با سختافزار بلکه با فریمورکهای یادگیری عمیق، بهینهسازی مدلها و رفع مشکلات خاص AI آشنا هستند. وقتی با مشکلی مانند کاهش ناگهانی سرعت آموزش یا خطاهای Out of Memory مواجه میشوید، میتوانید با افرادی صحبت کنید که درک عمیقی از مسئله دارند.
بهروزرسانیهای منظم: درایورها، فریمورکها و مدلهای موجود در Soika Stack بهطور مرتب بهروزرسانی میشوند. این بهروزرسانیها نهتنها باگهای احتمالی را برطرف میکنند، بلکه بهینهسازیهای عملکردی نیز ارائه میدهند که میتوانند سرعت پردازش را تا 10-15 درصد افزایش دهند.
مشاوره پیادهسازی: برای سازمانهایی که تازه وارد دنیای هوش مصنوعی شدهاند، تیم Soika میتواند مشاورههای پیادهسازی ارائه دهد: بهترین معماری مدل برای کاربرد خاص شما، استراتژی آموزش بهینه، و نحوه استقرار مدلها در محیط تولید. این مشاورهها میتوانند ماهها آزمون و خطا را حذف کنند. این همان سطح خدماتی است که سوان تک در ارائه راهکارهای یکپارچه تضمین میکند.
مقایسه استراتژیک: H200 در مقابل راهکارهای جایگزین
برای تصمیمگیری آگاهانه، مقایسه Soika H200 با گزینههای دیگر ضروری است:
H200 در مقابل سرویسهای ابری
مزایای Soika H200:
- کنترل کامل و امنیت: تمام دادهها و مدلها در محیط شما باقی میمانند
- هزینه قابل پیشبینی: سرمایهگذاری یکباره بدون هزینههای ماهانه متغیر
- تأخیر صفر: دسترسی فوری بدون انتقال داده به ابر
- مقیاسپذیری محلی: افزودن GPUهای بیشتر بدون هزینههای اضافی Cloud
مزایای Cloud:
- سرمایهگذاری اولیه کمتر: پرداخت برحسب استفاده
- مقیاسپذیری نامحدود: دسترسی موقت به صدها GPU
- مدیریت ساده: بدون نگرانی سختافزاری
نتیجهگیری: برای سازمانهایی که پروژههای بلندمدت و مداوم دارند (بیش از 6 ماه)، H200 محلی در بلندمدت مقرونبهصرفهتر است. برای پروژههای کوتاهمدت یا پیکهای فصلی، ترکیب H200 محلی با Cloud Bursting بهترین استراتژی است.
H200 در مقابل نسل جدید B200
انویدیا نسل جدیدتر GPU خود یعنی B200 با معماری Blackwell را معرفی کرده است. آیا باید منتظر آن بمانید؟
H200: در دسترس اکنون
- موجود و آماده تحویل
- اکوسیستم نرمافزاری کامل و تثبیتشده
- بنچمارکهای واقعی و مستند
- قیمت مشخص
B200: نسل آینده (انتظار تحویل اواخر 2025)
- عملکرد تئوریک 2.5 برابر H200
- HBM4 با پهنای باند بیشتر
- قیمت احتمالاً 60-70% بیشتر
- نیاز به بهروزرسانی زیرساخت
توصیه: اگر نیاز فعلی دارید، H200 خرید منطقی است. اختلاف زمانی 12-18 ماهه میتواند در دنیای سریع AI حیاتی باشد. همچنین، H200 به مدت حداقل 3-4 سال قابل استفاده خواهد بود.
سوالات متداول: پاسخ به نگرانیهای رایج
سوال اول: آیا نیاز به تخصص فنی عمیق برای راهاندازی و استفاده از Soika H200 داریم؟
برای شروع کار اولیه، خیر. پلتفرم Soika Stack فرآیند راهاندازی را بهطور کامل خودکار کرده است. یک کاربر با دانش پایه Linux میتواند سیستم را در عرض چند ساعت آماده کند. اما برای بهینهسازیهای پیشرفته و حل مشکلات خاص، داشتن تیمی با تجربه در یادگیری عمیق توصیه میشود. خوشبختانه، پشتیبانی 24/7 Soika این شکاف را پر میکند و میتواند در مراحل ابتدایی راهنماییهای لازم را ارائه دهد.
سوال دوم: هزینه برق این سیستم قابل توجه است؟ چگونه میتوان آن را مدیریت کرد؟
هر GPU H200 حداکثر 700 وات مصرف میکند، بنابراین چهار GPU در حالت بار کامل حدود 2800 وات مصرف دارند. با احتساب پردازندهها، حافظه و سایر قطعات، کل سیستم حدود 3500-4000 وات در پیک مصرف میکند. در مناطقی با تعرفه برق بالا، این میتواند هزینه قابل توجهی باشد. راهحلها شامل: استفاده از زمانبندی هوشمند برای اجرای آموزشها در ساعات غیرپیک، استفاده از حالت Power Capping که مصرف را محدود میکند اما عملکرد را کمی کاهش میدهد، و سرمایهگذاری روی سیستمهای خنککننده کارآمد که دمای محیط را پایین نگه میدارند و نیاز به کولر را کم میکنند.
سوال سوم: تفاوت H200 NVL با H200 SXM چیست و کدام در Soika استفاده میشود؟
دو نسخه H200 وجود دارد: SXM و NVL. نسخه SXM برای سرورهای مراکز داده با اتصال NVLink Switch طراحی شده و پهنای باند بین GPUها بالاتر دارد. نسخه NVL با رابط PCIe است و برای ورک استیشنها و سرورهای استاندارد مناسب است. Soika H200 Workstation میتواند از هر دو نسخه پشتیبانی کند، اما معمولاً نسخه NVL استفاده میشود که انعطاف بیشتری در پیکربندی دارد و هزینه کمتری نیز دارد. برای اکثر کاربردها، تفاوت عملکردی بین این دو نسخه کمتر از 10 درصد است.
سوال چهارم: آیا میتوان از ترکیب H200 و H100 در یک سیستم استفاده کرد؟
از نظر فنی امکانپذیر است اما توصیه نمیشود. دلیل اصلی این است که در آموزش توزیعشده، تمام GPUها باید با سرعت یکسانی کار کنند. اگر یک H100 کندتر از H200 باشد، سه H200 دیگر باید منتظر آن بمانند و این کل سیستم را کند میکند. استثنا زمانی است که میخواهید پروژههای مختلف را بهصورت مستقل روی GPUهای مختلف اجرا کنید، در این صورت مشکلی نیست. اما برای بهرهوری بهینه، استفاده از GPUهای یکسان توصیه قوی است.
سوال پنجم: چقدر طول میکشد تا سیستم بهطور کامل راهاندازی شود و آماده استفاده باشد؟
از زمان تحویل سختافزار، راهاندازی فیزیکی (نصب، اتصال کابلها، روشن کردن) حدود 2-3 ساعت زمان میبرد. پس از آن، Soika Stack بهطور خودکار سیستمعامل و درایورها را نصب میکند که 1-2 ساعت دیگر طول میکشد. نصب فریمورکهای یادگیری عمیق و دانلود مدلهای مورد نظر بسته به سرعت اینترنت میتواند 4-8 ساعت طول بکشد. در مجموع، سیستم میتواند در عرض یک روز کاری کاملاً آماده و بهینه شده باشد. برای مقایسه، راهاندازی دستی یک سیستم مشابه بدون Soika Stack میتواند یک هفته زمان ببرد.
سوال ششم: آیا میتوان این سیستم را به کلاسترهای موجود متصل کرد؟
بله، Soika H200 با استانداردهای شبکهای صنعتی سازگار است و میتواند به کلاسترهای Kubernetes، Slurm و سایر سیستمهای مدیریت منابع متصل شود. از طریق رابط شبکه InfiniBand یا Ethernet با سرعت بالا، میتوان چندین ورک استیشن را به هم متصل کرده و یک کلاستر بزرگ ایجاد کرد. این امر برای سازمانهایی که بهتدریج در حال رشد هستند و میخواهند شروع کوچک کرده و بعداً گسترش دهند، بسیار مناسب است. راهکارهای مقیاسپذیر سوان تک نیز بر همین اصل استوار است: شروع با آنچه نیاز دارید و رشد با نیازهای واقعی.
سوال هفتم: بازگشت سرمایهگذاری برای این سیستم در چه مدتی محقق میشود؟
بازگشت سرمایه بهشدت به نوع استفاده بستگی دارد. برای یک استارتآپ AI که قبلاً ماهانه 8000 دلار برای GPUهای ابری هزینه میکرد، سیستم H200 با قیمت حدود 180 هزار دلار ظرف 22-24 ماه هزینه خود را جبران میکند. برای یک شرکت تحقیقاتی که سرعت توسعه مهمتر از هزینه است، ارزش واقعی در کاهش Time-to-Market است: اگر محصول شما 6 ماه زودتر به بازار برسد، ارزش آن میتواند میلیونها دلار باشد. برای دانشگاهها و مؤسسات غیرانتفاعی، بازگشت سرمایه ممکن است به صورت تعداد مقالات منتشرشده، دانشجویان آموزشدیده و پروژههای تحقیقاتی باشد.
سوال هشتم: چگونه میتوان از عملکرد بهینه اطمینان حاصل کرد و از تنگناهای محاسباتی جلوگیری نمود؟
بهینهسازی عملکرد یک فرآیند مستمر است. نکات کلیدی شامل: استفاده از Mixed Precision Training که استفاده از FP16/BF16 بهجای FP32 را شامل میشود، بهینهسازی Batch Size برای پر کردن کامل حافظه GPU، استفاده از Data Loaders موازی که دادهها را از قبل آماده میکنند، فعالسازی Gradient Checkpointing برای مدلهای بزرگ، استفاده از Compiled Models در PyTorch 2.0+ که سرعت را تا 40% افزایش میدهد، نظارت مداوم با ابزارهایی مانند nvidia-smi و TensorBoard برای شناسایی تنگناها، و استفاده از توصیههای بهینهسازی Soika Stack که بهطور خاص برای H200 تنظیم شدهاند. تیم پشتیبانی Soika میتواند Audit عملکرد انجام دهد و راهکارهای خاص برای کاربرد شما پیشنهاد دهد.
نتیجهگیری: سرمایهگذاری هوشمندانه برای آیندهای مبتنی بر هوش مصنوعی
در عصر هوش مصنوعی، داشتن زیرساخت محاسباتی مناسب دیگر یک انتخاب نیست، بلکه یک ضرورت استراتژیک است. Soika H200 Workstation با ترکیب فناوری نوین حافظه HBM3e، پیکربندی قدرتمند 4-way GPU، و پلتفرم نرمافزاری یکپارچه Soika Stack، راهکاری جامع برای سازمانهایی است که میخواهند در مقدمه انقلاب هوش مصنوعی قرار گیرند.
این ورک استیشن نهتنها قدرت محاسباتی بیسابقهای ارائه میدهد، بلکه با دسترسی به کتابخانه گسترده مدلهای آماده، پشتیبانی 24/7 تخصصی و قابلیت مقیاسپذیری، تضمین میکند که سرمایهگذاری شما نهتنها امروز بلکه برای سالهای آینده نیز ارزشمند خواهد بود. با 564 گیگابایت حافظه مجموع، 19.2 ترابایت بر ثانیه پهنای باند، و 16 پتافلاپس قدرت محاسباتی FP8، این سیستم میتواند پیچیدهترین مدلهای یادگیری عمیق را هم آموزش دهد و هم در محیط تولید استقرار دهد.
برای سازمانهایی که به دنبال زیرساختهای پایدار، امن و قابل اتکا هستند، Soika H200 Workstation گزینهای است که هم نیازهای فعلی را برآورده میکند و هم برای چالشهای آینده آمادگی دارد. این سرمایهگذاری نهتنها یک خرید سختافزاری، بلکه قدمی استراتژیک به سمت تسلط بر فناوریهای هوش مصنوعی و تضمین رقابتپذیری در آینده است.