
مقالات و اخبار تکنولوژی
راهنمای جامع AI Workstation: انتخاب، خرید و استفاده از ورک استیشن هوش مصنوعی


در عصری که هوش مصنوعی به محور اصلی توسعه فناوری در سازمانها و کسبوکارها تبدیل شده است، انتخاب زیرساخت محاسباتی مناسب دیگر یک انتخاب ساده تکنولوژیک نیست، بلکه تصمیمی استراتژیک است که میتواند مسیر رشد و نوآوری یک سازمان را برای سالهای آینده تعیین کند. در این میان، ورک استیشن هوش مصنوعی به عنوان ستون فقرات زیرساخت محاسباتی، نقشی حیاتی در موفقیت پروژههای یادگیری ماشین و یادگیری عمیق ایفا میکنند.
این راهنمای جامع با هدف ارائه تمامی اطلاعاتی که برای درک، انتخاب، خرید و بهرهبرداری بهینه از ورک استیشن هوش مصنوعی نیاز دارید، تدوین شده است. چه یک مدیر فنی باشید که میخواهید برای تیم خود بهترین تجهیزات را تهیه کنید، چه یک محقق یا دانشمند داده که به دنبال ارتقای توان محاسباتی خود هستید، یا یک تصمیمگیرنده سازمانی که میخواهید سرمایهگذاری آگاهانهای در حوزه هوش مصنوعی انجام دهید، این راهنما همه آنچه باید بدانید را پوشش میدهد.
در طول این مقاله، به بررسی عمیق اجزای کلیدی ورک استیشنهای AI، تفاوتهای اساسی آنها با سرورها و سیستمهای معمولی، مزایای استفاده از محصولات برتر بازار مانند Soika H200 و Soika 4×H100، و همچنین راهنمای گامبهگام انتخاب متناسب با نیازهای خاص شما خواهیم پرداخت. با ما همراه باشید تا با نگاهی علمی و عملی، دنیای پیچیده اما جذاب ورک استیشنهای هوش مصنوعی را کاوش کنیم.
ورک استیشن هوش مصنوعی چیست؟ درک مفهوم و کاربردها
ورک استیشن هوش مصنوعی یک سیستم رایانهای تخصصی است که بهطور خاص برای پردازش بارهای کاری سنگین یادگیری ماشین، یادگیری عمیق و کاربردهای پیشرفته هوش مصنوعی طراحی شده است. برخلاف رایانههای شخصی معمولی که برای کارهای روزمره مانند تایپ، مرور وب و کارهای اداری بهینه شدهاند، ورک استیشنهای AI با قدرت پردازشی چندین برابر، حافظههای بزرگ و واحدهای پردازش گرافیکی قدرتمند مجهز هستند تا بتوانند محاسبات پیچیده و حجیم مربوط به مدلهای هوش مصنوعی را به سرعت و با دقت بالا انجام دهند.
تفاوت اصلی ورک استیشنهای هوش مصنوعی با سایر سیستمها در معماری سختافزاری آنها نهفته است. این سیستمها معمولاً دارای یک یا چند واحد پردازش گرافیکی یا GPU قدرتمند هستند که برخلاف کارتهای گرافیک معمولی که برای بازی طراحی شدهاند، بهطور خاص برای محاسبات موازی و عملیات ماتریسی بهینه شدهاند. علاوه بر این، پردازندههای مرکزی با تعداد هسته بالا، حافظههای رم با ظرفیت بزرگ و سرعت بالا، و سیستمهای ذخیرهسازی سریع مانند NVMe SSD از دیگر ویژگیهای بارز این سیستمها هستند.
در حوزه کاربردها، ورک استیشنهای هوش مصنوعی در طیف گستردهای از صنایع و زمینهها مورد استفاده قرار میگیرند. در بخش تحقیقات علمی، محققان از این سیستمها برای آموزش مدلهای یادگیری عمیق روی دادههای عظیم استفاده میکنند. در صنعت پزشکی، این ورک استیشنها برای تحلیل تصاویر پزشکی، تشخیص بیماریها و کشف داروهای جدید به کار میروند. در حوزه مالی، تحلیل دادههای بازار و پیشبینی روندها با استفاده از الگوریتمهای پیشرفته یادگیری ماشین انجام میشود. صنعت خودرو برای توسعه سیستمهای خودران، و صنایع خلاق برای تولید محتوا، طراحی گرافیک و ویرایش ویدئو نیز از این فناوری بهره میبرند.
شایان ذکر است که سوان تک به عنوان یکی از ارائهدهندگان پیشرو زیرساختهای IT و AI در ایران، تمرکز ویژهای بر تأمین، طراحی و پشتیبانی ورک استیشنهای هوش مصنوعی با تحویل سریع، گارانتی معتبر و پشتیبانی ۲۴/۷ دارد. این رویکرد سازمانی تضمین میکند که کسبوکارها بتوانند بدون نگرانی از مسائل فنی، به توسعه پروژههای هوش مصنوعی خود بپردازند.
اجزای کلیدی یک ورک استیشن هوش مصنوعی حرفهای
برای درک عمیقتر از نحوه عملکرد ورک استیشنهای هوش مصنوعی و انتخاب سیستم مناسب، ضروری است که با اجزای اصلی این سیستمها آشنا شویم. هر یک از این اجزا نقش خاصی در عملکرد کلی سیستم ایفا میکنند و توازن مناسب بین آنها میتواند تفاوت قابل توجهی در کارایی نهایی ایجاد کند.
واحد پردازش گرافیکی (GPU): قلب تپنده ورک استیشن AI
واحد پردازش گرافیکی یا GPU بیشک مهمترین جزء یک ورک استیشن هوش مصنوعی است. برخلاف پردازندههای مرکزی که برای اجرای دستورات به صورت سریال طراحی شدهاند، GPUها برای پردازش موازی هزاران عملیات همزمان بهینه شدهاند. این ویژگی دقیقاً همان چیزی است که یادگیری عمیق به آن نیاز دارد، زیرا آموزش شبکههای عصبی شامل انجام میلیونها عملیات ماتریسی به صورت مکرر است.
در بازار GPUهای حرفهای برای هوش مصنوعی، شرکت NVIDIA جایگاه رهبری بلامنازع دارد. محصولاتی مانند سری RTX Enterprise، سری A-Series (شامل A100 و A6000) و جدیدترین نسل H-Series (مانند H100 و H200) از این شرکت، استاندارد صنعت برای محاسبات هوش مصنوعی محسوب میشوند. این GPUها دارای معماریهای پیشرفتهای هستند که شامل هستههای Tensor اختصاصی برای عملیات یادگیری عمیق، هستههای RT برای پردازش نوری، و حافظههای HBM یا HBM3e با پهنای باند بسیار بالا هستند.
برای مثال، NVIDIA H200 که یکی از پیشرفتهترین GPUهای موجود در بازار است، دارای ۱۴۱ گیگابایت حافظه HBM3e با پهنای باند ۴.۸ ترابایت بر ثانیه است. این مشخصات باورنکردنی به معنای آن است که این GPU میتواند مدلهای زبانی بزرگ با صدها میلیارد پارامتر را در حافظه خود نگه دارد و با سرعتی شگفتانگیز پردازش کند. در مقایسه، GPUهای معمولی بازی مانند RTX 4090 تنها ۲۴ گیگابایت حافظه دارند که برای بسیاری از مدلهای پیشرفته کافی نیست.
نکته مهم دیگر در انتخاب GPU، تعداد آنها در سیستم است. بسیاری از ورک استیشنهای حرفهای قابلیت نصب چندین GPU را دارند. به عنوان نمونه، Soika 4×H100 Workstation میتواند تا چهار واحد H100 را پشتیبانی کند که در مجموع ۳۲۰ گیگابایت حافظه GPU و قدرت محاسباتی باورنکردنی فراهم میآورد. این پیکربندی برای آموزش مدلهای بسیار بزرگ یا اجرای چندین پروژه بهطور همزمان ایدهآل است.
پردازنده مرکزی (CPU): هماهنگکننده عملیات
اگرچه GPU قلب تپنده یک ورک استیشن AI است، پردازنده مرکزی نقش حیاتی به عنوان هماهنگکننده و مدیر کل سیستم ایفا میکند. CPU مسئول اجرای سیستمعامل، مدیریت ورودی و خروجی دادهها، پیشپردازش اطلاعات قبل از ارسال به GPU، و هماهنگی بین اجزای مختلف سیستم است. در واقع، بدون یک CPU قدرتمند، حتی بهترین GPUها نمیتوانند عملکرد بهینه خود را ارائه دهند.
در ورک استیشنهای سازمانی، معمولاً از پردازندههای سری Intel Xeon یا AMD EPYC استفاده میشود. این پردازندهها برخلاف CPUهای مصرفکنندهمحور، دارای ویژگیهایی مانند پشتیبانی از حافظه ECC (تصحیح خطا)، تعداد هسته بسیار بالا، و قابلیت اطمینان بالا برای عملیات ۲۴/۷ هستند. برای مثال، پردازنده Intel Xeon w9-3595X که در ورک استیشنهای Soika استفاده میشود، دارای ۶۰ هسته و ۱۲۰ رشته است که میتواند بارهای کاری سنگین چندنخی را به راحتی مدیریت کند.
تعداد هستههای CPU بهویژه در سناریوهایی که نیاز به پردازش موازی دادهها قبل از ارسال به GPU وجود دارد، اهمیت مییابد. فرآیندهایی مانند بارگذاری و تبدیل دادهها، افزایش داده، و عملیات پیشپردازش معمولاً روی CPU انجام میشوند. CPUهای با هسته بیشتر میتوانند این وظایف را سریعتر انجام دهند و از ایجاد تنگنا در خط لوله پردازش جلوگیری کنند.
حافظه سیستم (RAM): فضای کار موقت
حافظه رم یا RAM نقش فضای کار موقت سیستم را ایفا میکند. در پروژههای هوش مصنوعی، مجموعه دادهها اغلب حجم قابل توجهی دارند و بارگذاری آنها در RAM به جای خواندن مکرر از دیسک، سرعت پردازش را به طور چشمگیری افزایش میدهد. علاوه بر این، بسیاری از فریمورکهای یادگیری ماشین مانند PyTorch و TensorFlow از RAM برای ذخیرهسازی موقت دادهها، مدلها و نتایج میانی استفاده میکنند.
ورک استیشنهای حرفهای معمولاً با ۱۲۸ گیگابایت تا ۵۱۲ گیگابایت حافظه رم مجهز هستند. استفاده از حافظههای ECC (Error-Correcting Code) که توانایی تشخیص و تصحیح خودکار خطاهای دادهای را دارند، در محیطهای سازمانی یک ضرورت است. این تکنولوژی از بروز خطاهای کوچک که میتوانند در محاسبات طولانیمدت تأثیرگذار باشند، جلوگیری میکند و قابلیت اطمینان سیستم را تضمین مینماید.
در مورد نوع حافظه نیز، استانداردهای جدید مانند DDR5 نسبت به DDR4 سرعت بالاتر و مصرف انرژی کمتری دارند. حافظههای DDR5-4800 که در ورک استیشنهای Soika استفاده میشوند، پهنای باند بالاتری نسبت به نسلهای قبلی ارائه میدهند و این به معنای انتقال سریعتر دادهها بین CPU، RAM و GPU است.
سیستم ذخیرهسازی: سرعت دسترسی به دادهها
در دنیای هوش مصنوعی که مجموعه دادهها میتوانند از چند گیگابایت تا چندین ترابایت حجم داشته باشند، سیستم ذخیرهسازی سریع و قابل اعتماد اهمیت حیاتی دارد. هارد دیسکهای سنتی (HDD) با سرعت خواندن و نوشتن پایین خود، برای پروژههای یادگیری عمیق مناسب نیستند و میتوانند به بزرگترین تنگنای سیستم تبدیل شوند.
به همین دلیل، ورک استیشنهای حرفهای از حافظههای NVMe SSD استفاده میکنند که سرعتی چندین برابر بیشتر از SSDهای معمولی SATA دارند. درایوهای NVMe با رابط PCIe 4.0 یا 5.0 میتوانند سرعت خواندن و نوشت بالای ۷۰۰۰ مگابایت بر ثانیه را ارائه دهند. این سرعت بالا به معنای آن است که بارگذاری مجموعه دادههای بزرگ، ذخیره checkpointهای مدل در حین آموزش، و خواندن batchهای داده به طور مداوم، بدون ایجاد تأخیر انجام میشود.
برای کاربردهای سازمانی که نیاز به فضای ذخیرهسازی بسیار زیاد دارند، ورک استیشنهایی مانند Soika تا ۳۲ ترابایت فضای ذخیرهسازی NVMe را پشتیبانی میکنند. این ظرفیت کافی برای ذخیره چندین مجموعه داده، نسخههای مختلف مدلها، و نتایج آزمایشهای متعدد است. علاوه بر این، امکان پیکربندی درایوها در آرایه RAID برای افزایش سرعت یا امنیت دادهها نیز وجود دارد.
خنککاری و تأمین برق: نگهداشتن سیستم در دمای مناسب
با قدرت محاسباتی بالا، مصرف انرژی و تولید گرما نیز افزایش مییابد. یک GPU قدرتمند مانند H100 میتواند تا ۷۰۰ وات توان مصرف کند و در یک سیستم با چهار GPU، مصرف کل میتواند به بیش از ۳۵۰۰ وات برسد. این میزان مصرف انرژی نیازمند سیستم تأمین برق قدرتمند و قابل اعتماد است.
همچنین، سیستم خنککاری باید به گونهای طراحی شود که بتواند گرمای تولیدشده را به طور مؤثر دفع کند. ورک استیشنهای حرفهای از ترکیبی از خنککاری هوایی با فنهای قدرتمند و خنککاری مایع برای اجزای حساس مانند CPU و GPU استفاده میکنند. سیستمهای خنککاری مایع میتوانند دمای سیستم را تا ۲۰ درجه سانتیگراد کاهش دهند و عمر مفید اجزا را افزایش دهند.
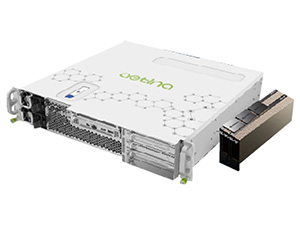
تفاوتهای کلیدی بین ورک استیشن و سرور AI: کدام برای شما مناسبتر است؟
یکی از سوالات متداولی که سازمانها و افراد در هنگام سرمایهگذاری روی زیرساخت هوش مصنوعی با آن مواجه میشوند، انتخاب بین ورک استیشن و سرور است. هر دو راهکار مزایا و محدودیتهای خاص خود را دارند و انتخاب صحیح بستگی به نیازها، بودجه و سناریوهای کاربردی شما دارد. در مقاله تخصصی مقایسه ورک استیشن و سرور AI این موضوع به طور مفصل بررسی شده است، اما در اینجا به نکات کلیدی میپردازیم.
فلسفه طراحی: تککاربره در برابر چندکاربره
تفاوت اساسی بین ورک استیشن و سرور در فلسفه طراحی آنها نهفته است. ورک استیشنها برای استفاده تککاربره یا تیمی کوچک طراحی شدهاند که هر کاربر نیاز به دسترسی مستقیم و انحصاری به منابع محاسباتی دارد. این سیستمها معمولاً در محیط دفتر کاری، آزمایشگاه تحقیقاتی یا فضای توسعه قرار میگیرند و کاربر به صورت محلی با آنها تعامل دارد. رابط کاربری گرافیکی، امکان نصب مانیتورهای متعدد، و دسترسی فیزیکی آسان از ویژگیهای بارز ورک استیشنها هستند.
در مقابل، سرورها برای ارائه خدمات به کاربران متعدد به صورت همزمان طراحی شدهاند. این سیستمها معمولاً در دیتاسنترها یا اتاقهای سرور نصب میشوند و کاربران از طریق شبکه و به صورت remote به آنها دسترسی پیدا میکنند. سرورها برای کار ۲۴/۷ بدون وقفه بهینه شدهاند و دارای قابلیتهای افزونگی (Redundancy) مانند منابع تغذیه دوگانه، سیستم خنککاری پیشرفته و قطعات یدکی هستند.
مقیاسپذیری و ظرفیت: محدود در برابر گسترده
ورک استیشنها معمولاً قابلیت نصب یک تا چهار GPU را دارند. این ظرفیت برای اکثر پروژههای تحقیقاتی، توسعه مدل و کاربردهای سازمانی کوچک تا متوسط کاملاً کافی است. با این حال، برای آموزش مدلهای بسیار بزرگ که نیاز به دهها GPU دارند، ورک استیشن محدودیت دارد.
سرورها از سوی دیگر، میتوانند از چهار GPU تا ۱۶ GPU یا حتی بیشتر را در یک سیستم یا کلاستر پشتیبانی کنند. برای مثال، سرورهای مبتنی بر معماری NVIDIA DGX میتوانند هشت کارت A100 یا H100 را با اتصالات پرسرعت NVSwitch داشته باشند. علاوه بر این، سرورها قابلیت مقیاسپذیری افقی را دارند، به این معنا که میتوان چندین سرور را در یک کلاستر متصل کرد و به صورت یکپارچه استفاده نمود.
همچنین، از نظر حافظه سیستم و ذخیرهسازی، سرورها ظرفیت بسیار بیشتری دارند. یک سرور میتواند تا چندین ترابایت RAM و پتابایتها فضای ذخیرهسازی با سیستمهای RAID پیشرفته را پشتیبانی کند، در حالی که ورک استیشنها معمولاً به ۵۱۲ گیگابایت RAM و چند ترابایت ذخیرهسازی محدود هستند.
هزینه اولیه و نگهداری: سرمایهگذاری کوتاهمدت در برابر بلندمدت
از نظر هزینه، ورک استیشن هوش مصنوعی بازه قیمتی گستردهای دارند که بسته به پیکربندی از ۵۰۰۰ دلار تا ۲۵۰۰۰ دلار متغیر است. برای مثال، یک ورک استیشن مبتدی با یک GPU RTX 4090 ممکن است حدود ۸۰۰۰ دلار هزینه داشته باشد، در حالی که یک سیستم پیشرفته مانند Soika H200 با چهار GPU میتواند بیش از ۱۵۰۰۰۰ دلار قیمت داشته باشد. با این حال، هزینه نگهداری ورک استیشن هوش مصنوعینسبتاً پایین است، معمولاً ۵ تا ۱۰ درصد قیمت اولیه در سال.
سرورها از سوی دیگر، سرمایهگذاری اولیه بسیار بالاتری دارند. یک سرور مبتدی با چهار GPU H100 میتواند ۸۰۰۰۰ تا ۱۵۰۰۰۰ دلار هزینه داشته باشد و سیستمهای پیشرفتهتر میتوانند به چندین صد هزار دلار برسند. علاوه بر این، هزینههای نگهداری سرورها شامل هزینه برق (که برای یک سرور پرقدرت میتواند ۲۰۰ تا ۵۰۰ دلار در ماه باشد)، هزینه خنککاری اتاق سرور، و هزینه تیم IT برای مدیریت و نگهداری است. این هزینههای عملیاتی میتوانند سالانه ۱۵ تا ۲۵ درصد قیمت اولیه را شامل شوند.
سناریوهای کاربردی: چه زمانی ورک استیشن انتخاب درست است؟
بر اساس تحلیلهای ارائه شده در راهنمای ورک استیشن هوش مصنوعی Soika AI، چندین سناریو وجود دارد که در آنها استفاده از ورک استیشن نسبت به سرور منطقیتر و مقرونبهصرفهتر است:
توسعه و تحقیق فردی یا تیمی کوچک: اگر یک محقق یا یک تیم کوچک (۱ تا ۵ نفر) هستید که روی پروژههای هوش مصنوعی کار میکنید، ورک استیشن بهترین گزینه است. هر عضو تیم میتواند ورک استیشن اختصاصی خود را داشته باشد و بدون انتظار برای آزاد شدن منابع، به صورت مستقل کار کند. این رویکرد بهرهوری را به طور چشمگیری افزایش میدهد.
پروتوتایپینگ سریع و آزمایش و خطا: در مراحل اولیه توسعه مدل که نیاز به آزمایش دهها معماری مختلف، هایپرپارامترهای متنوع و مجموعه دادههای گوناگون دارید، ورک استیشن محلی بهترین محیط است. میتوانید بلافاصله پس از تغییر کد، آن را اجرا کنید و نتایج را مشاهده نمایید، بدون نیاز به آپلود کد به سرور، صف انتظار و دانلود نتایج.
آموزش مدلهای کوچک تا متوسط: برخلاف تصور عمومی، نه همه مدلهای هوش مصنوعی نیازمند صدها GPU هستند. بسیاری از کاربردهای عملی با مدلهایی که چند میلیون تا چند صد میلیون پارامتر دارند، به خوبی حل میشوند. این مدلها را میتوان در مدت زمان معقول (چند ساعت تا چند روز) روی ورک استیشنهای مجهز به GPUهای مدرن آموزش داد.
کار روی دادههای حساس و محرمانه: در صنایعی مانند بانکداری، بهداشت و درمان و دفاع، دادهها نمیتوانند از سیستم محلی خارج شوند. در چنین شرایطی، ورک استیشنهای اختصاصی که دادهها روی هارد دیسکهای محلی و رمزنگاریشده ذخیره میشوند، گزینه امنتری هستند.
استارتاپها و کسبوکارهای کوچک: استارتاپهایی که تازه شروع به کار کردهاند و بودجه محدودی دارند، میتوانند با خرید یک یا دو ورک استیشن شروع کنند و با رشد نیازها، به تدریج ظرفیت را افزایش دهند. این رویکرد ریسک مالی را کاهش میدهد.
جدول مقایسه جامع ورک استیشن هوش مصنوعی و سرور AI
| معیار مقایسه | ورک استیشن AI | سرور AI |
|---|---|---|
| تعداد GPU | ۱ تا ۴ کارت | ۴ تا ۱۶+ کارت |
| حافظه GPU | ۱۲ تا ۱۹۲ گیگابایت (کل) | ۱۶۰ تا ۱۲۸۰+ گیگابایت (کل) |
| کاربران همزمان | ۱ تا ۳ نفر | ۱۰ تا ۱۰۰+ نفر |
| محیط نصب | دفتر کار، آزمایشگاه | دیتاسنتر، اتاق سرور |
| رابط کاربری | مستقیم با مانیتور و کیبورد | Remote از طریق شبکه |
| سیستم عامل | Windows Pro, Linux Desktop | Windows Server, Linux Server |
| قابلیت اطمینان | متوسط تا بالا | بسیار بالا با افزونگی |
| مصرف برق | ۵۰۰ تا ۱۵۰۰ وات | ۱۵۰۰ تا ۱۰۰۰۰+ وات |
| سطح صدا | متوسط | بسیار بالا (نیاز به اتاق جدا) |
| قیمت اولیه | ۵۰۰۰ تا ۲۵۰۰۰ دلار | ۲۰۰۰۰ تا ۵۰۰۰۰۰+ دلار |
| هزینه نگهداری سالانه | ۵-۱۰٪ قیمت اولیه | ۱۵-۲۵٪ قیمت اولیه |
| زمان راهاندازی | ۱ تا ۳ روز | ۱ تا ۴ هفته |
| انعطافپذیری | بالا (قابل حمل) | محدود (ثابت) |
| پشتیبانی فنی | معمولی | حرفهای ۲۴/۷ |
| بهترین کاربرد | تحقیق، توسعه، پروتوتایپ | تولید، خدمات، مقیاس بزرگ |
معرفی ورک استیشنهای Soika: پیشرفتهترین محصولات بازار
در بازار ورک استیشنهای هوش مصنوعی، محصولات خانواده Soika با ترکیب فناوریهای روز دنیا، کیفیت ساخت بالا و پشتیبانی حرفهای، جایگاه ویژهای به دست آوردهاند. سوان تک به عنوان نماینده رسمی این برند در ایران، طیف کاملی از این محصولات را با خدمات پس از فروش معتبر ارائه میدهد. در این بخش، به بررسی دو مدل برتر این خانواده میپردازیم.
Soika H200 Workstation: قدرت نسل جدید حافظه
ورک استیشن Soika H200 یکی از پیشرفتهترین سیستمهای موجود در بازار است که با بهرهگیری از GPUهای NVIDIA H200 مجهز به حافظه HBM3e، استانداردهای جدیدی را در حوزه پردازش هوش مصنوعی تعریف میکند. این ورک استیشن برای سازمانهایی طراحی شده است که به پردازش مدلهای زبانی بزرگ، شبیهسازیهای علمی پیچیده و کاربردهای پیشرفته یادگیری عمیق نیاز دارند.
مشخصات کلیدی Soika H200:
- GPU: تا ۴ عدد NVIDIA H200 با ۱۴۱ گیگابایت حافظه HBM3e در هر کارت
- پهنای باند حافظه: ۴.۸ ترابایت بر ثانیه در هر GPU
- پردازنده: دو عدد Intel Xeon w9-3595X (۱۲۰ هسته، ۲۴۰ رشته)
- حافظه سیستم: ۵۱۲ گیگابایت DDR5-4800 ECC
- ذخیرهسازی: ۳۲ ترابایت NVMe (۴×۸ ترابایت)
- اتصال GPU: NVLink با پهنای باند ۶۰۰ گیگابایت/ثانیه
ویژگی برجسته این سیستم، استفاده از حافظه HBM3e است که نسبت به نسل قبلی (HBM3)، ۴۰ درصد پهنای باند بیشتر و ۷۶ درصد ظرفیت بیشتر دارد. این مشخصات به معنای آن است که میتوانید مدلهای زبانی با بیش از ۴۰۰ میلیارد پارامتر را روی یک GPU H200 اجرا کنید، و با چهار GPU، مدلهایی با چندین تریلیون پارامتر قابل پردازش هستند.
کاربردهای ایدهآل این سیستم شامل آموزش مدلهای زبانی بزرگ مانند GPT و LLaMA، استنتاج سریع برای سرویسهای مکالمهای، تحلیل ژنومیک و بیوانفورماتیک، شبیهسازیهای پیشرفته دینامیک سیالات و فیزیک، و پژوهشهای علمی در حوزه هوش مصنوعی است.
Soika 4×H100 Workstation: قدرت محاسباتی بینظیر
ورک استیشن Soika 4×H100 یک ابررایانه میزی است که با پشتیبانی از چهار GPU H100، قدرت محاسباتی معادل یک مرکز داده کوچک را در اختیار شما قرار میدهد. این سیستم برای سازمانهایی مناسب است که نیاز به پردازش موازی حجم زیادی از دادهها، آموزش همزمان چندین مدل، یا اجرای کاربردهای real-time هوش مصنوعی دارند.
مشخصات کلیدی Soika 4×H100:
- GPU: چهار عدد NVIDIA H100 80GB
- حافظه GPU کل: ۳۲۰ گیگابایت HBM3
- قدرت محاسباتی: ۱۶ پتافلاپ (FP8) کل سیستم
- پردازنده: دو عدد Intel Xeon w9-3595X (۱۲۰ هسته)
- حافظه سیستم: ۵۱۲ گیگابایت DDR5 ECC
- ذخیرهسازی: ۳۲ ترابایت NVMe
معماری Hopper در GPUهای H100 شامل Transformer Engine است که به طور خاص برای تسریع آموزش و استنتاج مدلهای مبتنی بر Transformer طراحی شده است. این موتور به طور خودکار دقت محاسبات را تنظیم میکند و بدون کاهش دقت مدل، سرعت را تا ۳۰ درصد افزایش میدهد.
با قدرت محاسباتی این سیستم، میتوانید یک مدل زبانی با ۷۰ میلیارد پارامتر را که روی یک GPU معمولی چندین هفته زمان میبرد، در کمتر از یک هفته آموزش دهید. این تسریع میتواند تفاوت بین موفقیت و شکست در بازارهای رقابتی باشد.
راهنمای انتخاب ورک استیشن مناسب: قدم به قدم تا تصمیم درست
انتخاب ورک استیشن هوش مصنوعی مناسب یک فرآیند چندمرحلهای است که نیازمند بررسی دقیق نیازها، بودجه و اهداف بلندمدت است. در راهنمای کامل ورک استیشن Soika این فرآیند به تفصیل شرح داده شده است، اما در اینجا به نکات کلیدی میپردازیم.
مرحله ۱: شناسایی نیازهای واقعی
اولین و مهمترین قدم، درک دقیق نیازهای خود است. برای این منظور، به سوالات زیر پاسخ دهید:
نوع پروژههای شما چیست؟ آیا روی بینایی ماشین، پردازش زبان طبیعی، یادگیری تقویتی، یا ترکیبی از اینها کار میکنید؟ هر یک از این حوزهها نیازمندیهای متفاوتی دارند. برای مثال، مدلهای بینایی ماشین معمولاً نیاز به GPUهای با حافظه متوسط اما سرعت بالا دارند، در حالی که مدلهای زبانی بزرگ نیاز به حافظه GPU بسیار زیاد دارند.
اندازه مدلهای شما چقدر است؟ آیا با مدلهای کوچک (چند میلیون پارامتر)، متوسط (چند صد میلیون پارامتر) یا بزرگ (میلیاردها پارامتر) کار میکنید؟ مدلهای کوچکتر میتوانند روی GPUهای با حافظه کمتر اجرا شوند، اما مدلهای بزرگ نیاز به GPUهای با حافظه زیاد دارند.
حجم دادههای شما چقدر است؟ آیا با مجموعه دادههای چند گیگابایتی، چند ترابایتی، یا بزرگتر کار میکنید؟ حجم داده تأثیر مستقیمی بر نیازهای حافظه RAM و ذخیرهسازی دارد.
چند نفر بهطور همزمان از سیستم استفاده میکنند؟ اگر یک نفر استفاده میکند، یک ورک استیشن تککاربره کافی است. اما اگر چند نفر نیاز به دسترسی همزمان دارند، باید به سراغ سیستمهایی با قابلیت مجازیسازی یا چندین ورک استیشن بروید.
بودجه شما چقدر است؟ بودجه عامل تعیینکنندهای در انتخاب است. ورک استیشنها طیف قیمتی گستردهای دارند و باید متناسب با بودجه خود، بهترین گزینه را پیدا کنید.
مرحله ۲: انتخاب GPU مناسب
GPU قلب تپنده ورک استیشن هوش مصنوعی است و مهمترین تصمیم در خرید، انتخاب GPU است. در اینجا راهنمایی کلی ارائه میدهیم:
برای مدلهای کوچک و متوسط (تا ۱۰۰ میلیون پارامتر): کارتهای RTX 4070 Ti یا RTX 4080 با ۱۲ تا ۱۶ گیگابایت حافظه کافی هستند. این کارتها هزینه معقولی دارند و برای پروژههای آموزشی، تحقیقاتی مقدماتی و استارتاپها مناسباند.
برای مدلهای بزرگ (۱۰۰ میلیون تا ۱ میلیارد پارامتر): کارتهای RTX 4090 یا RTX A6000 با ۲۴ تا ۴۸ گیگابایت حافظه را در نظر بگیرید. این کارتها میتوانند مدلهای پیچیدهتر را در زمان معقول آموزش دهند.
برای مدلهای بسیار بزرگ (بیش از ۱ میلیارد پارامتر): به GPUهای سری H مانند H100 یا H200 با ۸۰ تا ۱۴۱ گیگابایت حافظه نیاز دارید. این GPUها برای کاربردهای سازمانی و تحقیقات پیشرفته طراحی شدهاند.
تعداد GPU: اگر قصد دارید همزمان چند پروژه روی یک سیستم اجرا کنید یا مدلهای بسیار بزرگ آموزش دهید، به چند GPU نیاز دارید. سیستمهایی با ۲ یا ۴ GPU امکان توزیع بار کاری را فراهم میکنند.
مرحله ۳: تعیین مشخصات دیگر اجزا
پس از انتخاب GPU، باید سایر اجزا را نیز متناسب با آن انتخاب کنید:
CPU: برای هر GPU، حداقل ۸ تا ۱۲ هسته CPU را در نظر بگیرید. برای سیستمهای چهار GPU، پردازندههایی با ۶۰ تا ۱۲۰ هسته مانند Intel Xeon w9 ایدهآل هستند.
RAM: قانون کلی این است که حافظه RAM حداقل دو برابر مجموع حافظه GPUها باشد. برای مثال، اگر دو GPU با ۲۴ گیگابایت حافظه دارید (مجموعاً ۴۸ گیگابایت)، حداقل ۹۶ گیگابایت RAM نیاز دارید. برای کاربردهای سازمانی، ۲۵۶ تا ۵۱۲ گیگابایت RAM توصیه میشود.
ذخیرهسازی: حداقل ۱ ترابایت NVMe SSD برای سیستمعامل و نرمافزارها، به علاوه فضای کافی برای مجموعه دادهها و checkpointهای مدل. برای پروژههای با دادههای زیاد، ۴ تا ۸ ترابایت یا بیشتر در نظر بگیرید.
مرحله ۴: بررسی نرمافزار و اکوسیستم
یک ورک استیشن خوب نه تنها سختافزار قدرتمند دارد، بلکه باید از نرمافزارها و فریمورکهای مورد نیاز شما پشتیبانی کند. اطمینان حاصل کنید که:
- درایورهای CUDA و cuDNN بهروز و سازگار با GPU شما هستند
- فریمورکهای یادگیری عمیق مورد نیاز شما (TensorFlow, PyTorch, JAX) بدون مشکل اجرا میشوند
- ابزارهای مدیریت GPU مانند NVIDIA-SMI و Nsight Systems در دسترس هستند
- پلتفرمهای مدیریت مدل مانند MLflow, Weights & Biases قابل نصب هستند
ورک استیشنهای Soika با پلتفرمهای Soika Stack و Mockingjay عرضه میشوند که بسیاری از این نیازها را به صورت پیشپیکربندی شده ارائه میدهند و زمان راهاندازی را به حداقل میرسانند.
مرحله ۵: ارزیابی خدمات پس از فروش و پشتیبانی
در نهایت، خدمات پس از فروش و پشتیبانی فنی اهمیت حیاتی دارند. زمانی که با یک مشکل فنی مواجه میشوید و پروژه مهمی در انتظار است، پاسخگویی سریع و حل مشکل میتواند تفاوت بزرگی ایجاد کند. سوان تک با ارائه پشتیبانی ۲۴/۷، گارانتی معتبر و تحویل سریع تجهیزات، اطمینان میدهد که زیرساخت شما همیشه در حالت بهینه قرار دارد.
نکات کلیدی در ارزیابی پشتیبانی:
- مدت زمان گارانتی (معمولاً ۱ تا ۵ سال)
- شرایط تعویض قطعات معیوب
- دسترسی به پشتیبانی فنی (تلفنی، آنلاین، حضوری)
- زمان پاسخگویی (در چه مدت زمانی مشکل شما حل میشود)
- خدمات بهروزرسانی نرمافزار و درایور
کاربردهای تخصصی ورک استیشنهای AI در صنایع مختلف
ورک استیشنهای هوش مصنوعی در طیف گستردهای از صنایع کاربرد دارند و در هر یک، نقش متفاوتی ایفا میکنند. درک این کاربردها میتواند به شما کمک کند تا بهتر ارزیابی کنید که چگونه این فناوری میتواند به کسبوکار یا تحقیقات شما کمک کند.
صنعت سلامت و پزشکی: انقلابی در تشخیص و درمان
صنعت سلامت یکی از بزرگترین بهرهبرداران از فناوریهای هوش مصنوعی است. ورک استیشنهای قدرتمند در این حوزه برای کاربردهای متنوعی استفاده میشوند:
تحلیل تصاویر پزشکی: مدلهای یادگیری عمیق مانند U-Net، ResNet و EfficientNet برای تحلیل تصاویر MRI، CT Scan، اشعه ایکس و پاتولوژی دیجیتال آموزش داده میشوند. این مدلها میتوانند تومورها، ضایعات، آنومالیها و بیماریهای پیچیده را در مراحل اولیه تشخیص دهند. برای مثال، مدلهایی که روی میلیونها تصویر ماموگرافی آموزش دیدهاند، میتوانند سرطان پستان را با دقت بالاتر از متخصصان باتجربه شناسایی کنند.
ژنومیک و پزشکی شخصیسازیشده: تحلیل توالی DNA و RNA برای شناسایی جهشهای ژنتیکی، پیشبینی ریسک بیماریها و طراحی درمانهای هدفمند نیازمند قدرت محاسباتی عظیمی است. ورک استیشنهای مجهز به GPUهای H200 میتوانند دادههای ژنومیک یک فرد (حدود ۲۰۰ گیگابایت) را در عرض چند ساعت تحلیل کنند، در حالی که سیستمهای سنتی روزها زمان نیاز دارند.
کشف دارو و شبیهسازی مولکولی: فرآیند توسعه داروهای جدید معمولاً ۱۰ تا ۱۵ سال زمان و بیش از ۲ میلیارد دلار هزینه دارد. هوش مصنوعی میتواند با شبیهسازی نحوه تعامل مولکولهای دارویی با پروتئینهای هدف، این فرآیند را به چند سال کاهش دهد. مدلهایی مانند AlphaFold که پیشبینی ساختار پروتئین را انجام میدهند، نیاز به ورک استیشنهای بسیار قدرتمندی دارند.
سیستمهای تصمیمیار بالینی: مدلهای هوش مصنوعی میتوانند با تحلیل پرونده الکترونیک سلامت بیماران، نتایج آزمایشها، تاریخچه درمان و ادبیات پزشکی، به پزشکان در تشخیص دقیقتر و انتخاب درمان مناسبتر کمک کنند. این سیستمها میتوانند تداخلات دارویی را شناسایی کنند، دوزهای بهینه را پیشنهاد دهند و حتی نتایج احتمالی درمان را پیشبینی نمایند.
صنایع مالی: تحلیل هوشمند و مدیریت ریسک
بخش مالی و بانکی نیز از پیشگامان استفاده از هوش مصنوعی است. در این حوزه، سرعت و دقت تحلیل میتواند به معنای میلیونها دلار سود یا زیان باشد:
پیشبینی بازارهای مالی: مدلهای یادگیری ماشین با تحلیل دادههای تاریخی قیمت، حجم معاملات، اخبار، و حتی احساسات شبکههای اجتماعی، میتوانند روندهای بازار را پیشبینی کنند. این مدلها میتوانند الگوهای پیچیدهای را شناسایی کنند که برای تحلیلگران انسانی قابل مشاهده نیستند. الگوریتمهای معاملاتی مبتنی بر هوش مصنوعی میتوانند در کسری از ثانیه، تصمیمات خرید و فروش بگیرند.
تشخیص تقلب و کلاهبرداری: بانکها و شرکتهای کارت اعتباری هر روز با میلیونها تراکنش مواجه هستند. شناسایی تراکنشهای مشکوک در این حجم عظیم بدون هوش مصنوعی غیرممکن است. مدلهای یادگیری عمیق میتوانند الگوهای رفتاری غیرعادی را شناسایی کنند و بهطور خودکار تراکنشهای مشکوک را مسدود یا برای بررسی بیشتر علامتگذاری کنند. این سیستمها با یادگیری مداوم، خود را با تکنیکهای جدید کلاهبرداری هماهنگ میکنند.
ارزیابی اعتباری و مدیریت ریسک: سیستمهای سنتی ارزیابی اعتبار معمولاً بر چند متغیر محدود مانند تاریخچه اعتباری، درآمد و نسبت بدهی تکیه دارند. مدلهای هوش مصنوعی میتوانند صدها متغیر را همزمان تحلیل کنند و ارزیابی دقیقتری از ریسک ارائه دهند. این رویکرد منجر به تصمیمات وامدهی عادلانهتر و سودآورتر میشود.
مشاوره مالی رباتیک (Robo-Advisors): مدلهای هوش مصنوعی میتوانند پرتفوی سرمایهگذاری شخصیسازیشده برای افراد طراحی کنند، با در نظر گرفتن ریسکپذیری، افق سرمایهگذاری، و اهداف مالی آنها. این سیستمها میتوانند بهطور خودکار پرتفوی را بازتعادل کنند و در برابر تغییرات بازار واکنش نشان دهند.
صنعت خودرو و حملونقل: مسیر به سوی خودمختاری
صنعت خودرو در حال گذار از وسایل نقلیه سنتی به خودروهای هوشمند و خودران است. این تحول عظیم به شدت وابسته به پیشرفتهای هوش مصنوعی است:
سیستمهای خودران: خودروهای خودران باید بهطور همزمان دادههای دوربینها، سنسورهای لیدار، رادار، GPS و نقشههای دیجیتال را پردازش کنند و در کسری از ثانیه تصمیمات حیاتی بگیرند. آموزش مدلهای یادگیری عمیق برای درک محیط، تشخیص اشیا، پیشبینی رفتار عابران و خودروهای دیگر، و برنامهریزی مسیر، نیازمند پردازش مجموعه دادههای عظیمی از سناریوهای مختلف رانندگی است. این مجموعه دادهها میتوانند پتابایتها حجم داشته باشند.
سیستمهای کمک راننده پیشرفته (ADAS): حتی خودروهایی که کاملاً خودران نیستند، از سیستمهای هوشمندی مانند تشخیص خطوط جاده، هشدار نقطه کور، ترمز اضطراری خودکار و کروز کنترل تطبیقی بهره میبرند. این سیستمها همگی بر پایه مدلهای بینایی ماشین ساخته شدهاند که روی ورک استیشنهای قدرتمند آموزش داده میشوند.
شبیهسازی و تست مجازی: قبل از اینکه یک خودرو خودران در خیابانهای واقعی آزمایش شود، باید میلیونها کیلومتر در محیطهای شبیهسازیشده آزمایش گردد. این شبیهسازیها که شرایط مختلف جوی، ترافیکی و اضطراری را شامل میشوند، نیازمند قدرت محاسباتی عظیمی هستند.
تعمیر و نگهداری پیشبین: مدلهای یادگیری ماشین میتوانند با تحلیل دادههای سنسورهای خودرو، خرابیهای احتمالی را پیشبینی کنند و قبل از وقوع مشکل جدی، هشدار دهند. این رویکرد هزینههای تعمیرات را کاهش میدهد و ایمنی را افزایش میدهد.
صنایع خلاق و رسانهای: تولید محتوا و طراحی
هنرمندان، طراحان، فیلمسازان و شرکتهای رسانهای نیز از مشتریان مهم ورک استیشنهای هوش مصنوعی هستند:
تولید تصویر و ویدئو با AI: مدلهای تولیدی مانند Stable Diffusion، DALL-E و Midjourney توانایی ایجاد تصاویر واقعگرا یا هنری از توصیفات متنی را دارند. این فناوری میتواند فرآیند طراحی را به طور چشمگیری تسریع کند. یک طراح گرافیک میتواند در دقایق، دهها نسخه اولیه از یک طرح ایجاد کند و سپس بهترین را انتخاب و بهبود دهد.
ویرایش ویدئو هوشمند: مدلهای هوش مصنوعی میتوانند بهطور خودکار بهترین لحظات یک ویدئوی طولانی را شناسایی و یک خلاصه جذاب ایجاد کنند. همچنین میتوانند بهطور خودکار زیرنویس تولید کنند، صدا را بهبود دهند، رنگها را اصلاح نمایند و حتی افکتهای ویژه اضافه کنند.
مدلسازی سهبعدی و رندرینگ: ورک استیشنهای مجهز به هستههای RT میتوانند رندرینگ نوری در زمان واقعی را ارائه دهند. این به معنای آن است که طراحان میتوانند بلافاصله نتیجه تغییراتی که در مدل سهبعدی ایجاد میکنند را ببینند، بدون آنکه ساعتها منتظر فرآیند رندرینگ بمانند. این قابلیت برای استودیوهای انیمیشن، معماران و طراحان صنعتی بسیار ارزشمند است.
موسیقی و صدا: مدلهای هوش مصنوعی میتوانند موسیقی اصیل بسازند، صداها را بهبود دهند، نویز را حذف کنند و حتی صدای یک فرد را شبیهسازی نمایند. این فناوریها در تولید محتوای رسانهای، پادکستها و صنعت موسیقی کاربرد دارند.
تحقیق و توسعه علمی: شبیهسازی و کشف
محققان در رشتههای مختلف علمی از فیزیک و شیمی گرفته تا علوم زمین و نجوم، از ورک استیشنهای قدرتمند برای شبیهسازیهای پیچیده و تحلیل دادهها استفاده میکنند:
شبیهسازیهای فیزیکی: شبیهسازی دینامیک سیالات، پیشبینی آبوهوا، مدلسازی واکنشهای هستهای و شبیهسازی برخوردهای ذرات در شتابدهندهها، همگی نیازمند قدرت محاسباتی عظیمی هستند. GPUهای مدرن میتوانند این محاسبات را هزاران برابر سریعتر از CPUهای سنتی انجام دهند.
کشف دارو و طراحی مواد: محققان میتوانند با استفاده از یادگیری ماشین، مواد جدید با خواص خاص طراحی کنند یا ترکیبات شیمیایی با پتانسیل دارویی را شناسایی نمایند. این فرآیند که در گذشته سالها زمان میبرد، اکنون به ماهها یا حتی هفتهها کاهش یافته است.
تحلیل دادههای نجومی: تلسکوپهای مدرن هر شب تصاویر و دادههای عظیمی تولید میکنند. تحلیل این دادهها برای یافتن سیارههای فراخورشیدی، کشف اجرام کیهانی جدید، و درک ساختار جهان، نیازمند الگوریتمهای هوشمند و قدرت پردازشی بالا است.
ژنومیک و زیستشناسی محاسباتی: تحلیل توالیهای DNA، پیشبینی ساختار پروتئینها، و درک شبکههای بیولوژیکی پیچیده، همگی کاربردهایی هستند که از یادگیری عمیق بهره میبرند. AlphaFold از DeepMind که مشکل پیشبینی ساختار پروتئین را حل کرد، نمونهای از قدرت هوش مصنوعی در علوم زیستی است.
نکات تخصصی برای بهینهسازی عملکرد ورک استیشن AI
خرید ورک استیشن قدرتمند تنها قدم اول است. برای بهرهبرداری بهینه از این سرمایهگذاری، نیاز به دانش فنی و اعمال بهترین شیوهها دارید. در این بخش، نکات تخصصی که میتوانند عملکرد سیستم شما را تا حد قابل توجهی بهبود بخشند، بررسی میکنیم.
بهینهسازی محیط نرمافزاری
انتخاب سیستمعامل مناسب: اکثر پروژههای یادگیری ماشین روی لینوکس توسعه داده میشوند، زیرا بسیاری از ابزارها و کتابخانههای متنباز ابتدا برای لینوکس منتشر میشوند. توزیعهایی مانند Ubuntu 22.04 LTS، CentOS Stream یا Red Hat Enterprise Linux گزینههای محبوب هستند. با این حال، برای کاربرانی که به نرمافزارهای تجاری Windows نیاز دارند، Windows 11 Pro نیز قابل استفاده است. برخی کاربران ترجیح میدهند dual-boot داشته باشند تا از مزایای هر دو سیستمعامل بهرهمند شوند.
نصب صحیح درایورها: درایورهای GPU مهمترین جزء نرمافزاری هستند. همیشه آخرین نسخه درایور NVIDIA را از وبسایت رسمی دانلود و نصب کنید. همچنین، CUDA Toolkit و cuDNN را متناسب با فریمورک یادگیری عمیق خود نصب نمایید. نسخههای ناسازگار میتوانند منجر به خطاهای عجیب و عملکرد ضعیف شوند.
استفاده از محیطهای مجازی: برای هر پروژه، یک محیط مجازی جداگانه ایجاد کنید. ابزارهایی مانند Conda، virtualenv یا Docker میتوانند این کار را ساده کنند. این رویکرد از تداخل بین نسخههای مختلف کتابخانهها جلوگیری میکند و مدیریت وابستگیها را آسانتر مینماید.
بهینهسازی کتابخانههای یادگیری عمیق: TensorFlow و PyTorch تنظیمات پیشفرض محافظهکارانهای دارند که همیشه بهینه نیستند. برای مثال، فعال کردن mixed precision training میتواند سرعت آموزش را تا ۵۰ درصد افزایش دهد بدون کاهش دقت مدل. همچنین، استفاده از کتابخانههای بهینهشده مانند cuBLAS، cuDNN و TensorRT میتواند تفاوت قابل توجهی ایجاد کند.
مدیریت حافظه GPU
حافظه GPU معمولاً تنگناتی گلوگاه در آموزش مدلهای بزرگ است. استراتژیهای زیر میتوانند به شما کمک کنند از حافظه موجود بهینه استفاده کنید:
Gradient Accumulation: اگر batch size بزرگی نمیتواند در حافظه GPU جا شود، میتوانید چندین mini-batch کوچک را پردازش کنید و gradientها را جمع کنید قبل از اینکه وزنها را بهروزرسانی کنید. این تکنیک به شما امکان میدهد از effective batch size بزرگتر استفاده کنید.
Mixed Precision Training: استفاده از دقت ۱۶ بیتی (FP16) به جای ۳۲ بیتی (FP32) میتواند مصرف حافظه را تا ۵۰ درصد کاهش دهد و سرعت را افزایش دهد. کتابخانههایی مانند NVIDIA Apex و PyTorch AMP این قابلیت را به راحتی فراهم میکنند.
Gradient Checkpointing: این تکنیک بخشی از محاسبات forward pass را ذخیره نمیکند و در backward pass دوباره محاسبه میکند. این باعث کاهش مصرف حافظه میشود اما سرعت را کمی کاهش میدهد. برای مدلهای بسیار بزرگ که در حافظه جا نمیشوند، این یک راهحل عملی است.
Model Parallelism: اگر مدل شما آنقدر بزرگ است که در یک GPU جا نمیشود، میتوانید لایههای مختلف را روی GPUهای مختلف قرار دهید. کتابخانههایی مانند DeepSpeed و Megatron-LM این کار را ساده میکنند.
بهینهسازی پردازش داده
بارگذاری و پیشپردازش دادهها میتواند یک تنگنا جدی باشد. GPUهای شما نباید منتظر داده بمانند:
استفاده از Data Loaders بهینه: TensorFlow و PyTorch دارای data loaderهای پیشرفتهای هستند که میتوانند دادهها را بهصورت موازی بارگذاری و پیشپردازش کنند. تنظیم پارامترهای مانند num_workers میتواند تفاوت بزرگی ایجاد کند.
Caching دادههای پیشپردازششده: اگر همان دادهها را چندین بار در epochهای مختلف استفاده میکنید، پیشپردازش یک بار و ذخیره نتایج در دیسک میتواند زمان را صرفهجویی کند.
استفاده از فرمتهای بهینه: فرمتهای فایل مانند TFRecord برای TensorFlow یا WebDataset برای PyTorch، بارگذاری سریعتری نسبت به فرمتهای تصویر معمولی دارند.
افزایش داده روی GPU: بسیاری از عملیات افزایش داده (augmentation) میتوانند روی GPU انجام شوند که بسیار سریعتر از CPU هستند. کتابخانههایی مانند NVIDIA DALI این قابلیت را فراهم میکنند.
پایش و بهینهسازی مداوم
استفاده از ابزارهای پروفایلینگ: ابزارهایی مانند NVIDIA Nsight Systems و PyTorch Profiler میتوانند به شما نشان دهند که زمان در کجا صرف میشود. شناسایی تنگناها اولین قدم برای بهینهسازی است.
پایش مصرف منابع: از nvidia-smi برای پایش استفاده از GPU، حافظه، دما و مصرف برق استفاده کنید. اگر GPU utilization شما کمتر از ۹۰٪ است، یعنی فضای بهینهسازی وجود دارد.
Benchmarking منظم: بهطور منظم عملکرد سیستم خود را با benchmarkهای استاندارد مقایسه کنید تا اطمینان حاصل کنید که همه چیز به درستی کار میکند. کاهش ناگهانی عملکرد میتواند نشانه مشکل باشد.
نگهداری سختافزار: بهطور منظم داخل کیس را تمیز کنید، فنها را از گرد و غبار پاک نمایید و خمیر حرارتی را (thermal paste) بررسی کنید. دمای بالا میتواند منجر به throttling و کاهش عملکرد شود.
سوالات متداول درباره ورک استیشنهای هوش مصنوعی
۱. تفاوت اصلی GPUهای Gaming با GPUهای حرفهای برای AI چیست؟
GPUهای Gaming مانند RTX 4090 برای رندرینگ گرافیک در بازیها بهینه شدهاند و معمولاً قیمت مناسبتری دارند. اما GPUهای حرفهای مانند H100 و H200 دارای مزایای کلیدی هستند: حافظه بسیار بیشتر (۸۰ تا ۱۴۱ گیگابایت در برابر ۲۴ گیگابایت)، پهنای باند حافظه بالاتر (تا ۴.۸ ترابایت/ثانیه)، پشتیبانی از حافظه ECC برای قابلیت اطمینان بالاتر، Transformer Engine اختصاصی برای مدلهای زبانی، و گارانتی سازمانی طولانیتر. برای پروژههای تحقیقاتی کوچک و یادگیری، GPUهای Gaming کافی هستند، اما برای کاربردهای سازمانی و مدلهای بزرگ، GPUهای حرفهای ضروریاند.
۲. آیا میتوانم با یک GPU شروع کنم و بعداً GPU دیگری اضافه کنم؟
بله، بسیاری از ورک استیشنها طراحی modular دارند و میتوانید با یک GPU شروع کنید و بعداً تا سقف حداکثر (معمولاً ۴ GPU) اضافه کنید. با این حال، نکات مهمی وجود دارد: مطمئن شوید مادربورد و منبع تغذیه ظرفیت کافی دارند، GPUهای جدید باید از همان مدل یا نسل مشابه باشند برای عملکرد بهینه، و اتصالات PCIe کافی وجود داشته باشد. هنگام خرید، حتماً از قابلیت ارتقا مطمئن شوید.
۳. چقدر برق مصرف میکند و هزینه آن چیست؟
یک ورک استیشن با یک GPU RTX 4090 حدود ۶۰۰ تا ۸۰۰ وات مصرف میکند (کل سیستم). با چهار GPU H100، مصرف میتواند به ۳۵۰۰ تا ۴۰۰۰ وات برسد. هزینه برق بستگی به تعرفه محلی شما دارد. در ایران، با فرض مصرف ۱۰۰۰ وات برای ۸ ساعت در روز، حدود ۲۴۰ کیلوواتساعت در ماه مصرف میشود که بسته به تعرفه، میتواند چند صد هزار تومان هزینه داشته باشد. برای سیستمهای پرقدرت، در نظر گرفتن هزینه برق در محاسبات TCO ضروری است.
۴. آیا نیاز به خنککاری اضافی یا تهویه ویژه دارم؟
برای ورک استیشنهای با یک یا دو GPU، خنککاری داخل کیس معمولاً کافی است، به شرطی که دمای محیط معقول باشد (زیر ۲۵ درجه). اما برای سیستمهای با سه یا چهار GPU پرقدرت، ممکن است نیاز به خنککاری اضافی داشته باشید: فنهای قدرتمندتر یا بیشتر در کیس، در نظر گرفتن خنککاری مایع برای CPU و GPU، نصب سیستم در اتاق با تهویه مناسب یا کولر، و پایش منظم دما با نرمافزارهایی مانند HWMonitor. دمای ایدهآل GPU در حین کار زیر ۸۵ درجه سانتیگراد است.
۵. چقدر طول میکشد تا یک ورک استیشن بازگشت سرمایه داشته باشد؟
این بستگی به کاربرد و مقایسه با جایگزینها دارد. اگر جایگزین شما استفاده از GPUهای ابری است، یک ورک استیشن میتواند در ۶ تا ۱۸ ماه بازگشت سرمایه داشته باشد. برای مثال، اجاره یک GPU H100 در سرویسهای ابری حدود ۲ تا ۳ دلار در ساعت هزینه دارد. اگر ۸ ساعت در روز استفاده کنید، این رقم به ۴۸۰ تا ۷۲۰ دلار در ماه میرسد. یک ورک استیشن با قیمت ۵۰ هزار دلار در حدود ۷ تا ۱۰ ماه استفاده مداوم بازگشت سرمایه دارد. برای استارتاپها و محققانی که استفاده زیادی دارند، خرید ورک استیشن مقرونبهصرفهتر است.
۶. آیا میتوانم از راه دور به ورک استیشن دسترسی داشته باشم؟
بله، کاملاً امکانپذیر است. میتوانید از پروتکلهایی مانند SSH برای دسترسی خط فرمان، VNC یا TeamViewer برای دسترسی گرافیکی، و Jupyter Notebook یا JupyterLab برای محیط توسعه تحت وب استفاده کنید. برای دسترسی امن از بیرون از شبکه محلی، استفاده از VPN توصیه میشود. برخی سازمانها ترجیح میدهند ورک استیشن را در دفتر نگه دارند و تیم از راه دور به آن دسترسی داشته باشند.
۷. ورک استیشنهای Soika در مقایسه با رقبا چه مزایایی دارند؟
ورک استیشنهای Soika با استفاده از جدیدترین GPUهای NVIDIA (H200, H100)، پردازندههای Intel Xeon سری w با تعداد هسته بالا، حافظههای ECC با کیفیت سازمانی، و ذخیرهسازی NVMe سریع، پیکربندی متوازن و بهینهای را ارائه میدهند. علاوه بر این، سوان تک با ارائه پشتیبانی ۲۴/۷، گارانتی معتبر، تحویل سریع، و خدمات پس از فروش حرفهای، اطمینان میدهد که سرمایهگذاری شما محافظت شده و در صورت بروز هر مشکلی، سریعاً حل میشود.
۸. آیا برای استفاده از این ورک استیشنها نیاز به دانش فنی پیشرفته دارم؟
سطح دانش مورد نیاز بستگی به کاربرد شما دارد. برای شروع کار با فریمورکهای محبوب مانند PyTorch و TensorFlow، دانش متوسط برنامهنویسی Python کافی است. بسیاری از آموزشهای آنلاین رایگان موجود است. با این حال، برای بهینهسازی عملکرد، مدیریت چند GPU، و حل مشکلات فنی، دانش عمیقتر مفید است. ورک استیشنهای Soika با پلتفرمهای Soika Stack و Mockingjay، بسیاری از پیچیدگیها را ساده میکنند و زمان یادگیری را کاهش میدهند. همچنین، پشتیبانی فنی سوان تک میتواند در مراحل اولیه به شما کمک کند.
جمعبندی و نتیجهگیری
در این راهنمای جامع، به بررسی کامل دنیای ورک استیشنهای هوش مصنوعی پرداختیم. از مبانی و تعاریف گرفته تا اجزای کلیدی سختافزاری، تفاوتهای بنیادین با سرورها، معرفی محصولات برتر Soika، راهنمای انتخاب و خرید، کاربردهای تخصصی در صنایع مختلف، و نکات بهینهسازی عملکرد.
نکات کلیدی که باید به خاطر بسپارید:
- ورک استیشنهای AI ابزاری استراتژیک هستند: انتخاب صحیح میتواند تفاوت بین موفقیت و شکست پروژههای شما باشد.
- GPU مهمترین جزء است: تخصیص بیشترین بخش بودجه به GPU منطقی است، زیرا تأثیر مستقیمی بر عملکرد دارد.
- ورک استیشن برای بسیاری منطقیتر از سرور است: بهویژه برای تیمهای کوچک، محیطهای تحقیقاتی و استارتاپها.
- Soika محصولاتی با کیفیت سازمانی ارائه میدهد: ورک استیشنهای Soika H200 و Soika 4×H100 با استفاده از جدیدترین فناوریها، پاسخی به نیازهای آینده هستند.
- سوان تک شریک قابل اعتماد شماست: با ارائه پشتیبانی ۲۴/۷، گارانتی معتبر و تحویل سریع، میتوانید با اطمینان سرمایهگذاری کنید.
گام بعدی شما چیست؟
اگر به دنبال تأمین زیرساخت هوش مصنوعی قدرتمند، قابل اعتماد و با پشتیبانی حرفهای هستید، سوان تک آماده همراهی با شما است. تیم متخصص ما میتواند نیازهای شما را ارزیابی کرده، بهترین پیکربندی را پیشنهاد دهد، و تضمین کند که سرمایهگذاری شما بازده مطلوب را داشته باشد.
برای مشاوره رایگان و دریافت قیمت، با تیم سوان تک تماس بگیرید. آینده هوش مصنوعی متعلق به کسانی است که امروز اقدام میکنند.