
مقالات و اخبار تکنولوژی
راهنمای جامع Storage برای AI و HPC: انتخاب، طراحی و پیادهسازی


تاریخ بروزرسانی: دیماه 1404
نویسنده: تیم تخصصی سوان تک (SevanTech)
اعتبارنامهها:
مشاور و پیادهکننده بیش از 50 پروژه Storage سازمانی در ایران
- تامینکننده سرورهای GPU و زیرساختهای AI
- ارائهدهنده خدمات مشاوره تخصصی در حوزه Storage و Data Center
پاسخ سریع: برای پروژههای هوش مصنوعی و محاسبات پرسرعت چه نوع Storage نیاز است؟
انتخاب Storage مناسب برای AI/HPC به سه عامل کلیدی بستگی دارد: مقیاس محاسبات، نوع workload و بودجه. برای پروژههای کوچک (تا 8 GPU)، سرورهای مجهز به NVMe SSD محلی کافی است. پروژههای متوسط (8-64 GPU) نیاز به Parallel File System مانند DDN EXAScaler دارند که IOPS بالا و latency پایین فراهم میکند. پروژههای بزرگ سازمانی (64+ GPU) به معماری چندلایه با ترکیب All-Flash Array مانند Huawei OceanStor Dorado برای hot data، Parallel Filesystem برای warm data و Object Storage برای cold data نیاز دارند. نکته کلیدی این است که بدون زیرساخت ذخیرهسازی صحیح، سرمایهگذاری میلیون دلاری روی GPUها به هدر میرود، چرا که GPUها بیش از 70% وقت خود را منتظر داده میمانند.
فهرست مطالب: Storage برای AI و HPC
- چرا Storage برای AI/HPC اهمیت حیاتی دارد؟
- انواع معماریهای Storage برای محاسبات پرسرعت
- Parallel File Systems: قلب تپنده HPC
- All-Flash و NVMe: سرعت بینظیر
- معماری چندلایه (Tiered Storage)
- محاسبه IOPS و Bandwidth مورد نیاز
- Storage برای Deep Learning و Training
- Storage برای محاسبات علمی و شبیهسازی
- انتخاب راهکار Storage بر اساس مقیاس
- بهینهسازی و عیبیابی
1. چرا Storage برای AI/HPC اهمیت حیاتی دارد؟
وقتی سازمانها میلیونها دلار برای خرید سرورهای محاسباتی قدرتمند، GPUهای پیشرفته و زیرساختهای شبکه سرمایهگذاری میکنند، اغلب یک نکته حیاتی را نادیده میگیرند: بدون سیستم ذخیرهسازی مناسب، تمام این توان محاسباتی به هدر میرود. Storage نه یک جزء جانبی، بلکه ستون فقرات هر زیرساخت محاسباتی پرسرعت است.

چرخه معیوب: وقتی CPU/GPU منتظر داده میماند
در یک سیستم HPC یا AI Training معمولی، پردازندهها (چه CPU و چه GPU) باید در هر چرخه محاسباتی مراحل زیر را طی کنند:
- خواندن داده ورودی از Storage
- بارگذاری به حافظه (RAM یا GPU Memory)
- اجرای محاسبات روی داده
- نوشتن نتایج به Storage
اگر مرحله 1 یا 4 کند باشد، پردازندههای میلیون دلاری شما خاموش مینشینند و فقط منتظر میمانند. این را I/O Bottleneck مینامند و بزرگترین دشمن کارایی در محاسبات مدرن است.
هزینه واقعی Storage ضعیف
بیایید با اعداد واقعی صحبت کنیم. فرض کنید یک سرور HGX H200 8-GPU با ارزش تقریبی 240,000 دلار دارید:
| سناریو | GPU Utilization | زمان واقعی کار | هزینه هدر رفته |
|---|---|---|---|
| Storage بهینه | 85-95% | 10 روز | – |
| Storage معمولی | 50-60% | 18 روز | 80 روز × $2,000/روز = $160,000 |
| Storage ضعیف | 30-40% | 28 روز | 180 روز × $2,000/روز = $360,000 |
این اعداد فرضی نیستند. طبق گزارش Alluxio در 2023، تنگنای I/O میتواند بیش از 70% زمان آموزش مدلهای یادگیری عمیق را هدر دهد.
شکاف سرعت: هزاران برابر اختلاف
جدول زیر شکاف عظیم سرعت بین پردازندهها و سیستمهای ذخیرهسازی را نشان میدهد:
| سطح حافظه | پهنای باند | Latency | نسبت به GPU HBM |
|---|---|---|---|
| GPU HBM3 (H100) | 3.35 TB/s | 10-20 ns | 1x (مرجع) |
| DDR5 RAM | 400 GB/s | 80-100 ns | 8x کندتر |
| NVMe Gen5 Local | 14 GB/s | 10-50 µs | 240x کندتر |
| All-Flash Array (FC) | 50 GB/s | 100-300 µs | 350x کندتر |
| Parallel Filesystem | 100-500 GB/s | 50-200 µs | متغیر |
| Network NAS (10GbE) | 1.25 GB/s | 500 µs – 2 ms | 2,680x کندتر |
| HDD Array | 200 MB/s | 5-15 ms | 16,750x کندتر |
همانطور که میبینید، یک GPU H100 میتواند در یک ثانیه 3,350 گیگابایت داده پردازش کند، در حالی که یک NAS معمولی فقط 1.25 گیگابایت در ثانیه میتواند تحویل دهد. این یعنی GPU شما 2,680 برابر سریعتر از Storage شماست!
workloadهای مختلف، نیازهای متفاوت
هر نوع workload نیازهای منحصر به فرد خود را دارد:
Deep Learning Training:
- نیاز به خواندن سریال و متوالی دیتاستهای بزرگ
- Checkpoint Writing با حجم بالا (صدها گیگابایت هر چند ساعت)
- پهنای باند بالا مهمتر از Latency پایین است
- IOPS زیاد برای دیتاستهای تصویری (میلیونها فایل کوچک)
HPC Simulation (CFD، Molecular Dynamics):
- Random I/O با patternهای پیچیده
- Latency پایین بسیار حیاتی
- همزمانی بالا (هزاران نود که همزمان میخوانند/مینویسند)
- Metadata operations فراوان
Inference:
- مدلهای بزرگ باید در حافظه بمانند
- Latency بسیار حیاتی (<10ms)
- پهنای باند متوسط کافی است
- نیاز به Caching پیشرفته
2. انواع معماریهای Storage برای محاسبات پرسرعت
انتخاب معماری Storage درست اولین و مهمترین تصمیم در طراحی یک سیستم AI/HPC است. بیایید معماریهای اصلی را با جزئیات بررسی کنیم.
Direct Attached Storage (DAS)
چیست؟ DAS سادهترین شکل Storage است: درایوهایی که مستقیماً داخل سرور یا به آن متصل هستند.
مزایا:
- سادهترین و ارزانترین راهحل
- کمترین Latency ممکن (بدون شبکه)
- پهنای باند بالا (PCIe مستقیم)
- مناسب برای Caching و Scratch Space
محدودیتها:
- ظرفیت محدود (معمولاً تا 100TB)
- غیرقابل اشتراکگذاری بین سرورها
- مدیریت دشوار در مقیاس بزرگ
- Single Point of Failure
کاربرد:
- پروژههای کوچک تا 8 GPU
- Scratch space برای محاسبات موقت
- Cache tier در معماری چندلایه
مثال واقعی: یک سرور GPU Server استاندارد با 8 عدد NVMe U.2 7.68TB میتواند 61TB ظرفیت local با سرعت خواندن 56 GB/s فراهم کند – کاملاً کافی برای یک تیم تحقیقاتی 5-10 نفره.
Network Attached Storage (NAS)
چیست؟ یک سرور اختصاصی Storage که از طریق شبکه Ethernet به سرورهای محاسباتی متصل میشود.
پروتکلهای رایج:
- NFS (Network File System): استاندارد Linux/Unix
- SMB/CIFS: استاندارد Windows
- pNFS (Parallel NFS): نسخه موازی NFS
مزایا:
- ساده در راهاندازی و مدیریت
- قابل اشتراک بین چندین سرور
- پشتیبانی از Snapshot و Backup آسان
- هزینه اولیه پایین
محدودیتهای جدی برای HPC:
- پهنای باند محدود (معمولاً 1-10 GB/s)
- Latency بالا (100-500 µs)
- Metadata operations بسیار کند
- Scale نمیکند برای کلاسترهای بزرگ
توصیه: از NAS فقط برای پروژههای خیلی کوچک (1-2 GPU) یا فضای Backup استفاده کنید. برای workloadهای واقعی HPC/AI مناسب نیست.
Storage Area Network (SAN) و All-Flash Arrays
چیست؟ شبکه اختصاصی Storage که از پروتکلهای بلاک (Fibre Channel یا iSCSI) استفاده میکند. All-Flash Array نسخه مدرن SAN با SSDهای enterprise است.
ویژگیهای کلیدی:
- Block-level access (مانند Local Disk)
- Latency بسیار پایین (0.1-1 ms)
- IOPS بسیار بالا (میلیونها عملیات در ثانیه)
- قابلیت اطمینان Enterprise-grade
معماری:
Compute Servers
    ↓ (FC 32Gb/s یا 100GbE)
Storage Controllers (Active-Active)
    ↓
SSD/NVMe Drive Shelves
مثال محصول: Huawei OceanStor Dorado 6000 یک All-Flash Array پیشرفته با معماری End-to-End NVMe است که میتواند:
- Latency: 0.05 میلیثانیه
- IOPS: تا 20 میلیون عملیات در ثانیه
- Availability: 99.9999% (کمتر از 32 ثانیه downtime در سال)
- Data Reduction: 3:1 (Deduplication + Compression)
کاربرد در HPC:
- Tier 0/1 برای Hot Data و Metadata
- Database و Structured Data
- فضای Checkpoint برای مدلهای بزرگ
- Storage برای Virtual Machine Infrastructure
Parallel File Systems
چیست؟ فایل سیستمهای توزیع شدهای که طراحی شدهاند تا همزمان از صدها یا هزاران سرور خوانده/نوشته شوند.
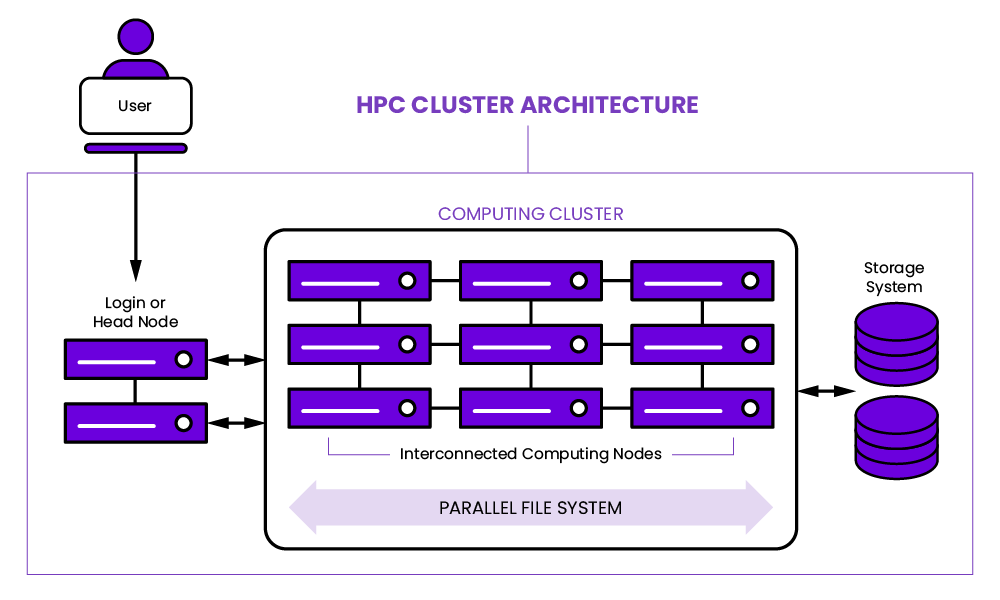
معماری کلی:
Metadata Servers (MDS): مدیریت namespace و permissions
↑ ↓
Object Storage Servers (OSS): ذخیره داده واقعی
↑ ↓
Compute Nodes: کلاینتهای موازی
ویژگیهای کلیدی:
- Data Striping: فایلها بین چندین سرور تقسیم میشوند
- Parallel I/O: همه سرورها همزمان خدمت میدهند
- Scale-out: با افزودن سرور، performance افزایش مییابد
- High Concurrency: هزاران client همزمان
محصولات اصلی:
- DDN EXAScaler (مبتنی بر Lustre):
- استاندارد طلایی HPC
- بیشترین رکوردهای Performance در IO500
- پشتیبانی از GPUDirect Storage
- بیشتر بخوانید: DDN EXAScaler Parallel File System
- BeeGFS:
- open-source اما Production-ready
- نصب و مدیریت سادهتر از Lustre
- Metadata performance عالی
- مناسب برای پروژههای متوسط
- IBM Spectrum Scale (GPFS):
- ریشه در Supercomputer
- قابلیتهای Enterprise پیشرفته
- Multi-protocol (POSIX + Object + HDFS)
- هزینه بالا
- WekaFS:
- Cloud-native architecture
- Performance بسیار بالا
- ادعای Scalability نامحدود
- نسبتاً جدید در بازار HPC
Object Storage
چیست؟ Storage که داده را به صورت Objects (شبیه فایل اما با metadata غنی) ذخیره میکند، نه block یا file hierarchy.
پروتکل:
- S3 (AWS S3 API): استاندارد صنعت
- Swift (OpenStack): برای Cloud
- REST APIs: دسترسی HTTP
مزایا:
- Scalability نامحدود (petabyte تا exabyte)
- هزینه پایین برای ذخیرهسازی طولانیمدت
- Durability بسیار بالا (11 نه در AWS)
- Metadata قدرتمند برای جستجو
محدودیت برای HPC:
- Latency بالا (50-200 ms)
- فقط برای Read/Write کل فایل (نه Random Access)
- نامناسب برای workloadهای Latency-sensitive
کاربرد:
- آرشیو دیتاستهای خام
- Backup و Disaster Recovery
- Cold Data (دادههایی که کمتر access میشوند)
- توزیع دیتاست بین سایتهای مختلف
محصولات:
- MinIO: open-source، S3-compatible
- VAST Data: Performance بالا برای AI
- Dell ECS: Enterprise object storage
3. Parallel File Systems: قلب تپنده HPC
Parallel File System قلب هر زیرساخت HPC و AI Training در مقیاس متوسط تا بزرگ است. بیایید عمیقتر در این فناوری فرو رویم.
چرا Parallel File System؟
تصور کنید 64 سرور GPU دارید که همزمان میخواهند یک دیتاست 10 ترابایتی را بخوانند. با NAS معمولی:
- سرور NAS فقط یک connection point دارد
- پهنای باند: حداکثر 10 GB/s
- هر سرور: فقط 156 MB/s میگیرد
- GPU utilization: زیر 20%
- زمان بارگذاری کل دیتاست: 17 ساعت!
با Parallel File System مثل DDN EXAScaler:
- 20 سرور Storage که همزمان سرویس میدهند
- پهنای باند کل: 200 GB/s
- هر سرور GPU: 3.125 GB/s
- GPU utilization: بالای 85%
- زمان بارگذاری: 51 دقیقه
معماری Lustre (DDN EXAScaler)
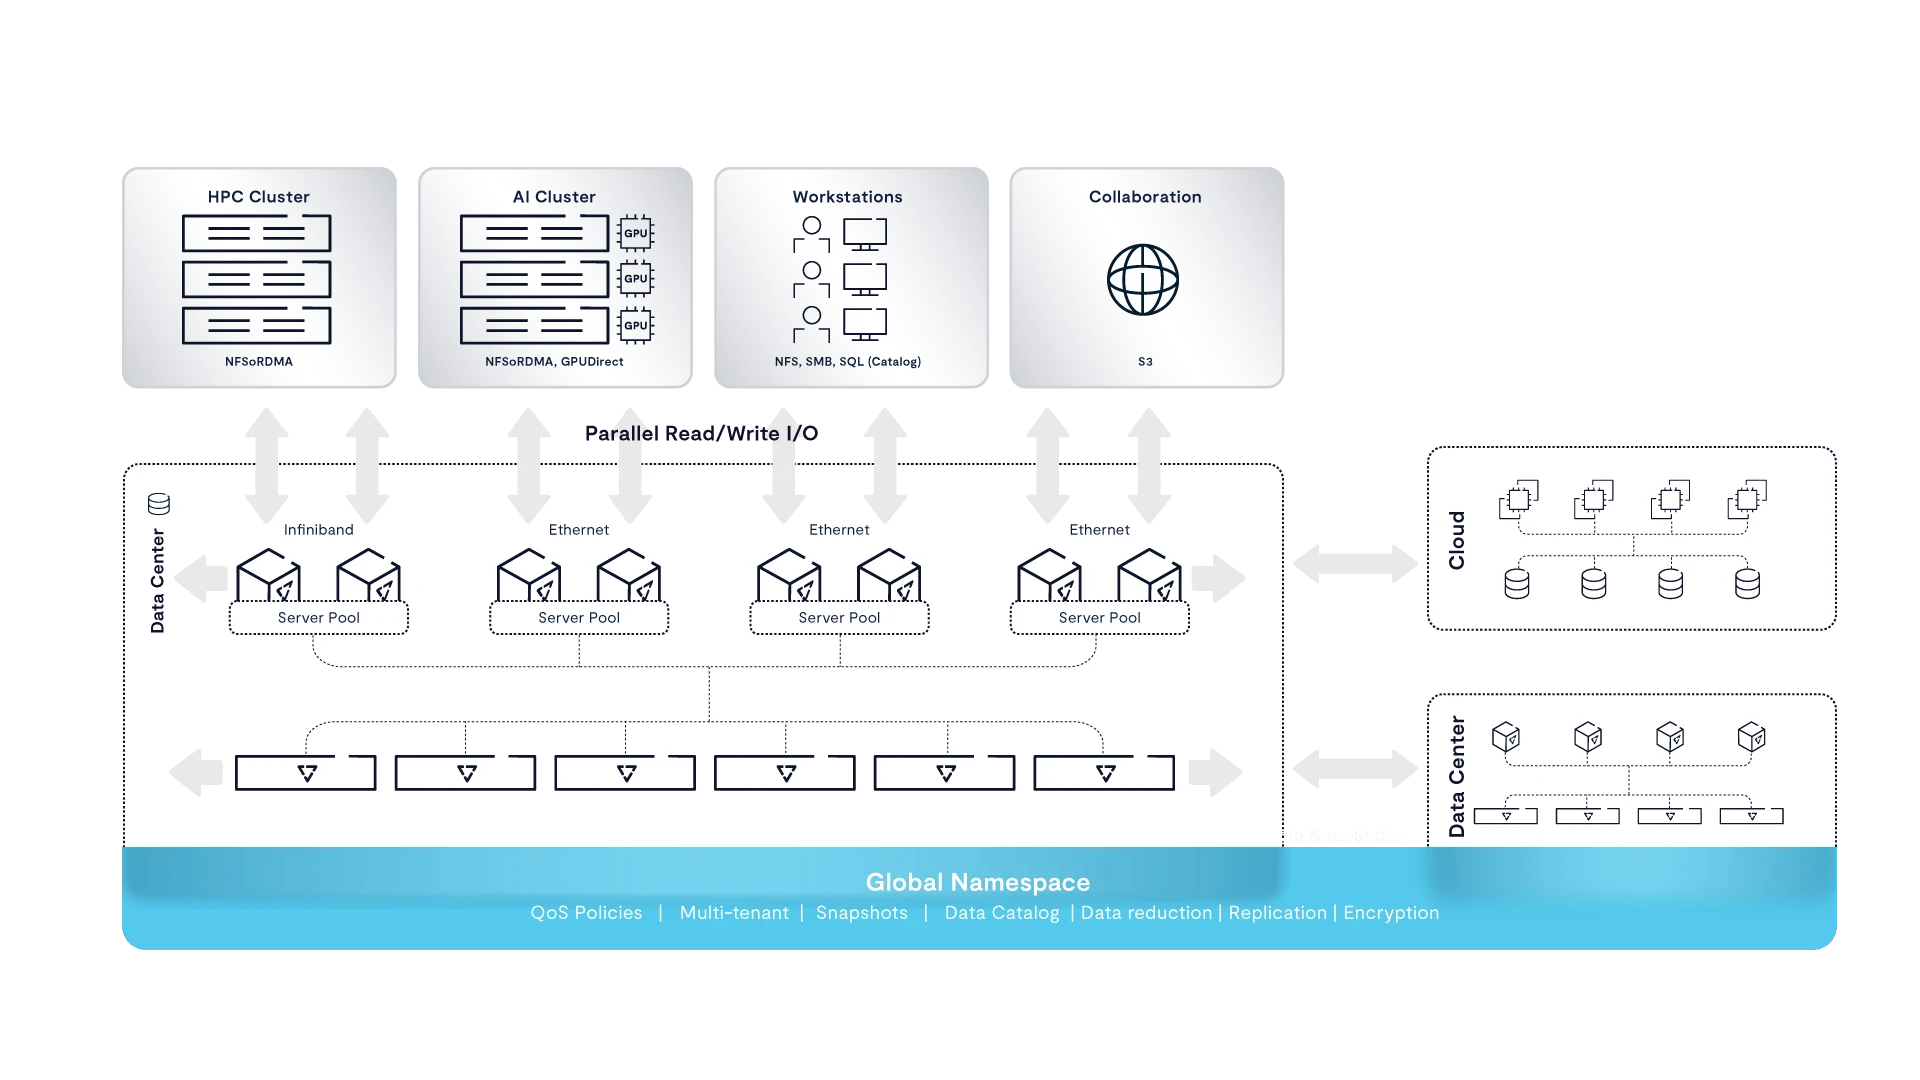
Lustre پیچیدهترین اما قدرتمندترین Parallel File System است:
اجزای معماری:
- MGS (Management Server):
- تنها یک سرور
- نگهداری configuration کل filesystem
- نقش کوچک اما حیاتی
- MDS (Metadata Server):
- معمولاً 2-4 سرور (HA)
- مدیریت namespace: directories، filenames، permissions
- ذخیره MDT (Metadata Target)
- Bottleneck اصلی برای workloadهای با Metadata زیاد
- OSS (Object Storage Server):
- معمولاً 10-100 سرور
- ذخیره داده واقعی
- هر OSS میتواند چندین OST (Object Storage Target) داشته باشد
- مهمترین عامل Performance
- Lustre Clients:
- نودهای Compute
- Mount میکنند Lustre مثل یک filesystem معمولی
- POSIX-compliant: برنامههای موجود بدون تغییر کار میکنند
Data Striping: کلید performance در Lustre، Striping است:
فایل 1GB با Stripe Count=4، Stripe Size=1MB:
Chunk 0 (1MB) → OST 0
Chunk 1 (1MB) → OST 1
Chunk 2 (1MB) → OST 2
Chunk 3 (1MB) → OST 3
Chunk 4 (1MB) → OST 0  (دوباره از اول)
...
فواید:
- 4 OSS همزمان سرویس میدهند = 4x سرعت
- اگر یک OSS خراب شود، داده از دست نمیرود (فقط کندتر میشود)
- Tunable: stripe count و size قابل تنظیم
تنظیمات بهینه برای AI Training:
Copy# فایلهای بزرگ (>1GB) - مثل checkpoint
lfs setstripe -c -1 -S 4M /mnt/lustre/checkpoints
# فایلهای کوچک (<10MB) - مثل تصاویر
lfs setstripe -c 1 -S 1M /mnt/lustre/images
# دیتاست بزرگ ولی تعداد فایل کم
lfs setstripe -c 8 -S 16M /mnt/lustre/videos
DDN EXAScaler: Lustre سازمانی
DDN فراتر از Lustre open-source رفته و ویژگیهای Enterprise اضافه کرده:
- Client-Side Compression:
- فشردهسازی شفاف (transparent)
- 2-3x کاهش network traffic
- GPU/CPU offload برای decompression
- Multi-tenancy:
- Quota management per project/user
- QoS (Quality of Service)
- Isolation بین پروژهها
- Rolling Upgrades:
- Upgrade بدون Downtime
- OSS به OSS
- Critical برای Production 24/7
- Advanced Monitoring:
- Real-time performance metrics
- Predictive failure detection
- Integration با NVIDIA Base Command
- GPUDirect Storage:
- Direct path از Storage به GPU Memory
- بدون Copy به CPU RAM
- 40% افزایش throughput برای GPU workloads
Performance Benchmarks
طبق رتبهبندی IO500 (استاندارد بنچمارک HPC)، DDN همواره در Top 10 حضور دارد:
| متریک | DDN EXAScaler | BeeGFS | WekaFS |
|---|---|---|---|
| Throughput (IOR) | 1000 GB/s (baseline) | ~330 GB/s | ~100 GB/s |
| Metadata (MDTest) | 5M ops/sec | 3M ops/sec | 2M ops/sec |
| Scaling Efficiency | 95% تا 1000 nodes | 85% | 90% |
| GPU Training | بهینه | خوب | خوب |
| Maturity | 20+ سال | 10+ سال | 5 سال |
4. All-Flash و NVMe: سرعت بینظیر
وقتی صحبت از Performance میشود، هیچ چیز سریعتر از All-Flash Storage نیست. بیایید ببینیم چرا.
تکامل فناوری Flash
نسل اول: SATA SSD
- Interface: SATA III
- سرعت: حداکثر 550 MB/s
- Latency: 50-100 µs
- کاربرد: Desktop، Laptop
نسل دوم: SAS SSD
- Interface: SAS 12Gb/s
- سرعت: 1,200 MB/s
- Latency: 30-80 µs
- کاربرد: Server entry-level
نسل سوم: NVMe over PCIe
- Interface: PCIe 3.0/4.0/5.0
- سرعت: 3,500-14,000 MB/s
- Latency: 10-50 µs
- IOPS: 1-2 میلیون
- کاربرد: High-performance servers
نسل چهارم: NVMe over Fabrics (NVMe-oF)
- Interface: RDMA Network (InfiniBand یا RoCE)
- سرعت: مشابه Local NVMe
- Latency: 50-200 µs
- مزیت: Shared storage با performance NVMe
Huawei OceanStor Dorado 6000: نمونه All-Flash پیشرفته
بیایید یک محصول واقعی را بررسی کنیم تا مفاهیم ملموستر شوند.
معماری:
Frontend Ports (FC 32Gb / 100GbE)
    ↓
Active-Active Controllers (128 cores, up to 16TB cache)
    ↓
SmartMatrix Backplane (Full-mesh interconnect)
    ↓
NVMe SSD Drives (up to 1,200 drives)
SmartMatrix چیست؟ بر خلاف SANهای معمولی که یک backplane passive دارند، Dorado 6000 از SmartMatrix استفاده میکند:
- Full-mesh: هر controller به هر drive مستقیماً متصل است
- No bottleneck: هیچ نقطه تنگنایی وجود ندارد
- Redundancy: اگر یک path خراب شود، pathهای دیگر کار میکنند
- Active-Active: همه controllerها همزمان فعال
FlashLink چیست؟ یک الگوریتم اختصاصی Huawei برای بهینهسازی NAND Flash:
- کاهش Write Amplification از 3x به 1.2x
- افزایش عمر SSD تا 5 برابر
- بهبود Sustained Performance
مشخصات Performance:
- Latency: 0.05 ms (50 میکروثانیه)
- IOPS: 20 میلیون 4K Random Read
- Throughput: 200 GB/s Sequential Read
- Availability: 99.9999% (31 ثانیه downtime در سال)
Data Services:
- Inline Deduplication & Compression: 3:1 data reduction
- Thin Provisioning: استفاده بهینه از ظرفیت
- Snapshots: بدون performance penalty
- Replication: همزمانسازی با سایت Remote
- RAID-TP: تحمل خرابی 3 drive همزمان
NVMe-oF: آینده Shared Storage
NVMe over Fabrics این امکان را میدهد که Performance NVMe را با مزیت Shared Storage ترکیب کنید:
Transport Protocols:
- RDMA over Converged Ethernet (RoCE):
- استفاده از Ethernet معمولی (با RDMA support)
- Latency: 50-100 µs
- هزینه پایینتر از InfiniBand
- InfiniBand:
- کمترین Latency: 20-50 µs
- بیشترین پهنای باند
- هزینه بالا
- Fibre Channel over NVMe (FC-NVMe):
- استفاده از زیرساخت FC موجود
- Latency: 100-200 µs
- مناسب برای Enterprise که FC دارند
معماری:
Compute Servers با NVMe-oF Host Adapter
    ↓ (100GbE RDMA یا 32Gb FC)
NVMe-oF Storage Array
    ↓
All-Flash NVMe Drives
مزایا:
- Performance نزدیک به Local NVMe
- Shared بین چندین سرور
- Centralized management
- Advanced data services
محدودیت:
- نیاز به Network Infrastructure مخصوص
- هزینه بالاتر از Local NVMe
- Complexity بیشتر
Use Cases برای All-Flash
1. Metadata Server برای Parallel Filesystem:
- Lustre MDS با Dorado 6000
- Millions of files: خیلی سریعتر از HDD
- Random IOPS بالا
2. Checkpoint Storage:
- نوشتن سریع (>10 GB/s)
- خواندن سریع برای Restart
- کاهش زمان Checkpoint از 10 دقیقه به 1 دقیقه
3. Database و Structured Data:
- Oracle، SQL Server، MongoDB
- Latency حیاتی برای Transaction
- IOPS بالا
4. Virtual Desktop Infrastructure (VDI):
- صدها VM همزمان boot میشوند (Boot Storm)
- نیاز به IOPS بسیار بالا
- Dorado 6000 میتواند 10,000 VM همزمان handle کند
5. Hot Tier در Tiered Storage:
- دادههای frequently accessed
- Caching برای Parallel Filesystem
- 20% داده، 80% access
5. معماری چندلایه (Tiered Storage)
یک راز بزرگ در HPC/AI: شما نیازی نیاز ندارید که همه دادهها روی سریعترین Storage باشند. در واقع، این کار فوقالعاده گران و غیرضروری است. معماری چندلایه (Tiered Storage) راهحل است.
اصل 80/20 در Access Pattern
مشاهدات واقعی نشان میدهد:
- 20% داده → 80% access (Hot Data)
- 30% داده → 15% access (Warm Data)
- 50% داده → 5% access (Cold Data)
این یعنی اگر فقط 20% داده را روی سریعترین Storage بگذارید، 80% نیاز performance شما برطرف میشود!
معماری سه لایه استاندارد
┌──────────────────────────────────────┐
│   Tier 0: NVMe Local (Hot Cache)     │
│   - ظرفیت: 10-100 TB per node        │
│   - سرعت: 50+ GB/s                   │
│   - Latency: 10-50 µs                │
│   - هزینه: بالا                      │
│   - کاربرد: Active dataset، Scratch  │
└──────────────────────────────────────┘
            ↕ (Cache miss/fill)
┌──────────────────────────────────────┐
│ Tier 1: All-Flash / Parallel FS      │
│ (Warm Storage)                        │
│   - ظرفیت: 500TB - 10PB              │
│   - سرعت: 100-500 GB/s               │
│   - Latency: 100-500 µs              │
│   - هزینه: متوسط                     │
│   - کاربرد: Training data، Results   │
└──────────────────────────────────────┘
            ↕ (Tiering policy)
┌──────────────────────────────────────┐
│    Tier 2: Object Storage (Cold)     │
│   - ظرفیت: 10-100 PB+                │
│   - سرعت: 10-50 GB/s                 │
│   - Latency: 5-50 ms                 │
│   - هزینه: پایین                     │
│   - کاربرد: Archive، Backup          │
└──────────────────────────────────────┘
Tier 0: Flash Cache / NVMe Local
چیست؟ NVMe SSDs داخل هر سرور Compute که به عنوان Cache استفاده میشوند.
تنظیم معمول:
- 4-8 NVMe U.2 drives در هر سرور
- ظرفیت: 4-16 TB per drive
- کل: 16-128 TB per server
- RAID: معمولاً RAID-0 (سرعت) یا RAID-10 (تعادل)
Software:
- dm-cache / bcache (Linux): automatic caching
- Intel Cache Acceleration Software: Intel-specific
- Manual management: Application کنترل میکند
Use Cases:
- Staging area برای دیتاست فعلی
- Scratch space برای نتایج موقت
- Checkpoint storage موقت
- Cache برای frequently accessed files
مثال: یک تیم Deep Learning دارند روی ImageNet کار میکنند:
- کل دیتاست (150GB) کپی میشود به NVMe Local
- Training فقط از Local میخواند (سرعت بالا)
- Checkpoint هر 1000 iteration به Tier 1 نوشته میشود
- بعد از تمام Epoch، مدل نهایی به Tier 1 منتقل میشود
مزیت:
- Training speed: 5-10x بهتر از خواندن از Network
- کاهش Load روی Shared Storage
Tier 1: Performance Storage
گزینهها:
- All-Flash Array (مثل Huawei OceanStor Dorado)
- Parallel File System (مثل DDN EXAScaler)
- Hybrid: ترکیبی از Flash + HDD
چیزهایی که روی Tier 1 میروند:
- دیتاستهای فعال (آنهایی که الان Training میشوند)
- Checkpoints مهم (آخرین 10 checkpoint)
- نتایج Experiment
- کدها و Environment
- Pre-processed data
سیاست Retention:
- دادهای که بیش از 30 روز access نشده → به Tier 2
- Checkpointهای قدیمی (بیش از 10 تا) → به Tier 2
- Training تمام شده → نتیجه نهایی روی Tier 1، بقیه به Tier 2
مثال Setup:
- ظرفیت کل: 2 PB
- Performance: 200 GB/s aggregate read
- Clients: 64 سرور GPU
- Per-client: 3.1 GB/s (بیش از کافی برای 8 GPU)
Tier 2: Capacity Storage
فناوری:
- Object Storage (S3-compatible)
- HDD-based NAS
- Tape Library (برای Archive خیلی طولانیمدت)
چیزهایی که روی Tier 2 میروند:
- Raw datasets (قبل از Preprocessing)
- Training Runs قدیمی (بیش از 6 ماه)
- Checkpoint Archive
- Backup
- دادههای Compliance/Regulatory
مزیت اصلی:
- هزینه: 1/10 قیمت All-Flash
- Scalability: تا exabyte
- Durability: 11 نه (99.999999999%)
محدودیت:
- Latency بالا: نامناسب برای Direct Training
- باید Restore شود به Tier 1 قبل از استفاده
Automated Tiering: HSM
HSM (Hierarchical Storage Management) به صورت خودکار داده را بین Tierها جابجا میکند.
Policy Engine:
Copyrules:
  - name: "Archive old checkpoints"
    condition:
      - file_pattern: "*.ckpt"
      - last_access: >60 days
      - location: /mnt/lustre/checkpoints
    action:
      - move_to: /mnt/object/archive/
      - keep_stub: true  # فایل خالی به جای اصلی

  - name: "Promote hot data"
    condition:
      - access_count: >10 in 7 days
      - location: /mnt/object/*
    action:
      - copy_to: /mnt/lustre/hot/
      - update_metadata: true
Products:
- IBM Spectrum Archive
- Starfish Storage
- DDN IME (Infinite Memory Engine)
مثال واقعی: چیدمان یک مرکز HPC دانشگاهی
مقیاس:
- 200 محقق
- 128 GPU Node (1,024 GPUs)
- 50+ پروژه همزمان
معماری:
Tier 0: NVMe Local
├─ 128 Nodes × 32TB = 4 PB total
└─ Managed توسط هر User (manual copy)

Tier 1: DDN EXAScaler
├─ 20 OSS × 100TB = 2 PB usable
├─ All-Flash: 50% / HDD: 50%
├─ Performance: 300 GB/s read
└─ Auto-tiering به Tier 2 بعد از 60 روز

Tier 2: MinIO Object Storage
├─ 100 PB capacity
├─ Performance: 20 GB/s
├─ Replicated across 3 datacenters
└─ Lifecycle policy: به Glacier بعد از 2 سال
جریان داده:
- محقق Dataset خام را Upload میکند به Tier 2 (S3)
- Preprocessing Job از Tier 2 میخواند، به Tier 1 مینویسد
- Training Job از Tier 1 میخواند، Cache در Tier 0
- Checkpoint هر 1000 iteration به Tier 1
- مدل نهایی روی Tier 1 + Backup روی Tier 2
- بعد از 60 روز بیاستفاده، خودکار به Tier 2
نتایج:
- 80% داده روی Tier 2 (ارزان)
- 15% روی Tier 1 (Performance)
- 5% Cache در Tier 0 (Maximum Speed)
- TCO: 60% کمتر از All-Flash
- Performance: تقریباً مشابه All-Flash برای workloads واقعی
6. محاسبه IOPS و Bandwidth مورد نیاز
یکی از سؤالات رایج: چقدر IOPS و Bandwidth برای پروژه من لازم است؟ بیایید روش محاسبه را یاد بگیریم.
فرمولهای پایه
1. Bandwidth (پهنای باند):
Bandwidth مورد نیاز (GB/s) =
(حجم داده خواندهشده در هر Iteration × تعداد Iterations در ثانیه × تعداد GPUs)
÷ (Cache Hit Rate × Compression Ratio)
2. IOPS (Input/Output Operations Per Second):
IOPS مورد نیاز =
(تعداد فایلها در هر Batch × Batches در ثانیه × تعداد Workers)
÷ Cache Hit Rate
مثال 1: Training ResNet-50 روی ImageNet
مشخصات:
- Dataset: ImageNet (1.28M images، 150GB)
- Model: ResNet-50
- Batch Size: 256 (32 per GPU)
- Number of GPUs: 8
- Images per second: 2,000 (250 per GPU)
- Image size: ~150 KB average
محاسبه Bandwidth:
داده خام:
2,000 images/sec × 150 KB = 300 MB/s

اما با Augmentation و Decompression:
300 MB/s × 3 (overhead) = 900 MB/s

با Cache Hit Rate 50% (نصف از RAM):
900 MB/s ÷ 0.5 = 1.8 GB/s
محاسبه IOPS:
هر Batch: 256 files
Batches per second: 2,000 ÷ 256 = 7.8
IOPS: 256 × 7.8 = 2,000 IOPS

با 8 Data Loader Workers:
2,000 × 8 = 16,000 IOPS
توصیه Storage:
- Minimum Bandwidth: 2 GB/s sustained read
- Minimum IOPS: 20,000 (با headroom)
- راهحل: NVMe RAID یا Entry-level All-Flash
مثال 2: Training GPT-3 175B
مشخصات:
- Parameters: 175 Billion
- GPUs: 256 × A100 80GB
- Batch Size: 512
- Sequence Length: 2048
- Data Format: Pre-tokenized, compressed
Checkpoint Size:
Model Weights: 175B × 2 bytes (FP16) = 350 GB
Optimizer State: 175B × 8 bytes (Adam) = 1.4 TB
Total Checkpoint: ~1.75 TB
Checkpoint Bandwidth: فرض: Checkpoint هر 1000 iterations (حدود 2 ساعت)
برای Checkpoint در 5 دقیقه:
1.75 TB ÷ 300 sec = 5.8 GB/s write
برای 256 GPUs که موازی مینویسند:
5.8 GB/s × (256 ÷ 8 nodes) = 186 GB/s burst write
Training Data Bandwidth:
Tokens per iteration: 512 batch × 2048 seq = 1,048,576 tokens
با BPE encoding: 1M tokens ≈ 2 MB compressed
Iterations per second: ~0.5 (مدل بسیار بزرگ است)

Bandwidth: 2 MB × 0.5 = 1 MB/s per GPU
برای 256 GPUs: 256 MB/s

اما با Prefetching 10x:
256 MB/s × 10 = 2.5 GB/s sustained read
توصیه Storage:
- Parallel Filesystem: DDN EXAScaler
- OSS Count: حداقل 32 (برای 200+ GB/s)
- All-Flash برای Metadata Server
- Backup به Object Storage
مثال 3: Molecular Dynamics Simulation
مشخصات:
- Atoms: 10 Million
- Timesteps: 10 Million (10 nanoseconds)
- Checkpoint: هر 10,000 timesteps
- Output: Trajectory file
I/O Pattern:
Checkpoint Size:
10M atoms × 24 bytes (x,y,z,vx,vy,vz) = 240 MB

Checkpoint Frequency:
10M timesteps ÷ 10K = 1000 checkpoints
Rate: حدود هر 10 دقیقه

Bandwidth Needed:
240 MB ÷ 600 sec = 400 KB/s (خیلی کم!)

اما با 1000 Parallel Simulations:
400 KB/s × 1000 = 400 MB/s
نکته: برای HPC Simulation، IOPS metadata مهمتر از Bandwidth است!
- هر Checkpoint: 1 عملیات write
- 1000 Simulations × 1 write ÷ 600 sec = 1.67 IOPS (پایین!)
- اما هر Simulation باز میکند، مینویسد، close میکند → ~5 metadata ops
- 1000 × 5 ÷ 600 = 8.3 metadata ops/sec
با 10,000 Simulations همزمان:
- 83 metadata ops/sec
- این نیاز به Metadata Server سریع دارد (SSD-based MDS)
جدول مرجع سریع: نیاز Storage بر اساس Workload
| نوع Workload | Bandwidth | IOPS | Latency | Storage Type |
|---|---|---|---|---|
| Image Training (ImageNet) | 2-5 GB/s | 20K-100K | <10 ms | All-Flash یا Fast NAS |
| Video Training | 10-50 GB/s | 1K-10K | <20 ms | Parallel FS |
| LLM Training (>100B) | 50-200 GB/s | <10K | <50 ms | Parallel FS (All-Flash OSTs) |
| Inference | 1-10 GB/s | 10K-100K | <1 ms | All-Flash با Cache |
| Molecular Dynamics | 100 MB-1 GB/s | 100-1K | <5 ms | Parallel FS (HDD OK) |
| CFD/Simulation | 10-100 GB/s | 10K-100K | <10 ms | Parallel FS (Mixed) |
| Genomics | 5-50 GB/s | 50K-500K | <20 ms | Parallel FS با SSD Metadata |
نکات کلیدی در محاسبه
- همیشه Overhead را در نظر بگیرید:
- Decompression: 2-3x
- Augmentation: 1.5-2x
- Format Conversion: 1.5-2x
- Network: 1.2-1.5x
- Cache Hit Rate را دست کم نگیرید:
- Epoch اول: Cache Cold → 100% miss
- Epoch دوم: Cache Warm → 50-70% hit
- Epoch سوم+: Cache Hot → 80-90% hit
- Burst vs. Sustained:
- Checkpoint Writing: Burst (کوتاه مدت، پهنای باند بالا)
- Training Reading: Sustained (طولانی مدت، پهنای باند متوسط)
- Storage باید هر دو را Handle کند
- Metadata نه تنها Data:
- فایلهای کوچک: Metadata Overhead >50%
- برای ImageNet: 1.28M files = 1.28M metadata ops در Epoch اول
- نیاز به SSD-backed Metadata Server
7. Storage برای Deep Learning و Training
Deep Learning و به خصوص Training مدلهای بزرگ، خاصترین نیازهای Storage را دارند. بیایید عمیقتر شویم.
Data Pipeline در Training

یک Training Pipeline معمولی:
Storage (Raw Data)
    ↓ (Network / Local Disk)
RAM Buffer (Prefetch Queue)
    ↓ (Decompression / Augmentation)
GPU Memory (Batch)
    ↓ (Forward Pass)
GPU Compute (Backprop)
    ↓ (Gradient)
Storage (Checkpoint Write)
هر کدام از این مراحل میتواند Bottleneck باشد.
Bottleneck #1: Raw Data Loading
مشکل: GPU میتواند 1000 images/sec پردازش کند، اما Storage فقط 100 images/sec میتواند deliver کند.
راهحلها:
1. Data Format Optimization:
| Format | Read Speed | Use Case |
|---|---|---|
| Individual JPEG | 100 img/s | Development، Dataset کوچک |
| TFRecord (TensorFlow) | 800 img/s | Production TensorFlow |
| WebDataset (TAR-based) | 1200 img/s | PyTorch Large-scale |
| LMDB (Key-Value DB) | 1500 img/s | Random Access، Small files |
| HDF5 | 900 img/s | Scientific Data |
چرا TFRecord/WebDataset سریعتر است؟
- فایلهای کوچک → یک فایل بزرگ
- کاهش Metadata Operations (از 1M به 100)
- Sequential Read (بهینه برای HDD هم)
- Compression بهتر
2. Data Loader Tuning:
Copy# PyTorch Example
train_loader = DataLoader(
    dataset,
    batch_size=256,
    num_workers=8,        # تعداد Process موازی
    pin_memory=True,       # Zero-copy to GPU
    prefetch_factor=4,     # هر Worker 4 Batch جلوتر
    persistent_workers=True # پروسسها زنده بمانند
)
نکات مهم:
num_workers: بستگی به CPU cores دارد- CPU 16-core: 8-12 workers
- CPU 32-core: 16-24 workers
prefetch_factor: RAM مصرف میکند- 4-8 workers × 4 prefetch × 256 batch × 150KB = 2-4 GB RAM
pin_memory: سرعت بالا اما RAM بیشتر
3. Local Caching:
Copy# کپی کردن Dataset به NVMe Local
rsync -avz --progress /mnt/shared/imagenet/ /mnt/nvme/imagenet/

# Training از Local
python train.py --data-path /mnt/nvme/imagenet/
مزیت:
- 10x بهتر برای Random Access
- کاهش Load روی Shared Storage
- Latency پایین
معایب:
- فضای محدود (باید فیت شود)
- باید Manual Sync کرد
- اگر چند سرور، باید روی همه Copy کرد
Bottleneck #2: Checkpoint Writing
مشکل: Training یک مدل GPT-3 با 175B parameters. هر 1000 iteration باید Checkpoint بگیرید:
- Model: 350 GB
- Optimizer: 1.4 TB
- Total: 1.75 TB
اگر Checkpoint شدن 30 دقیقه طول بکشد، GPUs شما 30 دقیقه بیکارند!
راهحلها:
1. Asynchronous Checkpointing:
Copy# Naive (Blocking)
if step % 1000 == 0:
    torch.save(model.state_dict(), f'checkpoint_{step}.pt')  # GPU blocked!

# Better (Async)
if step % 1000 == 0:
    # Copy to CPU memory (fast)
    state_cpu = {k: v.cpu() for k, v in model.state_dict().items()}
    # Save in background thread
    threading.Thread(
        target=torch.save,
        args=(state_cpu, f'checkpoint_{step}.pt')
    ).start()
    # GPU continues training!
2. Incremental Checkpointing:
بجای ذخیره کل مدل، فقط تغییرات را ذخیره کنید:
- Checkpoint اول: Full (1.75 TB)
- Checkpoint بعدی: Delta (فقط آنچه تغییر کرده، ~50 GB)
Libraries: torch-checkpoint-utils, Custom implementation
3. Compression:
Copy# Checkpoint با Compression
torch.save(
    model.state_dict(),
    'checkpoint.pt',
    _use_new_zipfile_serialization=True  # ZIP compression
)
کاهش 30-50% حجم، اما CPU overhead
4. Distributed Checkpointing:
در Training توزیعشده، هر GPU بخشی از Checkpoint را مینویسد:
GPU 0 → /mnt/lustre/checkpoint/shard_0.pt
GPU 1 → /mnt/lustre/checkpoint/shard_1.pt
...
GPU 255 → /mnt/lustre/checkpoint/shard_255.pt
مزیت:
- 256x موازی → 256x سریعتر
- 1.75 TB ÷ 256 = 6.8 GB per GPU
- 6.8 GB با 5 GB/s → 1.4 ثانیه!
Bottleneck #3: Validation Data Loading
مشکل: بعد از هر Epoch، باید روی Validation Set ارزیابی کنید. اگر Validation Set بزرگ باشد (مثلاً 50GB)، این میتواند 10-20 دقیقه طول بکشد.
راهحل:
- Validation Set را در RAM نگه دارید (اگر جا میشود)
- از Subset کوچکتر استفاده کنید (5% بجای 100%)
- Validation را موازی با Training Epoch بعدی انجام دهید
Best Practices برای Storage در Deep Learning
1. دیتاست را Pre-process کنید:
Raw Images (JPEG، متن، ...)
    ↓ (یکبار، Offline)
Preprocessed (TFRecord، resized، normalized)
    ↓ (Training مکرر)
Fast Loading
2. از Distributed Data-Parallel آگاه باشید:
Copy# اشتباه: هر GPU کل دیتاست را میخواند
train_loader = DataLoader(dataset, batch_size=32)
# درست: هر GPU فقط بخش خودش را میخواند
sampler = DistributedSampler(dataset, num_replicas=8, rank=gpu_id)
train_loader = DataLoader(dataset, batch_size=32, sampler=sampler)
این Load روی Storage را 8x کاهش میدهد!
3. Monitoring:
Copyimport time

class TimedDataLoader:
    def __init__(self, dataloader):
        self.dataloader = dataloader

    def __iter__(self):
        for batch in self.dataloader:
            t0 = time.time()
            yield batch
            t1 = time.time()
            if t1 - t0 > 0.1:  # بیش از 100ms
                print(f"Slow batch loading: {t1-t0:.2f}s")
اگر پیام “Slow batch loading” زیاد ببینید، Storage شما Bottleneck است!
4. GPU Utilization Monitoring:
Copywatch -n 1 nvidia-smi
اگر GPU-Util کمتر از 80% است، احتمالاً Storage یا CPU Bottleneck دارید.
8. Storage برای محاسبات علمی و شبیهسازی
محاسبات علمی (مانند CFD، Molecular Dynamics، Climate Modeling) الگوهای I/O کاملاً متفاوتی نسبت به Deep Learning دارند.
تفاوتهای کلیدی
| جنبه | Deep Learning | Scientific Computing |
|---|---|---|
| I/O Pattern | Mostly Sequential Read | Random Read/Write |
| File Size | Many small (KB-MB) | Few large (GB-TB) |
| Checkpoint Freq | هر 1000 steps | هر 10-100 steps |
| Metadata Ops | خیلی زیاد | کم تا متوسط |
| Latency | متوسط (<10ms) | Critical (<1ms) |
| Concurrency | متوسط (8-64 nodes) | بسیار بالا (1000+ nodes) |
| MPI | کم (Data Parallel) | زیاد (Message Passing) |
Case Study 1: Computational Fluid Dynamics (CFD)
سناریو: شبیهسازی جریان هوا دور یک هواپیما با 500 میلیون سلول (cells).
I/O Pattern:
Initialization:
- خواندن Mesh (geometry): 50 GB
- خواندن Initial Conditions: 20 GB

Simulation Loop:
  For timestep 1 to 100,000:
    - Compute (GPU/CPU)
    - هر 100 timesteps:
        * Write Checkpoint (150 GB)
        * Write Visualization (50 GB)
    - هر 10 timesteps:
        * Write Log (1 MB)

Total I/O:
- Checkpoints: 1000 × 150 GB = 150 TB written
- Viz: 10,000 × 50 GB = 500 TB written
- Total: 650 TB!
Storage Requirements:
- Capacity: 200 TB (نگهداری 10 Checkpoint اخیر + Viz)
- Bandwidth:
- Write: 150 GB ÷ 60 sec = 2.5 GB/s per checkpoint
- Read: کم (فقط در Restart)
- Latency: مهم نیست (Async I/O)
- Durability: بسیار مهم (اگر از دست برود، باید دوباره Simulate کرد!)
Best Practice:
- Parallel I/O: استفاده از MPI-IO
CopyMPI_File_open(MPI_COMM_WORLD, "checkpoint.dat",
MPI_MODE_CREATE | MPI_MODE_WRONLY,
MPI_INFO_NULL, &fh);
// هر Process بخش خودش را مینویسد
MPI_File_write_at(fh, offset, local_data, count,
MPI_DOUBLE, &status);
MPI_File_close(&fh);
- Compression: استفاده از SZ، ZFP (lossy compression برای Viz)
- کاهش 10-20x حجم با Loss قابل قبول
- 500 TB → 25-50 TB
- In-Situ Visualization: بجای نوشتن تمام داده، فقط نتیجه Viz بنویسید
- VisIt، ParaView Catalyst
- کاهش 100x حجم داده
راهکار Storage:
- DDN EXAScaler با HDD-based OSTs
- فلش برای این Workload ضروری نیست (Sequential Write)
- 50 OSS × 200 TB = 10 PB capacity
- 50 × 2 GB/s = 100 GB/s sustained write
Case Study 2: Molecular Dynamics
سناریو: شبیهسازی 10 میلیون اتم پروتئین در آب برای 1 microsecond (1 میلیون timestep).
I/O Pattern:
Initialization:
- Topology file: 10 MB
- Coordinate file: 200 MB

Simulation:
  For timestep 1 to 1,000,000:
    - Compute forces (GPU)
    - Update positions
    - هر 10,000 timesteps:
        * Write Trajectory (240 MB)
        * Write Energy log (1 KB)

Total I/O:
- Trajectory: 100 × 240 MB = 24 GB
- Logs: 100 × 1 KB = 100 KB
نکات خاص:
- حجم کم اما IOPS زیاد:
- 100 File Writes
- اگر 1000 Simulations موازی: 100,000 File Writes
- نیاز به Metadata Server سریع
- Post-processing:
- بعد از Simulation، باید Trajectory را Analyze کرد
- خواندن 1000 × 24 GB = 24 TB
- Random Access به Frames خاص
- نیاز به Latency پایین
راهکار Storage:
- Lustre با SSD Metadata Target
- HDD OSTs کافی است (Sequential Write)
- راهنمای زیرساخت Storage برای جزئیات بیشتر
Case Study 3: Climate Modeling
سناریو: شبیهسازی آب و هوای زمین با resolution 10km برای 100 سال.
ویژگیهای خاص:
- حجم عظیم: Petabytes of output
- Coupled Models: Atmosphere + Ocean + Land + Ice
- Ensemble Runs: 50 شبیهسازی موازی با پارامترهای مختلف
- Long-term Archive: داده باید 50-100 سال نگهداری شود
I/O Challenges:
- Burst I/O:
- همه Model Components همزمان مینویسند
- پیک Load: 500 GB/s
- Average Load: 50 GB/s
- Hierarchical Data:
- Daily output: 1 TB/day
- Monthly averages: 10 GB/month
- Yearly summaries: 500 MB/year
- Metadata Intensive:
- میلیونها فایل NetCDF
- کوئری پیچیده بر اساس زمان، متغیر، منطقه
معماری Storage:
Tier 0: Burst Buffer (NVMe)
├─ 500 TB capacity
├─ Absorb burst writes
└─ Drain به Tier 1 در Background

Tier 1: Campaign Storage (Parallel FS)
├─ 10 PB capacity
├─ Active simulations (6 ماه)
└─ Fast access برای Analysis

Tier 2: Archival (Tape/Object)
├─ 100 PB capacity
├─ Simulations >6 months old
└─ Compliance: 50+ years
نرمافزار:
- Burst Buffer: DDN IME، Cray DataWarp
- Parallel FS: Lustre یا GPFS
- Archive: HPSS (High Performance Storage System) یا Object Storage
9. انتخاب راهکار Storage بر اساس مقیاس
حالا که مفاهیم را یاد گرفتیم، بیایید راهکارهای عملی برای مقیاسهای مختلف ارائه دهیم.
سناریو 1: تیم تحقیقاتی کوچک (1-8 GPU)
پروفایل:
- تیم: 3-5 محقق
- GPUs: 2-8 (مثلاً 2× NVIDIA H100)
- Workload: Computer Vision، NLP research
- دیتاست: 100GB – 1TB
- بودجه: محدود
راهکار Storage:
Option A: سرور با NVMe Local (ارزانترین)
سرور GPU:
├─ 2-8 GPU
├─ 4× NVMe U.2 7.68TB = 31TB
├─ RAID-0 برای Performance
└─ هزینه: +$8,000
مزیت:
- ساده، بدون نیاز به Network Storage
- سریع (50+ GB/s)
- کمهزینه
معایب:
- فضا محدود
- اشتراکگذاری دشوار
- اگر سرور خراب شود، داده در خطر است
توصیه:
- Backup منظم به External Storage (NAS، Cloud)
- Git/DVC برای Version Control
Option B: سرور + NAS کوچک
سرور GPU + QNAP/Synology NAS:
├─ سرور: 16TB NVMe (Scratch)
├─ NAS: 48TB (4× 12TB HDD)
├─ شبکه: 10GbE
└─ هزینه: +$12,000
مزیت:
- Shared بین چند Workstation
- Backup و Snapshot آسان
- Scale میکند تا 8-16 GPU
معایب:
- کندتر از NVMe Local (1 GB/s vs 50 GB/s)
- برای Training، باید داده را به Local کپی کرد
سناریو 2: لب AI متوسط (8-64 GPU)
پروفایل:
- تیم: 10-30 محقق
- GPUs: 8-64 (مثلاً 8× DGX A100)
- Workload: Training مدلهای متوسط (GPT-2، ResNet-152)
- دیتاست: 1-50 TB
- بودجه: متوسط ($200K-$500K برای Storage)
راهکار Storage:
معماری پیشنهادی:
Tier 0: NVMe Local در هر سرور
├─ 8 سرور × 32TB = 256TB cache
└─ بدون هزینه اضافی (included)

Tier 1: Parallel File System
├─ فناوری: BeeGFS یا [DDN EXAScaler Entry](https://sevantech.ir/ddn-exascaler-parallel-file-system/)
├─ ظرفیت: 200-500 TB
├─ Performance: 50-100 GB/s
├─ Hardware:
│   ├─ 2× Metadata Server (SSD)
│   ├─ 8-12× Storage Server (NVMe یا Mix)
│   └─ 2× Management/Monitor
└─ هزینه: $250K-$400K

Tier 2: Backup (اختیاری)
├─ NAS یا Object Storage
├─ 100-500 TB
└─ هزینه: $50K
جزئیات Tier 1:
Hardware Spec:
Metadata Servers (2×):
├─ CPU: 2× Intel Xeon Silver
├─ RAM: 256 GB
├─ Storage: 8× SSD 7.68TB (RAID-10)
└─ Network: 2× 100GbE

Storage Servers (10×):
├─ CPU: 1× AMD EPYC
├─ RAM: 128 GB
├─ Storage: 12× NVMe 7.68TB = 92TB raw
├─ RAID: RAID-6 → 70TB usable per server
├─ Network: 2× 100GbE
└─ کل: 10 × 70TB = 700TB usable

Network:
├─ 2× 100GbE Switch (Leaf)
├─ 1× 100GbE Switch (Spine)
└─ مسیریابی: ECMP
Performance Expected:
- Read: 80-100 GB/s aggregate
- Write: 40-60 GB/s aggregate
- Per-server: 10-12 GB/s
- برای 8 GPU × 8 سرور = 64 GPU: 1.25 GB/s per GPU → کافی
مدیریت:
- BeeGFS Management Tools
- Monitoring: Grafana + Prometheus
- Quota: Per-user یا Per-project
سناریو 3: Enterprise AI/HPC (64+ GPU)
پروفایل:
- سازمان: شرکت بزرگ، دانشگاه تحقیقاتی، مرکز ملی HPC
- GPUs: 64-1024+
- Workload: Foundation Models، Large-scale Simulation
- دیتاست: 50TB – 10PB
- بودجه: بالا ($1M-$10M+)
راهکار Storage:
معماری کامل:
Tier 0: NVMe Local (256-1024 TB)
├─ 128 سرور × 32TB = 4 PB total
└─ Managed توسط User (Manual)

Tier 0.5: Burst Buffer (اختیاری)
├─ DDN IME یا Cray DataWarp
├─ 1-5 PB All-NVMe
├─ جذب Burst I/O
└─ هزینه: $2M-$5M

Tier 1: High-Performance Parallel FS
├─ [DDN EXAScaler](https://sevantech.ir/ddn-exascaler-parallel-file-system/) Pro
├─ 2-10 PB usable
├─ Performance: 200-500 GB/s
├─ 30-50 OSS (All-Flash یا Hybrid)
├─ 4-8 MDS (SSD یا [Huawei Dorado](https://sevantech.ir/huawei-oceanstor-dorado-6000-review/))
└─ هزینه: $3M-$8M

Tier 2: Capacity Storage
├─ Object Storage (MinIO، VAST)
├─ 20-100 PB
├─ Performance: 20-100 GB/s
└─ هزینه: $1M-$3M

Tier 3: Archive (خیلی طولانی مدت)
├─ Tape Library (LTO-9)
├─ 100+ PB
└─ هزینه: $500K-$2M
Network Architecture:
Compute Fabric (برای GPU-GPU):
├─ InfiniBand NDR 400 Gb/s
├─ Leaf-Spine topology
└─ مجزا از Storage Network

Storage Fabric:
├─ InfiniBand HDR 200 Gb/s یا
├─ Ethernet 100/200 GbE با RDMA
└─ Direct connect به Storage Servers

Management Network:
├─ 10GbE
└─ Out-of-band management
Features:
- GPUDirect Storage
- Multi-tenancy با QoS
- Advanced monitoring (NVIDIA Base Command)
- Automated tiering
- Disaster Recovery به سایت Remote
- 24/7 Support از Vendor
TCO (5 years):
| هزینه | مبلغ |
|---|---|
| Hardware (Storage) | $5M |
| Network | $2M |
| Software Licenses | $500K/year × 5 = $2.5M |
| Maintenance & Support | $1M/year × 5 = $5M |
| Power & Cooling | $500K/year × 5 = $2.5M |
| Staff (3 FTE) | $300K/year × 5 = $1.5M |
| Total | $18.5M |
اما ROI:
- اگر GPU Utilization 40% → 80% برود:
- Value از 64 GPU: $15M (hardware)
- بهبود 40%: $6M saved
- اگر Time-to-result نصف شود:
- 2x بیشتر Projects در سال
- قیمتگذاری نشدنی برای Competitive Advantage
10. بهینهسازی و عیبیابی
وقتی Storage را Deploy کردید، کار تمام نشده. بیایید ببینیم چطور Performance را Monitor، بهینهسازی و عیبیابی کنیم.
Monitoring: چه چیزهایی را باید نگاه کرد؟
1. GPU Utilization:
Copynvidia-smi dmon -s u
اگر gpu (SM utilization) کمتر از 80% است، ممکن است:
- Storage Bottleneck
- CPU Bottleneck
- Network Bottleneck
- Code inefficient
2. Storage Throughput:
Copy# برای Local Disk
iostat -x 1

# برای Lustre
lfs df -h
watch -n 1 'lctl get_param osc.*.stats'
چه چیزی را ببینید:
r/s: Read IOPSw/s: Write IOPSrMB/s: Read bandwidthwMB/s: Write bandwidthawait: Average wait time
قانون انگشتی:
- برای Training:
rMB/sباید >80% ظرفیت Storage باشد - اگر <50%: Bottleneck جای دیگری است (CPU، Network)
- اگر 50-80%: Storage نزدیک ظرفیت
3. Network Utilization:
Copyiftop -i eth0
اگر Network saturation باشد، Storage remote کند میشود.
4. Data Loader Time:
Copyimport time

for epoch in range(10):
    data_time = 0
    compute_time = 0

    for i, (images, labels) in enumerate(train_loader):
        t0 = time.time()

        # --- Data Loading تمام شد ---
        data_time += time.time() - t0

        # Training
        output = model(images)
        loss = criterion(output, labels)
        loss.backward()
        optimizer.step()

        compute_time += time.time() - t0 - (time.time() - t0)

    print(f"Epoch {epoch}: Data {data_time:.1f}s, Compute {compute_time:.1f}s")
نتیجه ایدهآل:
Epoch 0: Data 120s, Compute 3600s (3% data، 97% compute)
نتیجه بد:
Epoch 0: Data 1800s, Compute 3600s (33% data، 67% compute)
عیبیابی مشکلات رایج
مشکل 1: GPU Utilization پایین (< 60%)
تشخیص:
Copynvidia-smi dmon -s u
# gpu    sm   mem   enc   dec
#   0    45    30     0     0  ← کم!
علت احتمالی:
- Storage کند
- CPU Bottleneck (Data Loading)
- Batch Size خیلی کوچک
راهحل:
Copy# 1. افزایش num_workers
train_loader = DataLoader(..., num_workers=16)  # بود 8

# 2. افزایش prefetch
train_loader = DataLoader(..., prefetch_factor=8)  # بود 4

# 3. بررسی Storage
iostat -x 1  # آیا Disk busy است؟
مشکل 2: Training خیلی کند میشود بعد از چند Epoch
علت: Cache Pollution یا Fragmentation
راهحل:
Copy# پاک کردن Cache
echo 3 > /proc/sys/vm/drop_caches

# Restart Data Loader Workers
# در PyTorch: persistent_workers=False
مشکل 3: Out of Memory در RAM (نه GPU)
علت: Data Loader Workers زیاد، Prefetch زیاد
محاسبه RAM:
RAM مورد نیاز =
    num_workers × prefetch_factor × batch_size × sample_size

مثال:
16 workers × 8 prefetch × 256 batch × 150KB = 4.8 GB
راهحل:
- کاهش
num_workersیاprefetch_factor - استفاده از
max_cached_imagesدر Dataset
مشکل 4: Checkpoint Writing خیلی طول میکشد
تشخیص:
Copyimport time

t0 = time.time()
torch.save(model.state_dict(), 'checkpoint.pt')
print(f"Checkpoint took {time.time() - t0:.1f}s")

# نتیجه: 300s (خیلی زیاد!)
علت:
- Storage کند
- مدل خیلی بزرگ
- Network congestion
راهحل:
Copy# 1. Async Checkpointing
def async_save(state, path):
    threading.Thread(target=torch.save, args=(state, path)).start()

# 2. Compression
torch.save(model, 'model.pt', _use_new_zipfile_serialization=True)

# 3. Sharded Checkpointing
for i, param in enumerate(model.parameters()):
    torch.save(param.cpu(), f'shard_{i}.pt')
بهینهسازی پیشرفته
1. Tune Lustre Stripe:
Copy# برای فایلهای بزرگ (Checkpoint)
lfs setstripe -c -1 -S 16M /mnt/lustre/checkpoints/
# برای فایلهای کوچک (Images)
lfs setstripe -c 1 -S 1M /mnt/lustre/images/
2. استفاده از LMDB برای Small Files:
Copy# بجای 1M فایل JPEG
dataset = ImageFolder('/mnt/lustre/imagenet/')  # کند!

# بهتر: ی فایل LMDB
dataset = LMDBDataset('/mnt/lustre/imagenet.lmdb')  # سریع!
3. Data Prefetching با Dedicated Node:
Compute Nodes (GPUs)
    ↑ (Fast local network)
Prefetch Node (High RAM، Fast Storage)
    ↑ (بارگذاری از Shared Storage)
Shared Storage
Prefetch Node داده را از Shared Storage میخواند، Pre-process میکند و به Compute Nodes میفرستد.
ابزارهای Benchmarking
1. FIO (Flexible I/O Tester):
Copy# Sequential Read
fio --name=seqread --rw=read --bs=1M --size=10G --numjobs=8

# Random Read (مانند Image Loading)
fio --name=randread --rw=randread --bs=4K --size=10G --numjobs=8

# Mixed (70% read، 30% write)
fio --name=mixed --rw=randrw --rwmixread=70 --bs=4K --size=10G
2. IOR (Parallel Filesystem Benchmark):
Copy# آیا Parallel FS خوب Scale میکند؟
mpirun -np 64 ior -t 1M -b 1G -F
# نتیجه ایدهآل:
# 64 Processes × 1 GB/s = 64 GB/s aggregate
3. MLPerf Storage: بنچمارک استاندارد برای AI Storage:
Copygit clone https://github.com/mlcommons/storage
cd storage
./run_benchmark.sh --accelerator-type GPU
نتایج معمولی:
- Entry-level NAS: 500 MB/s
- All-Flash Array: 5-10 GB/s
- Parallel FS (DDN EXAScaler): 50-200 GB/s
پرسشهای متداول (FAQ)
1. تفاوت NAS و SAN چیست و کدام برای AI/HPC بهتر است؟
تفاوت اصلی:
NAS (Network Attached Storage):
- سطح دسترسی: File-level (مثل یک فولدر شبکه)
- پروتکل: NFS، SMB/CIFS
- Network: Ethernet معمولی
- Latency: 100-500 µs
- مزایا: راهاندازی ساده، ارزان، share آسان
- معایب: Performance محدود، مناسب نیست برای Workload سنگین
SAN (Storage Area Network):
- سطح دسترسی: Block-level (مثل یک دیسک local)
- پروتکل: Fibre Channel، iSCSI، NVMe-oF
- Network: اختصاصی (FC) یا Ethernet مخصوص (iSCSI)
- Latency: 100-300 µs (FC)، 0.1 ms (NVMe-oF)
- مزایا: Performance بالا، Latency پایین، IOPS زیاد
- معایب: پیچیده، گران، نیاز به تخصص
برای AI/HPC:
- NAS: فقط برای پروژههای خیلی کوچک (1-2 GPU) یا Backup
- SAN (All-Flash): عالی برای Hot Tier، Metadata Server، Checkpoint Storage
- Parallel FS: بهترین گزینه برای Scale بالا (8+ GPU)
2. چرا Parallel File System برای HPC ضروری است؟
دلیل اصلی: Scale و Concurrency
یک NAS معمولی:
- یک سرور که تمام I/O را Handle میکند
- Bottleneck: Network port (معمولاً 10 GbE = 1.25 GB/s)
- برای 64 سرور → هر سرور فقط 20 MB/s!
یک Parallel Filesystem (مثلاً DDN EXAScaler):
- 20-50 سرور Storage که همزمان سرویس میدهند
- هر سرور: 10 GB/s
- کل: 200-500 GB/s
- برای 64 سرور → هر سرور 3-8 GB/s (کافی برای 8 GPU)
مزایای دیگر:
- Fault Tolerance: اگر یک Storage Server خراب شود، بقیه کار میکنند
- Load Balancing: داده به صورت Striped ذخیره میشود
- Metadata Scalability: چندین Metadata Server
- POSIX Compliant: برنامههای موجود بدون تغییر کار میکنند
3. آیا Cloud Object Storage (S3) برای Training مناسب است؟
پاسخ کوتاه: خیر، مستقیماً نه. اما میتوان از آن به عنوان بخشی از Pipeline استفاده کرد.
چرا مستقیماً نه؟
- Latency بالا: 50-200 ms per request
- Throughput محدود: 100-500 MB/s per connection
- Consistency: Eventually consistent (نه Strongly consistent)
- API: Object API (GetObject) نه File API (fopen)
GPU Training نیاز دارد:
- Latency: <10 ms
- Throughput: 2-10 GB/s per GPU
- Random Access: خواندن هر بخش از فایل
راه درست استفاده از S3:
S3 (Raw Dataset Storage)
↓ (یکباره Prefetch)
Local NVMe یا Fast Parallel FS
↓ (Training میخواند)
GPU Training
مزایای این رویکرد:
- هزینه کم برای Archive
- Scalability نامحدود
- Durability بالا (11 نه)
- توزیع آسان Dataset بین Regions
ابزارها:
- s3fs-fuse: Mount S3 به عنوان Filesystem (کند!)
- AWS DataSync: Transfer سریع بین S3 و Local
- rclone: Sync و Cache هوشمند
4. چگونه میتوانم هزینه Storage را کاهش دهم بدون کاهش Performance؟
راهکارهای عملی:
1. Data Deduplication و Compression:
- Inline Dedup در Huawei Dorado: 3:1 کاهش
- Compression: 2:1 کاهش معمولی
- کل: 6:1 → خرید 1PB، استفاده 6PB
2. Tiered Storage:
- 20% Hot Data روی All-Flash: 200TB × $5/GB = $1M
- 80% Cold Data روی HDD: 800TB × $0.5/GB = $400K
- کل 1PB: $1.4M بجای $5M (All-Flash)
3. Lifecycle Policies:
Age <30 days: Tier 1 (Fast)
Age 30-90 days: Tier 2 (Medium)
Age >90 days: Tier 3 (Archive)
4. Data Format Optimization:
- JPEG 1M فایل: 150 GB، 100MB/s loading
- TFRecord 100 فایل: 120 GB (compression)، 1200MB/s loading
- کاهش 20% Storage، 12x سریعتر!
5. Retention Policy:
- Checkpoints قدیمی: نگه داشتن فقط Best 10
- Training Runs: حذف بعد از 6 ماه
- راهنمای زیرساخت ذخیرهسازی برای جزئیات
5. چگونه بفهمم Storage من Bottleneck است یا CPU/GPU؟
روش تشخیص گام به گام:
گام 1: بررسی GPU Utilization
Copynvidia-smi dmon -s u -c 100
اگر gpu (SM Utilization) معمولاً <75%: → مشکل خارج از GPU است (شامل Storage)
گام 2: Profiling با PyTorch Profiler
Copywith torch.profiler.profile(
    activities=[torch.profiler.ProfilerActivity.CPU,
                torch.profiler.ProfilerActivity.CUDA],
    with_stack=True
) as prof:
    for step, batch in enumerate(train_loader):
        # Training code
        if step >= 10:
            break

prof.export_chrome_trace("trace.json")
باز کردن trace.json در Chrome://tracing
- اگر بخش زیادی “DataLoader” باشد → Storage/CPU Bottleneck
- اگر بخش زیادی “CUDA Kernel” باشد → GPU Bottleneck
گام 3: بررسی Storage Throughput
Copy# در حین Training
iostat -x 1 10

# چه چیزی ببینیم:
# %util > 80% → Storage busy (ممکن است Bottleneck باشد)
# rMB/s < 50% ظرفیت Storage → مشکل جای دیگر است
گام 4: Monitoring CPU
Copympstat -P ALL 1
اگر CPU cores مشغول “iowait” باشند → Storage کند است
خلاصه تصمیمگیری:
| علائم | علت | راهحل |
|---|---|---|
| GPU<75%، CPU high، Storage busy | Storage Bottleneck | Upgrade Storage |
| GPU<75%، CPU high، Storage idle | CPU Bottleneck | بیشتر Workers، بهتر Code |
| GPU 95%، CPU low | مشکلی نیست! | – |
| GPU<75%، CPU low، Storage idle | Batch Size کم | افزایش Batch |
6. آیا SSD ارزش دارد یا HDD کافی است؟
بستگی کامل به Workload دارد:
HDD کافی است برای:
- Sequential Workloads (مثل Video، CFD Output)
- Archive و Backup
- Capacity Storage (Tier 2/3)
- پروژههای با Budget محدود
SSD (NVMe) ضروری است برای:
- Random I/O (مثل ImageNet، Genomics)
- Metadata Server در Parallel FS
- Checkpoint Storage (burst write)
- Latency-sensitive applications
مقایسه عددی:
| متریک | HDD (7200 RPM) | SATA SSD | NVMe SSD |
|---|---|---|---|
| Sequential Read | 200 MB/s | 550 MB/s | 7000 MB/s |
| Random IOPS (4K) | 100-200 | 100K | 1M |
| Latency | 5-10 ms | 50-100 µs | 10-50 µs |
| هزینه (per TB) | $15-$20 | $50-$100 | $100-$200 |
| Durability | 3-5 سال | 5 سال | 5 سال |
توصیه عملی:
- Hybrid: 20% SSD (Hot)، 80% HDD (Capacity)
- مثال:
- 200TB SSD: Metadata، Checkpoints، Active datasets
- 1.8PB HDD: Raw data، Archive، Backup
- کل: 2PB با هزینه معقول و Performance خوب
نتیجهگیری و توصیههای نهایی
Storage نه یک جزء جانبی، بلکه عامل تعیینکننده موفقیت در هر پروژه AI/HPC است. بدون Storage مناسب، حتی قدرتمندترین GPUها و CPUها نمیتوانند پتانسیل واقعی خود را نشان دهند.
نکات کلیدی
1. Storage باید با مقیاس Compute هماهنگ باشد:
- 1-8 GPU: NVMe Local + NAS کوچک
- 8-64 GPU: Parallel Filesystem (DDN EXAScaler) + Tiering
- 64+ GPU: معماری کامل با Burst Buffer، All-Flash (Huawei Dorado)، Parallel FS، Object Storage
2. یک راهحل واحد برای همه وجود ندارد:
- Deep Learning: پهنای باند بالا، Sequential I/O
- Scientific Computing: Latency پایین، Random I/O، Metadata
- Inference: Latency بسیار پایین، Caching
3. Tiered Storage کلید صرفهجویی است:
- 80% savings ممکن است با Tiering هوشمند
- 20% داده، 80% استفاده
4. Monitoring و Optimization مداوم:
- GPU Utilization باید >80% باشد
- Storage Throughput باید Match کند با نیاز Compute
- عیبیابی سریع = صرفهجویی میلیونها دلار
توصیههای عملی برای شروع
مرحله 1: Profiling قبل از خرید هر چیزی، workload خود را Profile کنید:
Copy# کد ساده Profiling
import time
data_time = []
compute_time = []

for epoch in range(3):
    for batch in train_loader:
        t0 = time.time()
        # ... training ...
        data_time.append(time.time() - t0)

print(f"Average Data Time: {np.mean(data_time):.2f}s")
print(f"Average Compute Time: {np.mean(compute_time):.2f}s")
اگر Data Time > 20% Total Time → نیاز به بهبود Storage
مرحله 2: مشاوره با متخصصین با تیم سوان تک تماس بگیرید:
- ارزیابی رایگان نیازهای Storage
- طراحی معماری مناسب
- مقایسه TCO راهحلهای مختلف
- پشتیبانی در پیادهسازی
مرحله 3: شروع کوچک، رشد تدریجی
- ابتدا: NVMe Local + NAS کوچک
- رشد: افزودن Parallel Filesystem
- Scale: ارتقا به Enterprise Architecture
منابع اضافی
مقالات مرتبط سوان تک:
- راهنمای جامع DDN EXAScaler Parallel File System
- بررسی Huawei OceanStor Dorado 6000 All-Flash Array
- راهنمای زیرساخت ذخیرهسازی سازمانی
- راهکارهای Storage سازمانی
- DGX SuperPOD و معماری Storage
منابع خارجی:
تماس با ما
سوان تک (SevanTech) آماده ارائه مشاوره تخصصی و راهکارهای Storage برای پروژههای AI/HPC شماست.