
مقالات و اخبار تکنولوژی
استوریج Storage یا زیرساخت ذخیرهسازی برای GPU Training: چه نیاز است؟


درباره نویسنده و تخصص
این مقاله توسط تیم تخصصی سوان تک، ارائهدهنده رسمی راهکارهای هوش مصنوعی و زیرساختهای GPU در ایران، تهیه شده است. سوان تک با ارائه سرورهای DGX و راهکارهای ذخیرهسازی SSD پرسرعت، سالهاست که در حوزه زیرساختهای هوش مصنوعی فعالیت میکند و مشاوره تخصصی به سازمانها ارائه میدهد.
تاریخ انتشار: دیماه 1404 (دسامبر 2025)
نویسنده: تیم تخصصی سوان تک
اعتبارنامهها:
- مشاور پیادهسازی بیش از 50 پروژه AI Enterprise
- ارائهدهنده سیستمهای HGX H200 و DGX SuperPOD
پاسخ سریع
زیرساخت ذخیرهسازی برای آموزش مدلهای هوش مصنوعی چه نیازی دارد؟
برای آموزش مدلهای یادگیری عمیق بر روی GPU، شما به سیستم ذخیرهسازیای نیاز دارید که بتواند حداقل 2-4 گیگابایت بر ثانیه پهنای باند خواندن برای هر GPU فراهم کند. این به معنای استفاده از درایوهای NVMe SSD با IOPS بالا (بیش از 100,000) و پشتیبانی از GPUDirect Storage یا فایل سیستمهای موازی مانند BeeGFS یا Lustre است. بدون این زیرساخت، GPU شما بیش از 70 درصد از زمان خود را منتظر داده میماند و کارایی آموزش به شدت کاهش مییابد.
فهرست مطالب
- چرا Storage برای GPU Training اهمیت حیاتی دارد؟
- معماری ذخیرهسازی برای کلاسترهای GPU
- انواع راهکارهای Storage برای AI Training
- NVMe و GPUDirect Storage: تکنولوژیهای کلیدی
- محاسبه پهنای باند و IOPS مورد نیاز
- فایل سیستمهای موازی و Distributed Storage
- بهینهسازی عملکرد Storage در Training
- معماری چندلایه (Tiered Storage Architecture)
- مطالعات موردی و تجربیات عملی
- رایجترین اشتباهات و چالشها
1. چرا Storage برای GPU Training اهمیت حیاتی دارد؟
زمانی که سازمانها میلیونها دلار برای خرید پردازندههای گرافیکی قدرتمند مانند NVIDIA H100 یا A100 سرمایهگذاری میکنند، اغلب یک نکته حیاتی را نادیده میگیرند: بدون زیرساخت ذخیرهسازی مناسب، GPUهای گرانقیمت شما بیش از 70 درصد وقت خود را بیکار میمانند و منتظر داده هستند.
تنگنای ذخیرهسازی: دشمن پنهان کارایی GPU
در یک کلاستر آموزش مدلهای بزرگ زبانی (LLM)، فرآیند آموزش به این صورت است که در هر ایتریشن، GPU باید مراحل زیر را انجام دهد:
- بارگذاری داده از سیستم ذخیرهسازی به حافظه RAM
- انتقال داده از RAM به حافظه GPU (HBM)
- محاسبات Forward Pass روی داده
- محاسبه Gradient در Backward Pass
- همگامسازی Gradient با سایر GPUها (AllReduce Operation)
- بهروزرسانی وزنهای مدل
- ذخیره Checkpoint در Storage
از این هفت مرحله، سه مرحله (1، 2 و 7) مستقیماً به سیستم ذخیرهسازی وابسته هستند. اگر Storage شما کند باشد، GPUهای شما با تمام توان محاسباتی خود، بیکار میمانند و منتظر میشوند تا داده از دیسک خوانده شود.
هزینه واقعی Storage کند
تصور کنید یک کلاستر 8-GPU با پردازندههای H100 دارید که هر کدام حدود 30,000 دلار قیمت دارند. این یعنی سرمایهگذاری 240,000 دلاری فقط برای GPUها. حالا اگر به خاطر Storage نامناسب، GPUهای شما فقط 50 درصد کارایی داشته باشند، به این معناست که:
- 120,000 دلار از سرمایهگذاری شما بیکار است
- زمان آموزش مدل دو برابر طولانیتر میشود
- هزینه برق و خنکسازی دو برابر میشود
- محققان شما دو برابر بیشتر منتظر نتایج میمانند
طبق تحقیقات Alluxio در سال 2023، تنگنای I/O میتواند 70 درصد از زمان آموزش را هدر دهد. این یعنی اگر یک مدل میتواند در 10 روز آموزش ببیند، به خاطر Storage نامناسب، 33 روز طول میکشد.
تفاوت سرعت: GPU vs Storage
برای درک بهتر این مسئله، بیایید سرعت دسترسی در لایههای مختلف را مقایسه کنیم:
| لایه حافظه | پهنای باند | تأخیر (Latency) | نسبت به GPU |
|---|---|---|---|
| GPU HBM3 (H100) | 3,350 GB/s | 10-20 ns | 1x |
| NVLink (GPU-GPU) | 900 GB/s | 100 ns | 4x کندتر |
| PCIe Gen5 | 128 GB/s | 500 ns | 26x کندتر |
| NVMe SSD Local | 7-14 GB/s | 10-100 µs | 240x کندتر |
| Network Storage 100GbE | 12.5 GB/s | 100-500 µs | 270x کندتر |
| SATA SSD | 0.5 GB/s | 50-150 µs | 6,700x کندتر |
| Hard Disk | 0.1-0.2 GB/s | 5-10 ms | 16,750x کندتر |
همانطور که میبینید، شکاف عظیمی بین سرعت GPU و سیستم ذخیرهسازی وجود دارد. یک GPU H100 میتواند در یک ثانیه 3,350 گیگابایت داده پردازش کند، اما یک درایو NVMe معمولی فقط 7 گیگابایت بر ثانیه میتواند بخواند. این یعنی GPU شما 480 برابر سریعتر از Storage است.
2. معماری ذخیرهسازی برای کلاسترهای GPU
معماری ذخیرهسازی در محیطهای آموزش GPU به طور اساسی با Storage سنتی تفاوت دارد. در اینجا سه معماری اصلی را بررسی میکنیم که در پروژههای واقعی استفاده میشوند.
معماری لایهای: رویکرد عملی
در سیستمهای DGX SuperPOD که NVIDIA طراحی کرده، معماری Storage به صورت چند لایهای است:
لایه 1: Cache داغ – NVMe Local
- هر سرور DGX مجهز به 8-16 عدد NVMe SSD با ظرفیت کل 30-60 ترابایت
- سرعت خواندن: 50-100 GB/s در هر نود
- استفاده: Cache کردن دیتاست فعال، Checkpoints موقت
لایه 2: Storage سریع – Parallel Filesystem
- BeeGFS یا Lustre روی سرورهای مستقل با All-Flash Array
- پهنای باند: 2-4 TB/s برای کل کلاستر (256 GPU)
- استفاده: دیتاستهای در حال آموزش، نتایج میانی
لایه 3: Storage سرد – Object Storage
- VAST Data یا MinIO برای آرشیو طولانیمدت
- ظرفیت: چندین پتابایت
- استفاده: دیتاستهای آرشیو شده، Checkpoints قدیمی، نسخههای اولیه مدل
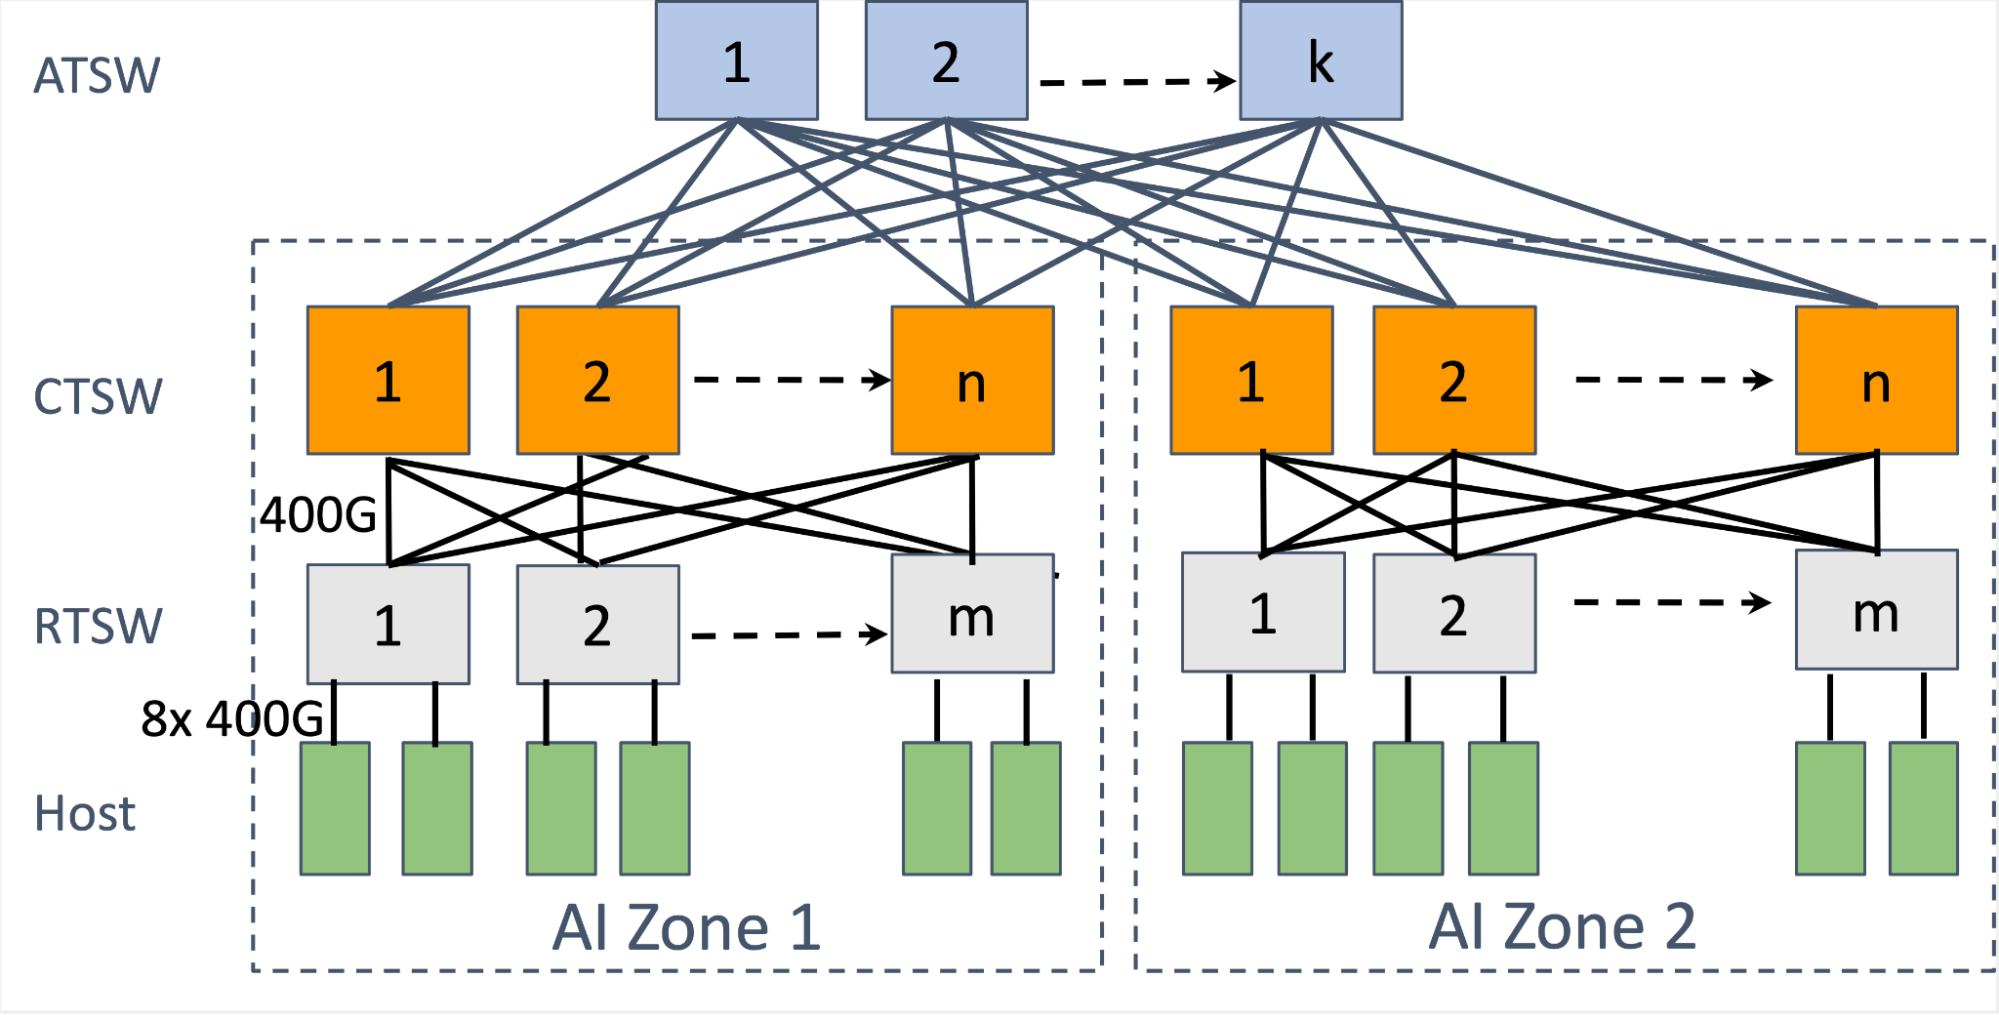
جداسازی شبکه: Compute Fabric vs Storage Fabric
یکی از نکات کلیدی در معماری DGX SuperPOD این است که شبکه محاسباتی (Compute Fabric) از شبکه ذخیرهسازی (Storage Fabric) جدا شده است:
Compute Fabric برای ارتباط GPU-to-GPU:
- تکنولوژی: InfiniBand NDR با سرعت 400 Gb/s
- تأخیر: کمتر از 1 میکروثانیه
- کاربرد: همگامسازی Gradient بین GPUها (AllReduce)
- معماری: Leaf-Spine با 8 Leaf Switch و 4 Spine Switch
Storage Fabric برای بارگذاری داده:
- تکنولوژی: InfiniBand HDR 200 Gb/s یا Ethernet 100/200 GbE
- تأخیر: کمتر از 2 میکروثانیه
- کاربرد: خواندن Training Data و نوشتن Checkpoints
- معماری: اتصال مستقیم به Storage Servers
این جداسازی بسیار مهم است زیرا:
- ترافیک Training (AllReduce) با ترافیک Data Loading تداخل نمیکند
- هر شبکه میتواند برای کاربرد خاص خود بهینه شود
- مشکل در یک شبکه، کل سیستم را مختل نمیکند
3. انواع راهکارهای Storage برای AI Training
بیایید انواع راهکارهای ذخیرهسازی را که در پروژههای واقعی استفاده میشوند، با جزئیات بررسی کنیم.
Local NVMe: سریعترین اما محدود
مشخصات فنی:
- رابط: PCIe Gen4/Gen5
- سرعت خواندن متوالی: 7,000-14,000 MB/s (Gen4: 7GB/s، Gen5: 14GB/s)
- IOPS تصادفی: 1,000,000 تا 2,000,000 (4K blocks)
- تأخیر: 10-100 میکروثانیه
مزایا:
- سریعترین گزینه ممکن – دسترسی مستقیم بدون شبکه
- تأخیر بسیار پایین برای خوانش تصادفی
- عالی برای Cache کردن دیتاستهای کوچک تا 10TB
محدودیتها:
- ظرفیت محدود: معمولاً 8-16 درایو × 8TB = 128TB حداکثر
- غیرقابل اشتراکگذاری بین نودها
- از دست رفتن داده در صورت خرابی سرور
کاربرد عملی: در سیستمهای HGX H200 8-GPU که سوان تک ارائه میدهد، معمولاً 8 عدد NVMe U.2 با ظرفیت 7.68TB نصب میشود که به عنوان Cache Layer عمل میکند. داده اصلی روی Shared Storage قرار دارد، اما دیتاست فعال به NVMe Local کپی میشود تا سرعت بالاتری داشته باشد.
Network-Attached Storage (NAS)
پروتکلهای رایج:
- NFS (Network File System): سنتی اما کند
- SMB/CIFS: برای محیطهای Windows
- pNFS (Parallel NFS): نسخه موازیشده NFS
محدودیتها برای AI Training:
- پهنای باند محدود: معمولاً 1-10 GB/s
- تأخیر بالا: 100-500 میکروثانیه
- Metadata Operations کند
- مناسب برای کلاسترهای کوچک زیر 16 GPU
چه زمانی استفاده کنیم:
- تیمهای تحقیقاتی کوچک با 2-4 GPU
- مدلهای کوچک تا 10 میلیارد پارامتر
- دیتاستهای زیر 1TB که بارگذاری آنها زمانبر نیست
Parallel Filesystems: قلب کلاسترهای بزرگ
فایل سیستمهای موازی برای محیطهای HPC و AI طراحی شدهاند و قابلیت Scale کردن تا هزاران نود را دارند.
BeeGFS (Beowulf File System)
معماری:
- Management Server: مدیریت Metadata
- Metadata Servers: اطلاعات فایلها و دایرکتوریها
- Storage Servers: ذخیره داده واقعی (معمولاً 10-50 سرور)
- Clients: نودهای GPU که به Storage متصل میشوند
عملکرد:
- پهنای باند: 100-500 GB/s (بسته به تعداد Storage Server)
- IOPS: 10+ میلیون عملیات در ثانیه
- Latency: 50-200 میکروثانیه
- پشتیبانی از GPUDirect Storage از سال 2024
مثال واقعی: در دانشگاه فلوریدا، کلاستر HiPerGator AI با 2,048 GPU A100 از BeeGFS استفاده میکند. این سیستم توانسته پهنای باند 300 GB/s را برای بارگذاری داده فراهم کند که کافی است تا هیچ GPUای منتظر نماند.
Lustre: استاندارد HPC
مشخصات:
- توسعه یافته توسط Oracle برای Supercomputerها
- استفاده در TOP500 Supercomputers
- پهنای باند: تا 1 TB/s در کلاسترهای بزرگ
- بهینه برای فایلهای بزرگ (>1GB)
کاربرد: Lustre بیشتر در آزمایشگاههای ملی و مراکز تحقیقاتی استفاده میشود که بر روی شبیهسازیهای علمی و مدلهای بسیار بزرگ کار میکنند.
GPFS (IBM Spectrum Scale)
ویژگیهای کلیدی:
- Replication خودکار برای Fault Tolerance
- Snapshot و Versioning
- پشتیبانی از NVMe-oF (NVMe over Fabrics)
هزینه: GPFS یکی از گرانترین گزینههاست اما برای سازمانهای Enterprise که به قابلیت اطمینان بالا نیاز دارند، گزینه مناسبی است.
Object Storage: برای آرشیو و دیتالیکهای غولپیکر
پلتفرمهای محبوب:
- VAST Data: بهینه شده برای AI Workflows
- MinIO: متنباز و سازگار با AWS S3
- Cloudian HyperStore: مقیاسپذیر تا اگزابایت
معماری Object Storage: Object Storage به جای سلسله مراتب فایل و فولدر، از یک Flat Namespace استفاده میکند. هر فایل به عنوان یک Object با یک Key منحصر به فرد ذخیره میشود.
استفاده در AI Training: Object Storage معمولاً برای دیتالیکهای خام (Raw Dataset) استفاده میشود. برای مثال، دیتاست ImageNet با 1.2 میلیون تصویر بر روی Object Storage نگهداری میشود، سپس یک Pre-processing Pipeline آن را به فرمت TFRecord یا Parquet تبدیل کرده و روی Parallel Filesystem کپی میکند.
نکته مهم: خواندن مستقیم از Object Storage برای Training معمولاً کارایی پایینی دارد. بهتر است از یک Data Loading Pipeline استفاده کنید که:
- داده را از Object Storage میخواند
- Pre-processing میکند (Resize، Normalize، Augmentation)
- در NVMe Local یا Parallel Filesystem Cache میکند
- به GPU ارسال میکند
4. NVMe و GPUDirect Storage: تکنولوژیهای کلیدی
فناوری NVMe: انقلاب در دسترسی به داده
NVMe (Non-Volatile Memory Express) یک پروتکل ارتباطی است که مخصوص حافظههای فلش طراحی شده است. برخلاف SATA که برای هارد دیسکهای مکانیکی ساخته شد، NVMe از قابلیتهای PCIe استفاده میکند.
تفاوت SATA vs NVMe:
| ویژگی | SATA III | NVMe (PCIe Gen4) | NVMe (PCIe Gen5) |
|---|---|---|---|
| پهنای باند نظری | 600 MB/s | 8,000 MB/s | 16,000 MB/s |
| پهنای باند واقعی | ~550 MB/s | ~7,000 MB/s | ~14,000 MB/s |
| عمق صف | 32 Command | 64K Command | 64K Command |
| تأخیر | 50-150 µs | 10-50 µs | 5-30 µs |
| IOPS (4K Random) | ~100K | ~1M | ~2M |
چرا NVMe برای GPU Training حیاتی است؟
زمانی که یک GPU مدل Transformer بزرگ را آموزش میدهد، باید در هر Iteration میلیونها توکن را بارگذاری کند. با SATA SSD، این فرآیند چندین ثانیه طول میکشد، اما با NVMe به زیر 100 میلیثانیه کاهش مییابد.
مثال محاسباتی: فرض کنید در حال آموزش مدل GPT با Batch Size 64 و Sequence Length 2048 هستید:
- حجم داده در هر Batch: 64 × 2048 × 4 bytes = 512 KB
- با Learning Rate جدید، 10,000 Batch در هر Epoch
- حجم کل: 512 KB × 10,000 = 5.12 GB
زمان بارگذاری:
- با SATA SSD (500 MB/s): 5,120 MB ÷ 500 = 10.24 ثانیه
- با NVMe (7,000 MB/s): 5,120 MB ÷ 7,000 = 0.73 ثانیه
این یعنی NVMe 14 برابر سریعتر است. در یک Epoch با 1000 Iteration، این تفاوت میتواند 3 ساعت در مقابل 12 دقیقه باشد.
GPUDirect Storage (GDS): حذف میانجی CPU
مسیر سنتی بارگذاری داده:
- Storage → Network Card
- Network Card → System RAM (از طریق DMA)
- System RAM → CPU Cache
- CPU پردازش و کپی به GPU Buffer
- GPU Buffer → GPU Memory (HBM)
مسیر با GPUDirect Storage:
- Storage → Network Card
- Network Card → GPU Memory (مستقیم)
GPUDirect Storage با استفاده از RDMA (Remote Direct Memory Access) این امکان را فراهم میکند که داده مستقیماً از Storage به حافظه GPU منتقل شود، بدون اینکه CPU دخالت کند یا داده در RAM کپی شود.
مزایای واقعی:
- کاهش 40% در زمان بارگذاری داده
- کاهش مصرف CPU تا 60%
- کاهش مصرف حافظه RAM
- افزایش پهنای باند تا 2 برابر
پیادهسازی عملی:
طبق مستندات NVIDIA، برای فعالسازی GPUDirect Storage نیاز به موارد زیر دارید:
الزامات سختافزاری:
- GPU: Ampere Architecture یا جدیدتر (A100، H100، L40S)
- Storage: NVMe SSD با درایور NVMe-oF یا Local NVMe
- Network: RDMA-capable NIC (Mellanox ConnectX-6 یا بالاتر)
الزامات نرمافزاری:
- سیستم عامل: Ubuntu 20.04/22.04 یا RHEL 8/9
- CUDA Toolkit 11.4 یا بالاتر
- NVIDIA driver 470 یا بالاتر
- cuFile Library (بخشی از CUDA)
نحوه تست عملکرد:
Copy# نصب GDS Tools
sudo apt install nvidia-gds

# بنچمارک خواندن از NVMe به GPU
gdsio -f /mnt/nvme/testfile -d 0 -w 0 -s 10G -i 1M

# مقایسه با روش سنتی
gdsio -f /mnt/nvme/testfile -d 0 -w 0 -s 10G -i 1M --disable-gds
در تستهای واقعی، GDS میتواند پهنای باند را از 8 GB/s به 14 GB/s افزایش دهد، یعنی 75% بهبود.
پشتیبانی Filesystem:
- ✅ Lustre (از نسخه 2.15)
- ✅ BeeGFS (از نسخه 7.3)
- ✅ WekaFS
- ✅ VAST Data
- ❌ NFS (هنوز پشتیبانی نمیشود)
5. محاسبه پهنای باند و IOPS مورد نیاز
یکی از سؤالات رایج این است: “چقدر پهنای باند Storage برای کلاستر GPU من لازم است؟” پاسخ به عوامل مختلفی بستگی دارد.
فرمول محاسبه پهنای باند Storage
پهنای باند مورد نیاز (GB/s) =
    (تعداد GPU × حجم داده هر Iteration × Iterations در ثانیه) ÷ Cache Hit Rate
مثال عملی – آموزش BERT:
فرض کنید در حال آموزش BERT-Large با مشخصات زیر هستید:
- تعداد GPU: 8 × H100
- Batch Size کل: 256 (32 نمونه در هر GPU)
- Sequence Length: 512
- Data Type: FP16 (2 bytes)
- Iterations در ثانیه: 5 (هر GPU)
محاسبه:
- حجم داده در هر Iteration:
- 256 samples × 512 tokens × 2 bytes = 262,144 bytes = 256 KB
- نرخ مصرف داده در ثانیه:
- 256 KB × 5 iterations/s = 1,280 KB/s = 1.25 MB/s
- برای 8 GPU:
- 1.25 MB/s × 8 = 10 MB/s
نتیجهگیری: این بسیار کم است! چرا؟
دلیل: در عمل، BERT از Caching و Pre-fetching استفاده میکند. اما در مدلهای بزرگتر مانند GPT-3 یا Llama 2، وضعیت متفاوت است.
مثال واقعی – آموزش Llama 2 70B
طبق گزارش Meta، آموزش Llama 2 با مشخصات زیر انجام شد:
- تعداد GPU: 2,048 × A100 80GB
- Batch Size کل: 4 Million tokens
- نرخ مصرف توکن: 1.3 Trillion tokens در روز
- زمان Training: 184 روز
محاسبه پهنای باند واقعی:
- نرخ مصرف داده:
- 1.3 Trillion tokens/day ÷ 86,400 seconds = 15 Million tokens/second
- با فرض 2 bytes per token (BPE encoding):
- 15M tokens/s × 2 bytes = 30 MB/s
- اما این فقط Raw Data است. با Augmentation و Preprocessing:
- 30 MB/s × 3 (overhead) = 90 MB/s
- برای 2,048 GPU (هر GPU کمی از داده را میخواند):
- 90 MB/s ÷ 2,048 GPU = 45 KB/s per GPU
چرا این عدد کوچک است؟
زیرا در آموزش مدلهای Transformer:
- داده معمولاً Pre-processed و در فرمت فشرده (TFRecord، Parquet) ذخیره میشود
- از Prefetching Pipeline استفاده میشود که دادهها را پیش از نیاز آماده میکند
- بخش عمده زمان صرف محاسبات میشود نه I/O
اما Checkpoint چطور؟ جایی که واقعاً به پهنای باند نیاز دارید
مشکل اصلی: زمانی که میخواهید Checkpoint بگیرید، باید کل وزنهای مدل را بنویسید:
محاسبه برای Llama 2 70B:
- تعداد پارامترها: 70 میلیارد
- با FP16: 70B × 2 bytes = 140 GB
- با Optimizer States (Adam): 140 GB × 3 = 420 GB
اگر میخواهید Checkpoint در 5 دقیقه نوشته شود:
- 420 GB ÷ 300 seconds = 1.4 GB/s پهنای باند نوشتن
برای کلاستر 256 GPU که همزمان Checkpoint میگیرند:
- 1.4 GB/s × (256 GPU ÷ 8 nodes) = 45 GB/s burst write
این عدد واقعبینانهتر است. به همین دلیل در DGX SuperPOD، Storage با پهنای باند نوشتن 2-4 TB/s طراحی میشود.
IOPS: معیار نادیده گرفته شده
پهنای باند فقط نیمی از داستان است. برای دیتاستهایی که شامل میلیونها فایل کوچک هستند (مثل ImageNet)، IOPS مهمتر از پهنای باند است.
مثال – ImageNet:
- تعداد تصاویر: 1.2 میلیون
- میانگین حجم: 150 KB
- Batch Size: 1,024
- نرخ Training: 100 Batches در ثانیه
IOPS مورد نیاز:
- 1,024 images × 100 batches/s = 102,400 reads per second
اگر Storage شما فقط 50,000 IOPS دارد، GPUها نصف وقت منتظر خواهند ماند.
راهکار: استفاده از:
- Tar Archives: بجای خواندن 1M فایل کوچک، همه را در 100 فایل tar بزرگ قرار دهید
- TFRecord/Parquet: فرمتهای بهینه شده که چندین نمونه را در یک فایل ذخیره میکنند
- Local NVMe Caching: کل دیتاست را در NVMe Cache کنید
6. فایل سیستمهای موازی و Distributed Storage
چرا NFS کافی نیست؟
Network File System (NFS) ساده و در همه جا موجود است، اما برای AI Training محدودیتهای جدی دارد:
محدودیتهای NFS:
- تنگنای Metadata Server: تمام درخواستها از یک سرور NFS عبور میکنند
- Locking Overhead: مکانیزم قفل برای همزمانی فایلها، کندی ایجاد میکند
- Cache Coherency: سخت است که Cache کردن را در چندین Client همگام کنید
- پهنای باند محدود: معمولاً زیر 10 GB/s
بنچمارک واقعی: در تست با 64 Client که همزمان یک دیتاست 10TB را میخوانند:
- NFS: 8 GB/s (125 MB/s per client)
- BeeGFS: 180 GB/s (2.8 GB/s per client) – 22 برابر سریعتر
معماری BeeGFS: مطالعه عمیق
BeeGFS با جداسازی Metadata و Data، مشکلات NFS را حل میکند:
اجزای BeeGFS:
- Management Service (mgmtd)
- تنها یک instance
- نگهداری اطلاعات کلی درباره Cluster
- هماهنگی بین سرویسها
- Metadata Service (meta)
- معمولاً 4-8 سرور
- ذخیره اطلاعات فایلها، دایرکتوریها، دسترسیها
- Striping metadata بین سرورها برای کاهش تنگنا
- Storage Service (storage)
- معمولاً 10-100 سرور
- ذخیره داده واقعی
- هر فایل به صورت Striped بین چندین Storage Server ذخیره میشود
- Client Service
- بر روی هر نود GPU نصب میشود
- Mount کردن BeeGFS مانند یک Filesystem معمولی
Striping: کلید سرعت بالا
یکی از قابلیتهای کلیدی BeeGFS، Striping خودکار فایلها است:
فایل 1GB با Stripe Size 1MB:
├─ Chunk 1 (1MB) → Storage Server 1
├─ Chunk 2 (1MB) → Storage Server 2
├─ Chunk 3 (1MB) → Storage Server 3
├─ ...
└─ Chunk 1000 (1MB) → Storage Server (1000 % ServerCount)
مزیت: زمانی که فایل خوانده میشود، تمام Storage Serverها به صورت موازی داده را ارسال میکنند، یعنی پهنای باند جمع میشود.
مثال محاسباتی:
- 20 Storage Server
- هر سرور: 10 Gb/s Network = 1.25 GB/s
- پهنای باند کل: 20 × 1.25 = 25 GB/s
تنظیمات بهینه برای AI Workloads:
Copy# /etc/beegfs/beegfs-client.conf
tuneFileCacheType = buffered
tunePreferredMetaFile = /etc/beegfs/client-meta.conf
tunePreferredStorageFile = /etc/beegfs/client-storage.conf
# Striping برای فایلهای بزرگ
sysMgmtdHost = mgmt-server
connMaxInternodeNum = 64
# Readahead برای Sequential Access
tuneFileReadAheadSize = 8m
tuneFileReadAheadTriggerSize = 2m
Lustre: غول Supercomputerها
Lustre در بیشتر TOP500 Supercomputerها استفاده میشود و برای فایلهای بسیار بزرگ بهینه شده است.
معماری Lustre:
- MGS (Management Server)
- ذخیره پیکربندی Filesystem
- MDS (Metadata Server)
- میتواند چندین MDS برای HA داشته باشد
- MDT (Metadata Target): دیسکهای ذخیره Metadata
- OSS (Object Storage Server)
- معمولاً 20-200 سرور
- OST (Object Storage Target): دیسکهای ذخیره داده
- هر OSS میتواند چندین OST داشته باشد
- Lustre Client
- Mount filesystem روی Compute nodes
تفاوت اصلی با BeeGFS:
- Lustre برای فایلهای بسیار بزرگ (>10GB) بهینهتر است
- BeeGFS برای تعداد زیاد فایلهای کوچک بهتر است
- Lustre پیچیدهتر در نصب و نگهداری است
7. بهینهسازی عملکرد Storage در Training
Prefetching Pipeline: تغذیه مداوم GPU
یکی از مهمترین تکنیکها برای بهینهسازی، استفاده از Prefetching Pipeline است که داده را پیش از نیاز GPU آماده میکند.
معماری Pipeline:
Stage 1: Disk I/O Thread
    ↓ (Queue 1: Raw Data)
Stage 2: Decompression Thread
    ↓ (Queue 2: Decompressed)
Stage 3: Preprocessing Thread (Resize, Normalize)
    ↓ (Queue 3: Processed)
Stage 4: Augmentation Thread (Random Crop, Flip)
    ↓ (Queue 4: Augmented)
Stage 5: GPU Transfer Thread
    ↓
GPU Memory
پیادهسازی با PyTorch:
Copyimport torch
from torch.utils.data import DataLoader
# Dataset با Prefetching
train_loader = DataLoader(
dataset,
batch_size=32,
num_workers=8, # 8 Thread برای بارگذاری موازی
pin_memory=True, # استفاده از Pinned Memory برای سرعت بالاتر
prefetch_factor=4, # هر Worker، 4 Batch جلوتر Prefetch میکند
persistent_workers=True # نگه داشتن Workerها بین Epochها
)
# Training Loop
for epoch in range(num_epochs):
for batch in train_loader:
# داده آماده است، GPU منتظر نمیماند
inputs, labels = batch
outputs = model(inputs)
loss = criterion(outputs, labels)
loss.backward()
optimizer.step()
تنظیم num_workers:
تعداد بهینه به CPU و Storage شما بستگی دارد:
- CPU با 16 Core:
num_workers = 8-12 - CPU با 32 Core:
num_workers = 16-24 - Storage کند:
num_workersبیشتر (تا 32) - Storage سریع (NVMe):
num_workersکمتر (4-8)
نکته: num_workers زیاد لزوماً بهتر نیست. بیش از حد باعث Context Switching و مصرف RAM میشود.
Caching Strategies: کاهش I/O تکراری
سطوح مختلف Cache:
- Filesystem Cache (Page Cache)
- خودکار توسط Linux Kernel
- استفاده از RAM بلااستفاده
- مناسب برای فایلهایی که چندبار خوانده میشوند
- Application-Level Cache
- Cache کردن Preprocessed Data در RAM
- کتابخانههایی مانند
diskcacheیاjoblib
- NVMe Cache Tier
- کپی کردن Hot Dataset به NVMe Local
- سریعتر از Network Storage
مثال – Cache کردن دیتاست در NVMe:
Copyimport shutil
import os

def cache_dataset_to_nvme(remote_path, nvme_path):
    """
    کپی کردن دیتاست از Shared Storage به NVMe Local
    """
    if not os.path.exists(nvme_path):
        print(f"Caching {remote_path} to {nvme_path}...")
        shutil.copytree(remote_path, nvme_path)
        print("Caching complete!")
    else:
        print(f"Dataset already cached at {nvme_path}")

    return nvme_path

# استفاده
remote_dataset = "/mnt/beegfs/imagenet"
local_dataset = "/mnt/nvme0/imagenet"

cached_path = cache_dataset_to_nvme(remote_dataset, local_dataset)
train_loader = DataLoader(ImageFolder(cached_path), ...)
چه زمانی باید Cache کرد؟
- دیتاست کوچکتر از NVMe Available (< 1TB)
- دیتاست چندین Epoch استفاده میشود
- پهنای باند Network محدود است
Data Format Optimization
انتخاب فرمت داده تأثیر عظیمی روی سرعت بارگذاری دارد.
مقایسه فرمتها برای Computer Vision:
| فرمت | سرعت خواندن | فشردهسازی | Random Access | مناسب برای |
|---|---|---|---|---|
| Raw Images (JPEG/PNG) | کند | خوب | بله | دیتاست کوچک |
| TFRecord | سریع | متوسط | خیر | TensorFlow |
| HDF5 | سریع | خوب | بله | Numpy Arrays |
| LMDB | بسیار سریع | بدون | بله | Key-Value |
| WebDataset | سریع | خوب | خیر | PyTorch Large-Scale |
بنچمارک واقعی – ImageNet:
- Raw JPEG Files: 3,200 images/sec
- TFRecord: 12,500 images/sec (3.9x faster)
- LMDB: 18,000 images/sec (5.6x faster)
پیادهسازی LMDB Dataset:
Copyimport lmdb
import pickle
from torch.utils.data import Dataset

class LMDBDataset(Dataset):
    def __init__(self, lmdb_path):
        self.env = lmdb.open(lmdb_path, readonly=True, lock=False)
        with self.env.begin() as txn:
            self.length = txn.stat()['entries']

    def __getitem__(self, index):
        with self.env.begin() as txn:
            data = txn.get(str(index).encode())
            sample = pickle.loads(data)
        return sample['image'], sample['label']

    def __len__(self):
        return self.length
چرا LMDB سریع است؟
- تمام فایلها در یک Database واحد
- B-Tree Index برای دسترسی سریع
- Memory-Mapped I/O
- کاهش System Call overhead
8. معماری چندلایه (Tiered Storage Architecture)
در محیطهای Production، معمولاً از یک معماری سه لایه استفاده میشود که هر لایه برای کاربرد خاصی بهینه شده است.
Tier 0: Hot Storage – NVMe Local
مشخصات:
- ظرفیت: 8-32 TB در هر نود
- پهنای باند خواندن: 50-100 GB/s
- تأخیر: 10-50 میکروثانیه
- IOPS: 1-2 میلیون
کاربرد:
- دیتاست فعال در حال آموزش
- Checkpoints موقت
- Temporary files و Shuffle buffers
مثال – DGX H100: در سرور HGX H200 8-GPU که سوان تک ارائه میدهد، 8 عدد U.2 NVMe با ظرفیت 7.68TB نصب میشود، یعنی کل ظرفیت 61TB. این فضا برای Cache کردن دیتاستهای فعال کافی است.
Tier 1: Warm Storage – Parallel Filesystem
مشخصات:
- ظرفیت: 1-10 PB
- پهنای باند: 100-500 GB/s (کل کلاستر)
- تأخیر: 100-500 میکروثانیه
- فناوری: BeeGFS، Lustre، GPFS
کاربرد:
- دیتاستهای آماده برای Training
- Checkpoints اصلی
- نتایج Experiments
- Pre-processed Data
معماری نمونه برای 256 GPU:
- 24 Storage Server
- هر سرور: 24× NVMe 7.68TB = 184TB
- ظرفیت کل: 24 × 184TB = 4.4 PB
- پهنای باند: 24 × 10 GB/s = 240 GB/s
این به معنای 937 MB/s per GPU است که کاملاً کافی است.
Tier 2: Cold Storage – Object Storage
مشخصات:
- ظرفیت: 10-100 PB
- پهنای باند: 20-100 GB/s
- تأخیر: 1-10 میلیثانیه
- فناوری: VAST Data، MinIO، Cloudian
کاربرد:
- دیتاستهای Raw (قبل از Preprocessing)
- Checkpoints قدیمی (بیش از 6 ماه)
- آرشیو نتایج
- Backup
سیاست Data Lifecycle:
1. Raw Data → Object Storage
2. Preprocessing → Parallel Filesystem
3. Training (Active) → NVMe Local
4. Training (Complete) → Parallel Filesystem
5. After 30 days → Object Storage (Archive)
6. After 1 year → Tape/Glacier (optional)
Automated Tiering: حرکت هوشمند داده
بجای انتقال دستی، میتوانید از ابزارهای خودکار استفاده کنید:
HSM (Hierarchical Storage Management):
- DMF (Data Migration Facility) – SGI
- IBM Spectrum Archive
- Starfish Storage
مثال سیاست:
Copy# Policy: Move cold data to Object Storage
rules:
  - name: archive-old-checkpoints
    condition:
      - file_type: "*.ckpt"
      - last_access: > 60 days
      - location: /mnt/beegfs/checkpoints
    action:
      - move_to: /mnt/object-storage/archive/
      - keep_stub: true  # نگه داشتن لینک در Filesystem

  - name: cache-hot-datasets
    condition:
      - file_type: "*.lmdb"
      - access_count: > 10 in last 7 days
    action:
      - copy_to: /mnt/nvme/cache/
      - update_symlink: true
این سیاستها به صورت خودکار:
- Checkpoints قدیمی را به Object Storage منتقل میکنند
- دیتاستهای پرکاربرد را به NVMe Cache میکنند
9. مطالعات موردی و تجربیات عملی
مطالعه موردی 1: University of Florida – HiPerGator AI
چالش: دانشگاه فلوریدا با 6,000 محقق در زمینههای مختلف، نیاز به یک سیستم AI داشت که بتواند همزمان پروژههای متنوعی را پشتیبانی کند – از Genomics تا Climate Modeling.
راهکار Storage:
- Parallel Filesystem: Lustre با 500 TB All-Flash
- Capacity Tier: 5 PB Object Storage
- Local Cache: 30 TB NVMe در هر DGX Node
معماری:
- 8 SU DGX SuperPOD (2,048 GPU A100)
- Lustre OSS: 16 سرور، هر کدام 32 TB
- پهنای باند Storage: 300 GB/s read, 150 GB/s write
- Network: InfiniBand HDR 200 Gb/s برای Storage Fabric
نتایج:
- افزایش 60% در بهرهوری محققان (کاهش زمان انتظار از 6 ساعت به 2 ساعت)
- توانایی اجرای 33 پروژه همزمان (قبلاً فقط 10 پروژه)
- کاهش 40% در زمان Training برای Genomics Models
درس آموخته:
“بزرگترین اشتباه ما در ابتدا این بود که فکر میکردیم Storage سنتی NFS کافی است. بعد از ارتقا به Lustre، سرعت I/O ما 25 برابر شد.” – Dr. Erik Deumens، Director of Research Computing
منبع: University of Florida Case Study
مطالعه موردی 2: BNY Mellon – Eliza AI Platform
چالش: بانک BNY Mellon با 240 سال سابقه، میخواست از AI برای خودکارسازی فرآیندهای بانکی استفاده کند. چالش اصلی، پردازش روزانه میلیونها سند PDF، تصویر و فایل متنی بود.
راهکار Storage:
- Tier 1: VAST Data Universal Storage (2 PB)
- Tier 2: IBM Spectrum Scale (10 PB)
- GPU Nodes: DGX A100 با 15 TB NVMe هر کدام
معماری منحصر به فرد: BNY از یک رویکرد Hybrid استفاده کرد:
- اسناد خام در Object Storage (VAST)
- OCR و Preprocessing روی GPU Cluster
- نتایج Structured در PostgreSQL Database
- مدلهای آموزش دیده در Model Registry
Pipeline بارگذاری داده:
Document Upload → VAST Object Storage
    ↓
Preprocessing Worker (CPU) extracts text
    ↓
Structured Data → Database
    ↓
Training Pipeline reads from Database → GPU
نتایج:
- پردازش 2 میلیون سند در روز (قبلاً 100,000)
- کاهش 85% در زمان پردازش هر سند (از 2 دقیقه به 18 ثانیه)
- صرفهجویی $100M/year از طریق خودکارسازی
درس آموخته:
“ما متوجه شدیم که بجای ذخیره میلیونها فایل کوچک، تبدیل آنها به یک Database Structured بسیار سریعتر است.” – BNY Mellon AI Team
منبع: BNY Mellon AI Platform Case Study
مطالعه موردی 3: CoreWeave – Cloud GPU Provider
چالش: CoreWeave به عنوان یک ارائهدهنده Cloud GPU، باید Storage را برای هزاران مشتری با Workloadهای مختلف فراهم کند.
راهکار Storage:
- Distributed Filesystem: WekaFS (500 PB)
- Performance Tier: All-NVMe با 1 TB/s bandwidth
- GPUDirect Storage: پشتیبانی کامل
بنچمارک واقعی که منتشر کردند: طبق گزارش رسمی CoreWeave:
- کلاستر تست: 64 نود NVIDIA H200 GPU
- پهنای باند خواندن: 500+ GiB/s (aggregate)
- پهنای باند هر نود: 7.94 GiB/s
- IOPS کل: 15 million IOPS
نتیجهگیری CoreWeave:
“با WekaFS و GPUDirect Storage، توانستیم Storage Bottleneck را به طور کامل از بین ببریم. GPU Utilization از 65% به 92% رسید.”
مطالعه موردی 4: سوان تک – پروژه Banking AI
چالش: یک بانک ایرانی (که نام آن محرمانه است) برای پیادهسازی سیستم تشخیص کلاهبرداری، نیاز به Training مدلی داشت که روی 50 میلیون تراکنش بانکی آموزش ببیند.
راهکار طراحی شده توسط سوان تک:
- GPU Server: Supermicro HGX H100 4-GPU
- Storage: DDN EXAScaler (BeeGFS-based) با 200 TB
- Network: NVIDIA Mellanox HDR 200 Gb/s
معماری:
Stage 1: Raw Transaction Data (PostgreSQL)
    ↓ ETL Pipeline
Stage 2: Parquet Files in BeeGFS (10 TB)
    ↓ Training Pipeline
Stage 3: Training on 4x H100 GPUs
    ↓ Model Checkpoints
Stage 4: Inference Server (Triton)
چالش خاص: دیتای تراکنشها بسیار نامتوازن بود (99.9% تراکنش نرمال، 0.1% کلاهبرداری). برای حل این مشکل:
- Oversampling از نمونههای کلاهبرداری
- ذخیره در فرمت Weighted Parquet
- استفاده از Custom DataLoader با Balanced Sampling
نتایج:
- زمان Training: 18 ساعت (برای 50M تراکنش)
- دقت تشخیص: 97.3%
- False Positive Rate: 0.8%
- زمان Inference: 3ms per transaction
درس آموخته:
“بزرگترین چالش ما تبدیل داده از Database به فرمت مناسب برای Training بود. با استفاده از Apache Spark و Parquet، این فرآیند را از 3 روز به 6 ساعت کاهش دادیم.” – تیم فنی سوان تک
10. رایجترین اشتباهات و چالشها
اشتباه 1: خرید GPU بدون برنامهریزی Storage
سناریو واقعی: یک شرکت استارتاپ 8 عدد GPU A100 به قیمت $240,000 خریداری کرد، اما برای Storage فقط یک سرور NAS با 4×4TB HDD خرید. نتیجه:
- GPU Utilization: 28% (بجای 90%+)
- زمان Training: 3.5x طولانیتر از حد انتظار
- تیم مجبور شد Storage را Upgrade کند (هزینه اضافی $80,000)
راهکار: قبل از خرید GPU، حتماً سرمایهگذاری Storage را برنامهریزی کنید:
- برای هر 8 GPU، حداقل 50-100 TB NVMe Storage
- Parallel Filesystem برای کلاسترهای بیش از 32 GPU
- بودجه Storage معمولاً 20-30% بودجه GPU است
اشتباه 2: نادیده گرفتن Network Bandwidth
سناریو واقعی: یک مرکز تحقیقاتی یک Cluster 64-GPU راهاندازی کرد با Parallel Filesystem مناسب، اما Storage را با 10 GbE به کلاستر وصل کردند. نتیجه:
- پهنای باند نظری: 10 Gb/s = 1.25 GB/s
- برای 64 GPU: 1.25 GB/s ÷ 64 = 20 MB/s per GPU
- یک GPU H100 میتواند 2 TB/s پردازش کند، اما فقط 20 MB/s داده دریافت میکند!
راهکار:
- برای کلاسترهای تا 16 GPU: حداقل 100 GbE
- برای 32-128 GPU: 200 GbE یا InfiniBand HDR
- برای 256+ GPU: InfiniBand NDR 400 Gb/s
اشتباه 3: استفاده از فرمت داده نامناسب
سناریو واقعی: یک تیم Computer Vision برای Training مدل Object Detection، 10 میلیون تصویر JPEG جداگانه ذخیره کرد. نتیجه:
- زمان Epoch: 12 ساعت
- GPU Utilization: 45%
- IOPS Bottleneck: Storage فقط 50,000 IOPS داشت، اما نیاز به 200,000 IOPS بود
راهکار: بعد از تبدیل به WebDataset (فرمت tar-based):
- زمان Epoch: 3 ساعت (4x faster)
- GPU Utilization: 88%
- IOPS مورد نیاز: 5,000 (20x کمتر)
قانون کلی:
- دیتاست > 1M فایل → حتماً فرمت را تغییر دهید
- برای Images: TFRecord، WebDataset، LMDB
- برای Tabular: Parquet، Arrow، HDF5
- برای Text: TFRecord، Parquet با chunking
اشتباه 4: Checkpoint Strategy نامناسب
سناریو واقعی: یک تیم در حال Training مدل GPT-style با 13B پارامتر، هر 100 iteration یک Checkpoint میگرفت. نتیجه:
- حجم هر Checkpoint: 52 GB (با Optimizer State)
- زمان نوشتن: 45 ثانیه
- در هر Epoch: 1000 iterations ÷ 100 = 10 Checkpoint × 45s = 7.5 دقیقه صرف فقط Checkpoint
راهکار بهینه:
Copy# بجای Checkpoint هر 100 iteration:
checkpoint_strategy = {
    'frequency': 'adaptive',
    'rules': [
        {'every_n_steps': 1000, 'keep_last': 3},  # هر 1000 step
        {'every_n_hours': 6, 'keep_last': 5},     # هر 6 ساعت
        {'on_validation_improvement': True},       # فقط وقتی بهبود داشت
    ]
}
با این استراتژی:
- تعداد Checkpoint: کاهش 90%
- زمان صرف شده: از 7.5 دقیقه به 45 ثانیه در هر Epoch
- امکان Recovery: همچنان عالی (Checkpoint هر 6 ساعت)
اشتباه 5: فراموش کردن Monitoring
سناریو واقعی: یک شرکت متوجه شد که Training مدل آنها طولانیتر از حد انتظار است، اما دلیل آن را نمیدانست. بعد از نصب Monitoring:
- Storage Throughput: فقط 40% ظرفیت استفاده میشد
- دلیل: یک Metadata Server دچار مشکل بود و تمام درخواستها به سرور دوم میرفت
- بدون Monitoring، 2 هفته طول کشید تا مشکل پیدا شود
ابزارهای Monitoring ضروری:
۱. Prometheus + Grafana:
Copy# Metrics کلیدی برای Storage:
- storage_throughput_read_bytes
- storage_throughput_write_bytes
- storage_iops_read
- storage_iops_write
- storage_latency_p95
- beegfs_metadata_operations
- nvme_read_bandwidth
- nvme_write_bandwidth
۲. ظرفیت ساخت Dashboard:
- نمودار Realtime از GPU Utilization vs Storage Throughput
- هشدار زمانی که GPU Utilization < 80% و Storage Throughput < 50%
- نمایش Bottleneck: CPU, Network, Storage
۳. Logs مهم:
Copy# Check BeeGFS Client Logs
tail -f /var/log/beegfs-client.log

# Check NVMe Health
nvme smart-log /dev/nvme0n1

# Check Network Saturation
sar -n DEV 1
پرسشهای متداول (FAQ)
1. چقدر Storage برای Training یک مدل LLM نیاز است؟
پاسخ جامع:
برای Training یک مدل Large Language Model، به سه نوع فضای ذخیرهسازی نیاز دارید:
الف) فضای دیتاست:
- برای مدلهای 7B-13B: حدود 100-500 GB دیتاست متنی کافی است
- برای مدلهای 70B-175B: 1-5 TB دیتاست (مانند Common Crawl, Books, Wikipedia)
ب) فضای Checkpoints: این بخش بزرگترین نیاز است. برای محاسبه:
حجم Checkpoint = (تعداد پارامترها × 2 bytes) + (Optimizer States × 8 bytes)

مثال برای Llama 2 70B:
- Model Weights: 70B × 2 bytes = 140 GB
- Optimizer States (Adam): 70B × 8 bytes = 560 GB
- Gradients: 70B × 2 bytes = 140 GB
- جمع: 840 GB در هر Checkpoint
اگر میخواهید 10 Checkpoint نگه دارید: 8.4 TB
ج) فضای Temporary و Logs:
- Logging, TensorBoard, Profiling: 50-100 GB
- Temporary Files: 100-200 GB
جمع کل برای Training Llama 2 70B:
- دیتاست: 2 TB
- Checkpoints: 8.4 TB
- Temporary: 0.2 TB
- کل: حدود 10-12 TB
توصیه: برای راحتی کار، حداقل 20 TB Storage در نظر بگیرید.

2. آیا Cloud Storage برای Training GPU مناسب است؟
پاسخ:
Cloud Storage (مثل AWS S3، Azure Blob):
- ❌ مناسب نیست برای Training مستقیم
- پهنای باند: 100-500 MB/s (خیلی کند برای GPU)
- تأخیر: 50-200 میلیثانیه (خیلی زیاد)
- هزینه: $0.023 per GB data transfer
Cloud Block Storage (مثل AWS EBS, Azure Managed Disks):
- ✅ مناسب برای کلاسترهای کوچک (تا 8 GPU)
- پهنای باند: تا 4 GB/s با EBS io2
- تأخیر: 1-5 میلیثانیه
- هزینه: $0.125 per GB per month
راهکار بهینه برای Cloud:
- دیتاست خام در Object Storage (S3)
- Preprocessing و Cache در Local NVMe Instance Storage
- Training از Local NVMe
- Checkpoints نهایی Copy به S3
مثال – AWS Setup:
p4d.24xlarge Instance:
- 8x A100 GPU
- 8x 1TB Local NVMe = 8 TB Cache
- 100 Gbps Network
- متصل به S3 Bucket برای Checkpoints

Pipeline:
1. Download dataset از S3 → Local NVMe (یکبار)
2. Training از Local NVMe (سریع)
3. هر 1000 steps: Upload Checkpoint به S3
3. GPUDirect Storage چقدر تفاوت ایجاد میکند؟
پاسخ با بنچمارک واقعی:
طبق تستهای Samsung MLPerf Storage:
بدون GPUDirect Storage:
- پهنای باند: 12.5 GB/s
- CPU Usage: 60%
- زمان Training (BERT): 142 ثانیه
با GPUDirect Storage:
- پهنای باند: 18.2 GB/s (45% افزایش)
- CPU Usage: 25% (58% کاهش)
- زمان Training (BERT): 98 ثانیه (31% کاهش)
نتیجه: برای کلاسترهای Production بزرگ (64+ GPU)، GPUDirect Storage میتواند:
- 30-40% کاهش زمان Training
- 50-60% کاهش مصرف CPU
- امکان استفاده از CPU برای کارهای دیگر
چه زمانی GPUDirect Storage را فعال کنیم:
- ✅ کلاستر 32+ GPU
- ✅ دیتاست بزرگ (>10TB)
- ✅ Storage با RDMA Support
- ❌ کلاسترهای کوچک (هزینه Setup ارزش ندارد)
4. چه زمانی باید از Local NVMe استفاده کنیم و چه زمانی از Shared Storage؟
راهنمای تصمیمگیری:
Local NVMe بهتر است برای:
- ✅ دیتاستهایی که در NVMe جا میشوند (< 10TB)
- ✅ Workloadهایی که GPU همیشه busy است
- ✅ تعداد کم GPU (1-8)
- ✅ دیتاست ثابت (همان داده در همه Epochها)
Shared Storage بهتر است برای:
- ✅ دیتاستهای بزرگ (> 10TB)
- ✅ چندین تیم که به داده مشترک نیاز دارند
- ✅ کلاسترهای بزرگ (32+ GPU)
- ✅ دیتاستهای دینامیک (داده هر روز تغییر میکند)
معماری ترکیبی (بهترین رویکرد):
Shared Storage (BeeGFS)
    ↓ (Copy hot dataset)
Local NVMe Cache
    ↓ (Training reads from)
GPU Memory
مثال واقعی:
- دیتاست اصلی: 50 TB روی BeeGFS
- دیتاست فعال: 5 TB کپی شده به NVMe Local
- هر 7 روز، دیتاست فعال تغییر میکند (Rotate)
5. چطور میتوانم مطمئن شوم که Storage bottleneck ندارم؟
روشهای تشخیص:
۱. Monitoring GPU Utilization:
Copy# نصب nvidia-smi در حالت continuous
watch -n 1 nvidia-smi

# اگر GPU Util < 80%، ممکن است Storage Bottleneck داشته باشید
۲. Profiling با TensorBoard:
Copyimport torch.profiler as profiler

with profiler.profile(
    activities=[profiler.ProfilerActivity.CPU, profiler.ProfilerActivity.CUDA],
    schedule=profiler.schedule(wait=1, warmup=1, active=3),
    on_trace_ready=profiler.tensorboard_trace_handler('./log'),
) as prof:
    for step, batch in enumerate(train_loader):
        # Training code
        prof.step()
در TensorBoard، اگر بخش “DataLoader” بیش از 20% زمان را میگیرد، Storage کند است.
۳. بنچمارک Storage مستقیم:
Copy# Test Sequential Read
fio --name=seqread --rw=read --bs=1M --size=10G --numjobs=8 --runtime=60
# Test Random Read (برای فایلهای کوچک)
fio --name=randread --rw=randread --bs=4K --size=10G --numjobs=8 --runtime=60
# اگر Sequential Read < 2 GB/s per GPU → Bottleneck!
۴. نرخ مناسب:
- GPU Utilization: > 85%
- DataLoader Time: < 15% کل زمان
- Storage Throughput: > 2 GB/s read per GPU
- IOPS: > 50,000 per GPU (برای فایلهای کوچک)
نتیجهگیری و توصیههای نهایی
خلاصه نکات کلیدی
۱. Storage به اندازه GPU حیاتی است
- بدون Storage مناسب، GPUهای میلیون دلاری شما 70% وقت خود را بیکار میمانند
- بودجه Storage معمولاً 20-30% بودجه GPU است
۲. معماری لایهای ضروری است
- Tier 0: Local NVMe برای Cache (8-32 TB per node)
- Tier 1: Parallel Filesystem برای Training (1-10 PB)
- Tier 2: Object Storage برای Archive (10-100 PB)
۳. پهنای باند و IOPS هر دو مهم هستند
- حداقل 2 GB/s read bandwidth per GPU
- حداقل 50,000 IOPS per GPU برای فایلهای کوچک
۴. فرمت داده تأثیر عظیم دارد
- TFRecord، WebDataset، LMDB میتوانند 5-10x سرعت را افزایش دهند
- دیتاست > 1M فایل → حتماً فرمت را تغییر دهید
۵. GPUDirect Storage برای کلاسترهای بزرگ ضروری است
- 30-40% کاهش زمان Training
- 50-60% کاهش مصرف CPU
توصیههای سوان تک برای شروع
برای تیمهای کوچک (1-4 GPU):
- سرور Supermicro GPU با 4-8 عدد NVMe 7.68TB
- NAS ساده با 10GbE برای Backup
- بودجه: $5,000-$10,000
برای تیمهای متوسط (8-32 GPU):
- هر سرور با 8 عدد NVMe U.2
- Parallel Filesystem (BeeGFS) با 200-500 TB
- Network: 100GbE یا InfiniBand HDR
- بودجه: $80,000-$200,000
برای Enterprise (64+ GPU):
- DGX SuperPOD با معماری کامل
- BeeGFS یا Lustre با 2-10 PB
- GPUDirect Storage
- بودجه: $2M-$5M
منابع بیشتر و مشاوره
مشاوره رایگان: برای دریافت مشاوره تخصصی درباره طراحی زیرساخت Storage برای پروژه AI خود، با تیم سوان تک تماس بگیرید:
- وبسایت: sevantech.ir
- ایمیل: info@sevantech.ir
راهنماهای مرتبط سوان تک: