



توضیحات
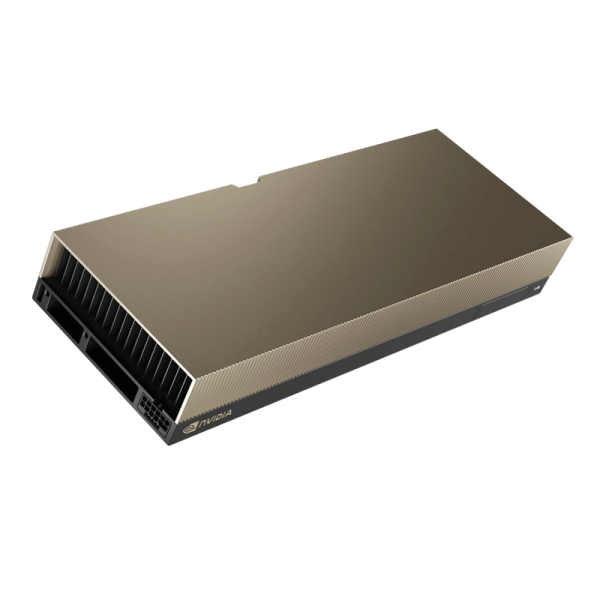
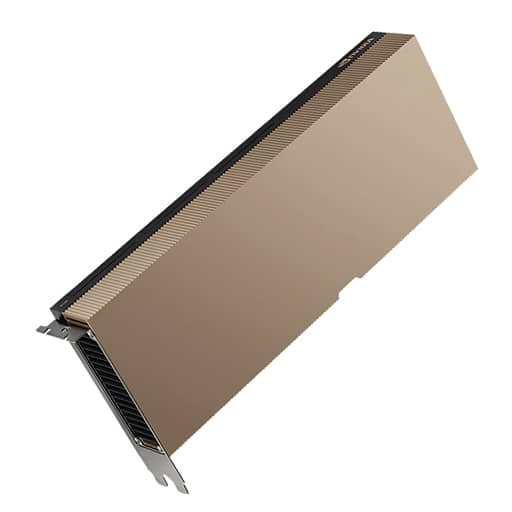
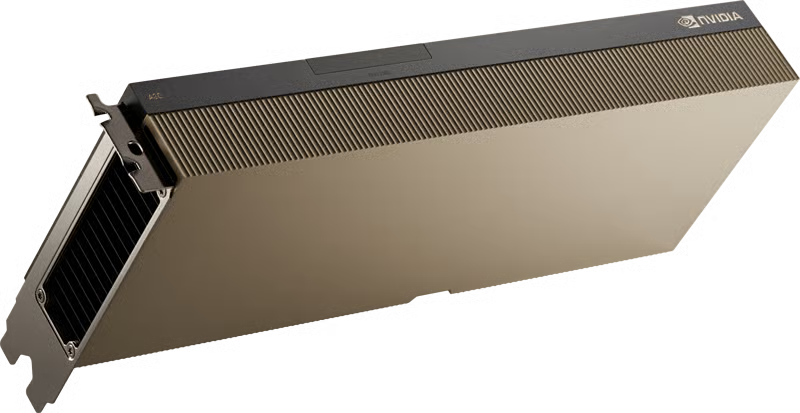
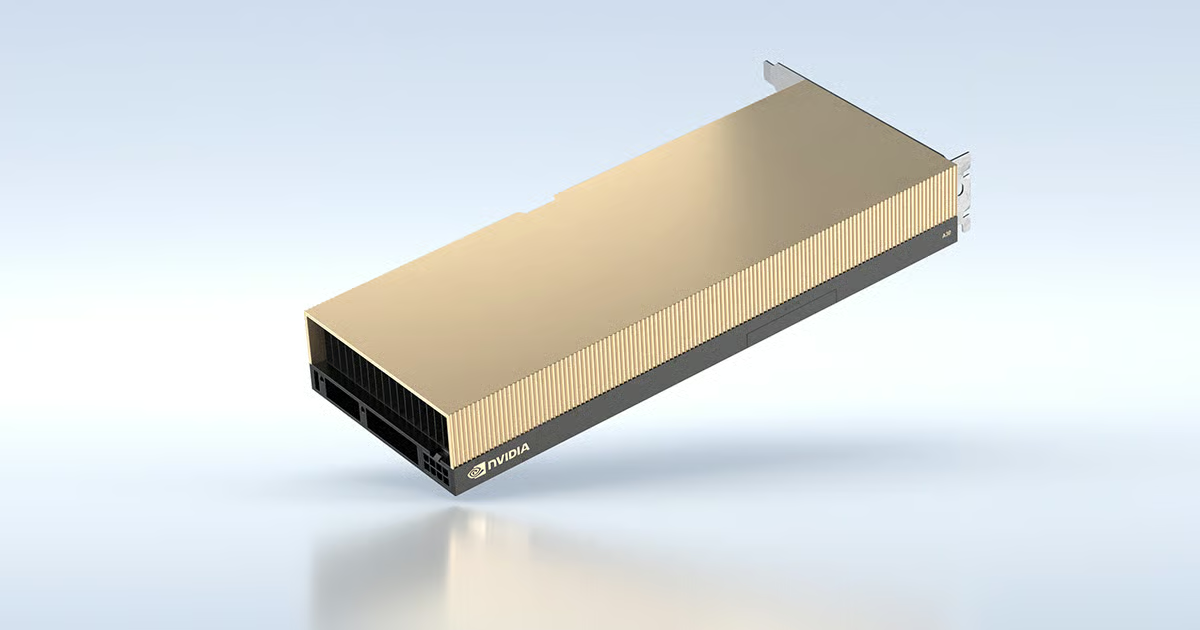
در عصر دیجیتال امروز که هوش مصنوعی و یادگیری ماشین به بخش جداییناپذیر کسبوکارها تبدیل شدهاند، انتخاب زیرساخت محاسباتی مناسب میتواند تفاوت میان موفقیت و شکست پروژههای سازمانی باشد. پردازنده گرافیکی NVIDIA A30 Tensor Core به عنوان یک راهحل میانرده اما بسیار کارآمد، پلی میان نیازهای محاسباتی سازمانهای کوچک تا بزرگ ایجاد کرده است.
این محصول که بر پایه معماری پیشرفته NVIDIA Ampere طراحی شده، ترکیبی منحصربهفرد از توان محاسباتی، کارایی انرژی و انعطافپذیری را در قالب فرم فکتور استاندارد PCIe ارائه میدهد. NVIDIA A30 به ویژه برای استنتاج هوش مصنوعی در مقیاس گسترده، محاسبات علمی و تحلیل دادههای حجیم طراحی شده و با ویژگی منحصربهفرد Multi-Instance GPU، امکان تقسیمبندی منابع پردازشی را برای چندین کاربر همزمان فراهم میکند.
در این مقاله جامع، به بررسی دقیق معماری، مشخصات فنی، کاربردهای تخصصی و مزایای رقابتی NVIDIA A30 Tensor Core GPU خواهیم پرداخت تا تصویری شفاف از توانمندیهای این پردازنده برای مدیران IT و متخصصان زیرساخت ارائه دهیم.
NVIDIA A30 Tensor Core چیست و چه تفاوتی با سایر GPUها دارد؟
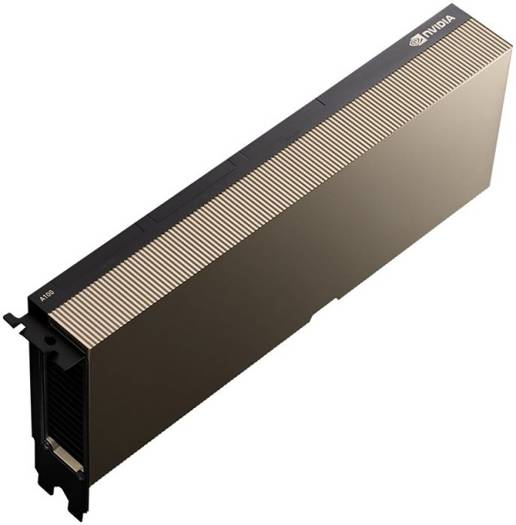
NVIDIA A30 Tensor Core GPU یک پردازنده گرافیکی تخصصی دیتاسنتر است که در سال 2021 به عنوان بخشی از خانواده محصولات Ampere به بازار عرضه شد. این محصول در دستهبندی GPUهای میانرده قرار میگیرد اما با ویژگیهای منحصربهفرد خود، ارزش افزوده قابل توجهی برای سازمانهایی که به دنبال تعادل میان هزینه و عملکرد هستند، ایجاد میکند.

برخلاف کارتهای گرافیک ورک استیشن مانند RTX A4000 یا RTX A5500 که برای رندرینگ گرافیکی و طراحی حرفهای بهینه شدهاند، NVIDIA A30 به طور خاص برای محیطهای دیتاسنتر و کارهای محاسباتی سنگین مانند آموزش و استنتاج مدلهای یادگیری عمیق، شبیهسازیهای علمی و تحلیل دادههای بزرگ طراحی شده است.
این GPU با بهرهمندی از فناوری Multi-Instance GPU و هستههای Tensor نسل سوم، امکان اجرای همزمان چندین بار کاری مستقل را با تضمین کیفیت سرویس (QoS) فراهم میکند. این ویژگی به ویژه برای ارائهدهندگان خدمات ابری و سازمانهایی که منابع محاسباتی را بین تیمهای مختلف تقسیم میکنند، بسیار ارزشمند است.
مشخصات فنی کامل NVIDIA A30 Tensor Core GPU
جدول مشخصات تفصیلی
| مشخصات فنی | جزئیات |
|---|---|
| معماری پردازنده | NVIDIA Ampere (GA100) |
| تعداد هستههای CUDA | 3,584 |
| هستههای Tensor نسل سوم | 224 |
| هستههای RT (Ray Tracing) | – |
| حافظه گرافیک | 24GB HBM2 |
| رابط حافظه | 3072-bit |
| پهنای باند حافظه | 933 GB/s |
| فرکانس پایه پردازنده | 930 MHz |
| فرکانس بوست پردازنده | 1440 MHz |
| مصرف برق (TDP) | 165 وات |
| رابط سیستمی | PCI Express 4.0 x16 |
| پشتیبانی از NVLink | بله (200 GB/s برای دو GPU) |
| فرم فکتور | Dual-Slot FHFL |
| سیستم خنککاری | Passive Cooling |
| تعداد پارتیشن MIG | تا 4 پارتیشن مستقل |
عملکرد محاسباتی بر حسب دقت
| نوع دقت محاسباتی | عملکرد |
|---|---|
| FP64 (Double Precision) | 5.2 TFLOPS |
| FP64 Tensor Core | 10.3 TFLOPS |
| FP32 (Single Precision) | 10.3 TFLOPS |
| TF32 Tensor Core | 82 TFLOPS (165 TFLOPS با Sparsity) |
| BFLOAT16 Tensor Core | 165 TFLOPS (330 TFLOPS با Sparsity) |
| FP16 Tensor Core | 165 TFLOPS (330 TFLOPS با Sparsity) |
| INT8 Tensor Core | 330 TOPS (661 TOPS با Sparsity) |
| INT4 Tensor Core | 661 TOPS (1321 TOPS با Sparsity) |
معماری Ampere: نسل جدید محاسبات شتابدهندهشده
معماری NVIDIA Ampere که زیربنای A30 را تشکیل میدهد، نمایانگر یک جهش کیفی در پردازش موازی و محاسبات هوش مصنوعی است. این معماری با بهبودهای اساسی نسبت به نسل Volta، کارایی و قدرت محاسباتی را به سطح جدیدی رسانده است.
ویژگیهای کلیدی معماری Ampere در A30:
-
هستههای Tensor نسل سوم: این هستههای اختصاصی برای محاسبات ماتریسی با پشتیبانی از دقتهای متنوع (از FP64 تا INT4)، امکان شتابدهی به طیف گستردهای از کارهای یادگیری ماشین را فراهم میکنند
-
پشتیبانی از Structural Sparsity: این فناوری نوآورانه با شناسایی و حذف محاسبات غیرضروری، عملکرد استنتاج را تا دو برابر افزایش میدهد
-
حافظه HBM2 با پهنای باند بالا: 24 گیگابایت حافظه HBM2 با پهنای باند 933 گیگابایت بر ثانیه، 1.5 برابر حافظه بیشتر و 3 برابر پهنای باند بالاتری نسبت به T4 ارائه میدهد
-
Multi-Instance GPU (MIG): امکان تقسیم یک GPU به تا 4 نمونه مستقل با تضمین ایزولهسازی سختافزاری و کیفیت سرویس
ویژگی منحصربهفرد Multi-Instance GPU (MIG)
یکی از برجستهترین ویژگیهای NVIDIA A30، قابلیت Multi-Instance GPU است که انعطافپذیری بینظیری در مدیریت منابع محاسباتی ارائه میدهد.
پیکربندیهای MIG در A30:
- 4 پارتیشن 6 گیگابایتی (برای کارهای کوچک و متعدد)
- 2 پارتیشن 12 گیگابایتی (برای کارهای متوسط)
- 1 پارتیشن 24 گیگابایتی (برای کارهای سنگین)
مزایای استفاده از MIG:
- بهرهوری بهینه از منابع GPU در محیطهای چندکاربره
- تضمین کیفیت سرویس (QoS) برای هر پارتیشن
- ایزولهسازی سختافزاری کامل بین کاربران مختلف
- انعطافپذیری در تخصیص منابع بر اساس نیاز کاری
- کاهش هزینههای عملیاتی با اشتراکگذاری هوشمند منابع
این قابلیت به ویژه برای ارائهدهندگان خدمات ابری، دانشگاهها و مراکز تحقیقاتی که منابع محاسباتی را بین تیمهای مختلف تقسیم میکنند، بسیار ارزشمند است.
کاربردهای تخصصی NVIDIA A30 Tensor Core GPU
استنتاج هوش مصنوعی در مقیاس سازمانی
NVIDIA A30 به طور خاص برای استنتاج (Inference) مدلهای یادگیری عمیق در محیطهای تولیدی بهینهسازی شده است. با پشتیبانی از دقتهای متنوع و فناوری Structural Sparsity، این GPU میتواند:
- مدلهای پردازش زبان طبیعی (NLP) مانند BERT را با تاخیر کمتر از 10 میلیثانیه پردازش کند
- شبکههای عصبی بینایی ماشین مانند ResNet-50 را با توان عملیاتی 3 برابر بیشتر از T4 اجرا کند
- چندین مدل مختلف را به طور همزمان با استفاده از MIG سرویسدهی کند
- از NVIDIA Triton Inference Server برای مستقرسازی ساده و مقیاسپذیر استفاده کند
مثال عملی: یک سرویس مکالمهای مبتنی بر هوش مصنوعی که نیاز به پاسخگویی در زمان واقعی دارد، میتواند با استفاده از A30، بیش از 3 برابر تعداد درخواست همزمان را نسبت به نسل قبلی پردازش کند.
آموزش مدلهای یادگیری عمیق
اگرچه A30 بیشتر برای استنتاج طراحی شده، اما با هستههای Tensor نسل سوم و پشتیبانی از دقت TF32، میتواند برای آموزش مدلهای متوسط نیز استفاده شود:
- آموزش مدلهای زبانی مانند BERT با سرعت 3 برابر بیشتر از V100
- پشتیبانی از Mixed Precision برای افزایش 2 برابری عملکرد
- قابلیت مقیاسدهی با NVLink برای آموزش مدلهای بزرگتر
- سازگاری با فریمورکهای محبوب مانند TensorFlow، PyTorch و NVIDIA NGC
محاسبات علمی و شبیهسازی HPC
با بهرهمندی از هستههای Tensor FP64، A30 بزرگترین جهش در عملکرد HPC را از زمان معرفی GPUها ارائه میدهد:
- شبیهسازیهای دینامیک مولکولی با LAMMPS با عملکرد 8 برابر بیشتر از T4
- محاسبات دقیق دوگانه (Double Precision) برای کاربردهای علمی
- مدلسازی آبوهوا، شبیهسازی انرژی و تحلیل ساختاری
- استفاده همزمان برای HPC و AI با قابلیت MIG
تحلیل دادههای حجیم و Data Science
دانشمندان داده میتوانند از A30 برای تحلیل سریع مجموعه دادههای عظیم استفاده کنند:
- شتابدهی Apache Spark با RAPIDS Accelerator
- پردازش و تحلیل دادههای بزرگ در زمان واقعی
- بهرهوری از حافظه 24 گیگابایتی و پهنای باند 933 GB/s
- مقیاسپذیری با InfiniBand و Magnum IO
مقایسه NVIDIA A30 با سایر GPUهای دیتاسنتر
جدول مقایسه با محصولات مشابه
| مدل GPU | حافظه | هسته CUDA | TDP | TF32 TFLOPS | قیمت تقریبی | کاربرد اصلی |
|---|---|---|---|---|---|---|
| A30 | 24GB HBM2 | 3,584 | 165W | 82 (165) | $7,000-$7,600 | استنتاج AI، HPC میانرده |
| A40 | 48GB GDDR6 | 10,752 | 300W | 150 (300) | $8,500-$10,000 | گرافیک، رندرینگ، AI |
| A100 40GB | 40GB HBM2 | 6,912 | 250W | 156 (312) | $10,000-$12,000 | آموزش AI، HPC پیشرفته |
| A100 80GB | 80GB HBM2 | 6,912 | 300W | 156 (312) | $15,000-$18,000 | مدلهای بسیار بزرگ |
| T4 | 16GB GDDR6 | 2,560 | 70W | – | $2,500-$3,500 | استنتاج سبک، Edge |
نکات کلیدی مقایسه:
- A30 تعادل بهینهای بین هزینه و عملکرد برای استنتاج و HPC ارائه میدهد
- با مصرف برق 165 وات، کارآمدتر از A40 و A100 است
- قابلیت MIG آن را برای محیطهای چندکاربره ایدهآل میکند
- نسبت قیمت به عملکرد بهتری نسبت به A100 برای کارهای استنتاج دارد
نحوه استقرار و پیکربندی در دیتاسنتر
الزامات سختافزاری
برای استقرار NVIDIA A30 در زیرساخت دیتاسنتر، موارد زیر ضروری است:
الزامات سرور:
- اسلات PCI Express 4.0 x16 (سازگار با PCIe 3.0 با کاهش پهنای باند)
- منبع تغذیه حداقل 650 وات با کانکتور 8-pin
- سیستم خنککاری مناسب (Passive Cooling نیاز به جریان هوای قوی دارد)
- پشتیبانی از سیستمعاملهای Linux (Ubuntu، RHEL، CentOS)
پیکربندیهای توصیهشده:
- حداقل 32 هسته CPU برای هر A30
- حافظه RAM حداقل 128 گیگابایت
- اتصال شبکه 25GbE یا بالاتر برای کارهای توزیعی
- فضای ذخیرهسازی NVMe برای خواندن سریع داده
راهاندازی MIG و مجازیسازی
یکی از قابلیتهای کلیدی A30، پشتیبانی از مجازیسازی و MIG است:
فعالسازی MIG:
# فعالسازی MIG
nvidia-smi -mig 1
# ایجاد پروفایلهای MIG
nvidia-smi mig -cgi 9,9,9,9 -C
پشتیبانی از پلتفرمهای مجازیسازی:
- NVIDIA AI Enterprise
- NVIDIA Virtual Compute Server (vCS)
- VMware vSphere with Tanzu
- Red Hat OpenShift
- Kubernetes با GPU Operator
این امکان به مدیران IT اجازه میدهد تا منابع GPU را به صورت انعطافپذیر بین کانتینرها، ماشینهای مجازی و کاربران مختلف تقسیم کنند.
قیمت و موجودی در بازار ایران
قیمت NVIDIA A30 Tensor Core GPU در بازار جهانی بین 7,000 تا 7,600 دلار آمریکا متغیر است. این قیمت بسته به سازنده OEM (Dell، HPE، Lenovo، Supermicro) و شرایط بازار ممکن است تغییر کند.
برای دریافت قیمت بهروز و استعلام موجودی این محصول در ایران، با تیم متخصص سوان تک تماس بگیرید. ما به عنوان تامینکننده معتبر زیرساختهای IT و AI، خدمات جامعی شامل مشاوره، تامین، نصب، راهاندازی و پشتیبانی 24/7 ارائه میدهیم.
همچنین میتوانید برای مشاهده سایر محصولات GPU دیتاسنتر، صفحات مرتبط با کارت گرافیک سرور را مطالعه کنید.
بهینهسازی عملکرد و توصیههای بهرهبرداری
استراتژیهای بهینهسازی
برای حداکثر بهرهوری از NVIDIA A30، توصیههای زیر را در نظر بگیرید:
برای استنتاج AI:
- از TensorRT برای بهینهسازی مدلها استفاده کنید
- دقت INT8 یا INT4 را برای کارهای غیرحساس فعال کنید
- از Structural Sparsity برای افزایش 2 برابری سرعت بهره ببرید
- با NVIDIA Triton Server، چندین مدل را همزمان سرویسدهی کنید
برای آموزش AI:
- از Mixed Precision (TF32 + FP16) استفاده کنید
- Batch Size را برای پر کردن حافظه GPU بهینه کنید
- از Data Parallel یا Model Parallel برای مقیاسدهی استفاده کنید
- در صورت داشتن دو A30، از NVLink برای ارتباط سریعتر بهره ببرید
برای HPC:
- از CUDA Toolkit و cuDNN نسخههای جدید استفاده کنید
- کارهای FP64 را با Tensor Cores شتاب دهید
- از MPI و NCCL برای محاسبات توزیعشده بهره ببرید
پشتیبانی نرمافزاری و اکوسیستم
NVIDIA A30 از اکوسیستم گستردهای از نرمافزارها و فریمورکها پشتیبانی میکند:
فریمورکهای یادگیری عمیق:
- TensorFlow و TensorFlow Extended (TFX)
- PyTorch و PyTorch Lightning
- JAX و Flax
- MXNet و Hugging Face Transformers
ابزارهای استنتاج و مستقرسازی:
- NVIDIA TensorRT
- NVIDIA Triton Inference Server
- ONNX Runtime
- TorchServe
پلتفرمهای HPC و تحلیل داده:
- RAPIDS (cuDF، cuML، cuGraph)
- Apache Spark با RAPIDS Accelerator
- Dask
- NVIDIA Magnum IO
ابزارهای مدیریت و مانیتورینگ:
- NVIDIA Data Center GPU Manager (DCGM)
- Kubernetes GPU Operator
- Prometheus و Grafana
- MLflow و Weights & Biases
سوالات متداول درباره NVIDIA A30 Tensor Core GPU
آیا A30 برای رندرینگ گرافیکی مناسب است؟
خیر، NVIDIA A30 یک GPU دیتاسنتر است که برای محاسبات AI و HPC طراحی شده و فاقد هستههای RT (Ray Tracing) است. برای کارهای رندرینگ گرافیکی حرفهای، کارتهای RTX سری A مانند RTX A5500 یا A40 مناسبتر هستند.
تفاوت A30 با A100 چیست و کدام را باید خرید؟
A30 یک GPU میانرده با 3,584 هسته CUDA و 24GB حافظه است، در حالی که A100 یک GPU پرچمدار با 6,912 هسته و حافظه 40 یا 80 گیگابایتی است. A30 برای:
- استنتاج AI در مقیاس متوسط
- HPC با محاسبات FP64 میانرده
- محیطهای چندکاربره با MIG
- بودجههای محدودتر
A100 برای آموزش مدلهای بسیار بزرگ، محاسبات HPC سنگین و کارهایی که به حافظه بیشتر نیاز دارند، مناسبتر است.
آیا میتوان چند A30 را در یک سرور نصب کرد؟
بله، بسته به معماری سرور میتوانید 2، 4 یا حتی 8 A30 را در یک سیستم نصب کنید. برای اتصال دو A30، میتوانید از NVLink Bridge استفاده کنید تا پهنای باند بینGPU را به 200 GB/s برسانید. برای تعداد بیشتر، باید از طریق PCIe یا شبکه (مثلاً InfiniBand) ارتباط برقرار شود.
MIG چگونه کار میکند و چه مزایایی دارد؟
Multi-Instance GPU امکان تقسیم فیزیکی یک A30 به حداکثر 4 پارتیشن مستقل را فراهم میکند. هر پارتیشن دارای:
- منابع محاسباتی اختصاصی (CUDA Cores و Tensor Cores)
- حافظه جدا و قابل تخصیص
- ایزولهسازی سختافزاری کامل
- تضمین QoS بدون تداخل با سایر پارتیشنها
این قابلیت برای ارائهدهندگان خدمات ابری، موسسات تحقیقاتی و شرکتهایی که منابع را بین تیمهای مختلف تقسیم میکنند، بسیار مفید است.
چقدر طول میکشد تا A30 منسوخ شود؟
با توجه به معماری Ampere و پشتیبانی قوی NVIDIA از محصولات دیتاسنتر، انتظار میرود A30 حداقل تا 5-7 سال آینده برای بیشتر کارهای استنتاج و HPC میانرده مناسب باقی بماند. NVIDIA معمولاً برای محصولات دیتاسنتر خود پشتیبانی نرمافزاری طولانیمدت (10+ سال) ارائه میدهد.
آیا A30 با کانتینرها و Kubernetes سازگار است؟
بله، A30 به طور کامل با اکوسیستم کانتینرها سازگار است:
- پشتیبانی کامل از Docker و containerd
- سازگاری با Kubernetes و GPU Operator
- قابلیت استفاده از MIG در Kubernetes برای تخصیص ریزدانه منابع
- پشتیبانی از Helm Charts برای نصب ساده
- سازگاری با OpenShift، Rancher و سایر پلتفرمهای مدیریت کانتینر
مصرف برق و هزینههای عملیاتی چقدر است؟
A30 با TDP 165 وات، یکی از کارآمدترین GPUهای دیتاسنتر در دسته خود است. برای محاسبه هزینه برق:
- مصرف: 165 وات (در بار کامل)
- در سال (24/7): حدود 1,446 کیلوواتساعت
- با نرخ برق صنعتی ایران: هزینهای بسیار کمتر از GPUهای قدرتمندتر مانند A100
همچنین کارایی انرژی بالا باعث کاهش نیاز به خنککاری و در نتیجه کاهش هزینههای عملیاتی دیتاسنتر میشود.
نتیجهگیری: آیا NVIDIA A30 انتخاب مناسبی برای سازمان شماست؟
پردازنده گرافیکی NVIDIA A30 Tensor Core یک انتخاب استراتژیک برای سازمانهایی است که به دنبال تعادل بهینه میان هزینه، عملکرد و انعطافپذیری در زیرساخت محاسباتی خود هستند. با ویژگیهای منحصربهفرد مانند Multi-Instance GPU، هستههای Tensor نسل سوم و حافظه HBM2 گسترده، این GPU میتواند نیازهای متنوعی از استنتاج هوش مصنوعی تا محاسبات علمی را پاسخ دهد.
اگر شما مدیر IT، معمار زیرساخت یا متخصص یادگیری ماشین هستید که به دنبال راهحلی کارآمد برای:
- استقرار سرویسهای هوش مصنوعی در مقیاس سازمانی
- اجرای شبیهسازیهای علمی پیچیده
- بهینهسازی بهرهوری از منابع محاسباتی با MIG
- کاهش هزینههای عملیاتی دیتاسنتر
NVIDIA A30 گزینهای است که باید جدی در نظر بگیرید.
برای مشاوره تخصصی، دریافت قیمت بهروز و طراحی زیرساخت مناسب با نیازهای سازمان شما، همین حالا با تیم متخصصان سوان تک تماس بگیرید. ما با سالها تجربه در تامین و اجرای زیرساختهای IT و AI، آماده ارائه خدمات جامع از مشاوره تا پشتیبانی مستمر هستیم.
محصولات مرتبط

نقد و بررسیها
پاککردن فیلترهاهنوز بررسیای ثبت نشده است.