
مقالات و اخبار تکنولوژی
راهنمای کامل NVIDIA T4 : بهترین GPU برای Inference


- نویسنده: کارشناس ارشد زیرساخت پردازش ابری (Cloud) در سوان تک
- بازبینی فنی: مهندس ارشد سختافزار سرور و دیتاسنتر
- مرجع اصلی: مستندات فنی و وایتپیپرهای رسمی NVIDIA Turing Architecture
- آخرین بروزرسانی: 12 دی 1404
- زمان مطالعه: حدود ۸ دقیقه
خلاصه سریع: چرا NVIDIA T4 انتخاب هوشمندانهای است؟
کارت گرافیک NVIDIA Tesla T4 یک پردازنده کممصرف (۷۰ وات) و قدرتمند مبتنی بر معماری Turing است که بهطور خاص برای استنتاج هوش مصنوعی (AI Inference) و تحلیل داده در لبه شبکه (Edge) طراحی شده است. این کارت با داشتن ۲۵۶۰ هسته CUDA و ۳۲۰ هسته Tensor، تعادلی بینظیر میان هزینه، مصرف انرژی و کارایی ایجاد میکند و میتواند مدلهای سنگین یادگیری عمیق، پردازش تصویر و پردازش زبان طبیعی را با سرعت بالا اجرا کند.
برخلاف کارتهای گرانقیمتتر مانند A100 که برای آموزش مدلهای عظیم (Training) ساخته شدهاند، T4 گزینهای ایدهآل و اقتصادی برای شرکتهایی است که میخواهند مدلهای هوش مصنوعی خود را در مقیاس وسیع به کاربران نهایی ارائه دهند. پشتیبانی از مجازیسازی، ابعاد کوچک (Single Slot) و سازگاری با اکثر سرورهای استاندارد، T4 را به محبوبترین گزینه برای مراکز داده و پروژههای هوش مصنوعی تجاری تبدیل کرده است.
راهنمای کامل NVIDIA T4
در عصر هوش مصنوعی و یادگیری عمیق، انتخاب GPU مناسب برای استنتاج (Inference) یکی از مهمترین تصمیمات در طراحی زیرساختهای محاسباتی است. NVIDIA T4 به عنوان یکی از محبوبترین و مقرونبهصرفهترین گزینههای موجود در بازار، توجه بسیاری از سازمانها و شرکتهایی که به دنبال پیادهسازی راهکارهای هوش مصنوعی هستند را به خود جلب کرده است.
سوان تک در این مقاله جامع، به بررسی کامل مشخصات، قابلیتها، کاربردها و مقایسه NVIDIA T4 با سایر گزینههای موجود در بازار میپردازد. همچنین سناریوهای مختلف استقرار، تحلیل هزینهها و نحوه بهینهسازی عملکرد این GPU قدرتمند را مورد بحث قرار خواهیم داد.
راهنمای کامل NVIDIA T4 و مشخصات فنی
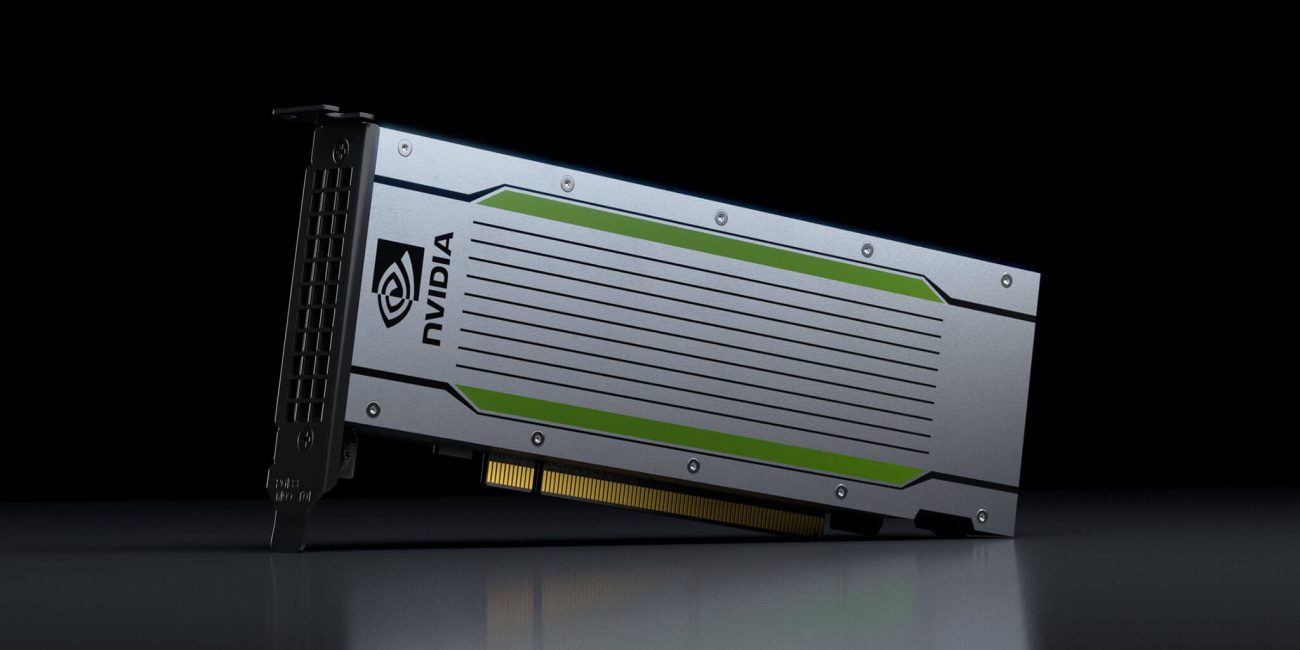
NVIDIA Tesla T4 یکی از پردازندههای گرافیکی متعلق به خانواده Turing است که به طور خاص برای کارهای استنتاج هوش مصنوعی، یادگیری عمیق و محاسبات edge طراحی شده است. این GPU در سال ۲۰۱۸ معرفی شد و تا به امروز یکی از محبوبترین انتخابها برای راهکارهای هوش مصنوعی در مراکز داده و سرورهای enterprise محسوب میشود.
مشخصات فنی کامل NVIDIA T4
| مشخصات | مقدار |
|---|---|
| معماری | Turing |
| فرآیند ساخت | 12 نانومتر |
| حافظه | 16 گیگابایت GDDR6 |
| پهنای باند حافظه | 300 GB/s |
| هستههای CUDA | 2560 |
| هستههای RT | 40 (نسل دوم) |
| هستههای Tensor | 320 (نسل دوم) |
| مصرف برق | 70 وات |
| فرم فکتور | Single Slot, Low Profile |
| رابط | PCIe 3.0 x16 |
| خروجی تصویر | بدون خروجی مستقیم |
| پشتیبانی از تعدد کاربری | تا 8 کاربر همزمان |
- عملکرد FP32
8.1 TFLOPS
- عملکرد FP16
65 TFLOPS
- عملکرد INT8
130 TOPS
- عملکرد INT4
260 TOPS
معماری Turing و نوآوریهای کلیدی
معماری Turing که در پایه طراحی NVIDIA T4 قرار دارد، نسبت به نسلهای قبلی تحولات قابل توجهی داشته است. این معماری شامل سه نوع هسته مختلف است:
- هستههای CUDA: برای محاسبات عمومی و پردازشهای موازی
- هستههای RT: برای پردازش تصاویر ray tracing و رندرینگ پیشرفته
- هستههای Tensor: برای تسریع عملیات یادگیری عمیق و هوش مصنوعی
ترکیب این سه نوع هسته، امکان پردازش بهینه انواع مختلف workloadها را فراهم میکند و باعث میشود که T4 برای کاربردهای مختلف از جمله سرورهای GPU مناسب باشد.
مزایا و کاربردهای T4 در Inference
🚀 مشاور هوشمند سختافزار هوش مصنوعی
به ۳ سوال کوتاه پاسخ بده تا بهترین GPU رو بهت پیشنهاد بدیم!
NVIDIA T4 به دلیل ویژگیهای منحصر به فرد خود، به عنوان یکی از بهترین گزینهها برای کارهای استنتاج هوش مصنوعی شناخته میشود. در ادامه به بررسی مهمترین مزایا و کاربردهای این GPU میپردازیم.
مزایای کلیدی NVIDIA T4
بهرهوری انرژی بالا
یکی از مهمترین مزایای T4، مصرف برق کم آن است. با مصرف تنها 70 وات، این GPU قابلیت ارائه عملکرد بالا در استنتاج را دارد که آن را به انتخابی ایدهآل برای مراکز داده با محدودیتهای برق و خنکسازی تبدیل میکند.
- مقرونبهصرفه بودن: نسبت قیمت به عملکرد عالی برای کارهای inference
- انعطافپذیری بالا: پشتیبانی از انواع مختلف فریمورکهای یادگیری عمیق
- قابلیت مجازیسازی: امکان تقسیم منابع بین چندین کاربر به صورت همزمان
- پشتیبانی از Tensor RT: بهینهسازی خودکار مدلها برای افزایش سرعت استنتاج
- پشتیبانی از Mixed Precision: استفاده از انواع مختلف دقت محاسباتی برای بهینهسازی
- فرم فکتور کوچک: اشغال فضای کمتر در rack های سرور
کاربردهای اصلی NVIDIA T4
پردازش زبان طبیعی (NLP)
T4 برای اجرای مدلهای پیشرفته NLP مانند BERT، GPT و Transformer بسیار مناسب است. قابلیت پردازش متنهای طولانی و پاسخگویی سریع به درخواستها از جمله قابلیتهای برجسته آن در این حوزه است.
بینایی کامپیوتری
در کاربردهای تشخیص تصویر، تحلیل ویدئو، تشخیص اشیاء و پردازش تصاویر پزشکی، T4 عملکرد فوقالعادهای ارائه میدهد. هستههای Tensor موجود در آن، سرعت پردازش مدلهای CNN و ResNet را به طور قابل توجهی افزایش میدهند.
سیستمهای توصیهگر
برای پلتفرمهای تجارت الکترونیک، سرویسهای پخش آنلاین و شبکههای اجتماعی که نیاز به پردازش سریع دادههای کاربران و ارائه توصیههای شخصیسازی شده دارند، T4 گزینهای مناسب است.
خدمات مکالمهای و چت بات
پیادهسازی chatbot های پیشرفته، دستیارهای صوتی و سیستمهای پردازش گفتار از دیگر کاربردهای مهم T4 محسوب میشود. قابلیت پردازش real-time و پاسخگویی سریع از ویژگیهای کلیدی آن است.
مقایسه کامل: T4 vs L4 vs L40S
برای انتخاب بهترین GPU برای نیازهای خاص شما، مقایسه دقیق مشخصات و عملکرد مدلهای مختلف ضروری است. در ادامه مقایسه جامعی بین سه مدل محبوب NVIDIA ارائه میدهیم:
| مشخصات | NVIDIA T4 | NVIDIA L4 | NVIDIA L40S |
|---|---|---|---|
| معماری | Turing | Ada Lovelace | Ada Lovelace |
| فرآیند ساخت | 12nm | 5nm | 5nm |
| حافظه | 16GB GDDR6 | 24GB GDDR6 | 48GB GDDR6 |
| پهنای باند حافظه | 300 GB/s | 300 GB/s | 864 GB/s |
| هستههای CUDA | 2,560 | 7,424 | 18,176 |
| هستههای RT | 40 (Gen 2) | 58 (Gen 3) | 142 (Gen 3) |
| هستههای Tensor | 320 (Gen 2) | 232 (Gen 4) | 568 (Gen 4) |
| مصرف برق | 70W | 72W | 350W |
| عملکرد FP32 | 8.1 TFLOPS | 30.3 TFLOPS | 91.6 TFLOPS |
| عملکرد Tensor (FP16) | 65 TFLOPS | 242 TFLOPS | 733 TFLOPS |
| عملکرد INT8 | 130 TOPS | 485 TOPS | 1466 TOPS |
| قیمت تقریبی (USD) | $2,000-2,500 | $3,000-4,000 | $12,000-15,000 |
| نسبت عملکرد/قیمت | عالی | خوب | متوسط |
تحلیل مقایسهای
NVIDIA T4: بهترین انتخاب برای کاربردهای inference با بودجه محدود و نیاز به بهرهوری انرژی بالا. نسبت عملکرد به قیمت فوقالعاده و مناسب برای پروژههای کوچک تا متوسط.
NVIDIA L4: جایگزین مدرن T4 با عملکرد بهتر و معماری جدیدتر. مناسب برای کاربردهایی که نیاز به حافظه بیشتر و عملکرد بالاتر دارند اما همچنان بهرهوری انرژی مهم است.
NVIDIA L40S: گزینه high-end برای کاربردهای سنگین و enterprise که نیاز به بالاترین عملکرد ممکن دارند. مصرف برق بالا و قیمت گران اما عملکرد بینظیر.
سناریوهای استقرار (Deployment Scenarios)
NVIDIA T4 به دلیل انعطافپذیری و مقرونبهصرفه بودن، در سناریوهای مختلف استقرار قابل استفاده است. در ادامه به بررسی مهمترین سناریوها میپردازیم:
۱. مراکز داده بزرگ (Enterprise Data Centers)
مشخصات استقرار
- تعداد GPU: 4-8 کارت در هر سرور
- حافظه کل: 64-128 گیگابایت
- کاربرد: پردازش درخواستهای متعدد به صورت همزمان
- مزایا: مقرونبهصرفه، قابلیت مقیاسپذیری بالا
در این سناریو، سرورهای مخصوص با قابلیت نصب چندین کارت T4 استفاده میشود تا بتوان حجم بالایی از درخواستهای inference را پردازش کرد.
۲. Edge Computing و محاسبات لبه
مشخصات استقرار
- تعداد GPU: 1-2 کارت
- مصرف برق: کمتر از 150 وات
- کاربرد: پردازش real-time در محل
- مزایا: تأخیر کم، کاهش ترافیک شبکه
برای کاربردهای IoT، دوربینهای هوشمند، خودروهای خودران و سیستمهای نظارت، T4 گزینهای مناسب برای پردازش محلی دادهها محسوب میشود.
۳. سرویسهای ابری (Cloud Services)
مشخصات استقرار
- مدل سرویس: GPU-as-a-Service
- قابلیت مجازیسازی: تا 8 کاربر همزمان
- کاربرد: ارائه خدمات AI به صورت آنلاین
- مزایا: انعطافپذیری، هزینه متغیر
ارائهدهندگان خدمات ابری میتوانند از T4 برای ارائه سرویسهای هوش مصنوعی به مشتریان خود استفاده کنند.
۴. محیطهای آزمایشگاهی و تحقیقاتی
مشخصات استقرار
- کاربرد: آزمایش و توسعه مدلهای جدید
- مزیت: هزینه کم، قابلیت اشتراکگذاری
- محیط: دانشگاهها، مراکز تحقیقاتی
- نرمافزار: Jupyter, Docker, Kubernetes
برای محققان و دانشجویانی که در حال توسعه و آزمایش مدلهای جدید هوش مصنوعی هستند، T4 امکان دسترسی به قدرت محاسباتی GPU را با هزینهای مناسب فراهم میکند.
تحلیل هزینه به ازای هر Inference
یکی از مهمترین معیارهای انتخاب GPU برای کاربردهای تجاری، محاسبه هزینه به ازای هر عملیات استنتاج (Cost-per-inference) است. در ادامه تحلیل دقیقی از این شاخص برای NVIDIA T4 ارائه میدهیم:
مؤلفههای هزینه
هزینههای اولیه (CAPEX)
- قیمت GPU: 2,000-2,500 دلار
- هزینه سرور: 3,000-5,000 دلار (بدون GPU)
- زیرساخت شبکه: 500-1,000 دلار
- سیستم خنکسازی: 200-500 دلار
هزینههای عملیاتی (OPEX)
- برق مصرفی: 70 وات × 24 ساعت × 365 روز = 613 کیلووات ساعت سالانه
- هزینه برق: با فرض 0.1 دلار بر کیلووات ساعت = 61 دلار سالانه
- خنکسازی: حدود 30 دلار سالانه
- نگهداری: 100-200 دلار سالانه
محاسبه Cost-per-inference
| نوع مدل | Inference/sec | Cost per 1M Inference | مقایسه با CPU |
|---|---|---|---|
| BERT Base | 400-500 | $0.05-0.08 | 20x سریعتر |
| ResNet-50 | 1,200-1,500 | $0.02-0.03 | 15x سریعتر |
| LSTM Language Model | 800-1,000 | $0.03-0.04 | 25x سریعتر |
| YOLOv5 | 300-400 | $0.08-0.12 | 18x سریعتر |
نکته مهم: با استفاده از تکنیکهای بهینهسازی مانند TensorRT، Quantization و Mixed Precision، میتوان هزینه per-inference را تا 50% کاهش داد.
مقایسه هزینه با راهحلهای جایگزین
CPU Intel Xeon
$0.5-1.2 per 1M inference
NVIDIA T4
$0.02-0.12 per 1M inference
Cloud API Services
$2-10 per 1M inference
NVIDIA A100
$0.01-0.05 per 1M inference
نکات بهینهسازی هزینه
- استفاده از Batch Processing: افزایش اندازه batch تا 64 یا 128 میتواند throughput را تا 3 برابر افزایش دهد
- Dynamic Batching: ترکیب درخواستهای مختلف برای استفاده بهینه از منابع
- Model Optimization: استفاده از TensorRT برای کاهش 40-60% زمان inference
- Mixed Precision: استفاده از FP16 به جای FP32 برای افزایش 2x سرعت
- Multi-Instance GPU: تقسیم منابع بین چندین مدل برای افزایش utilization
بهینهسازی عملکرد و نکات عملی
برای دستیابی به بهترین عملکرد از NVIDIA T4، رعایت نکات و تکنیکهای بهینهسازی ضروری است. در ادامه به مهمترین این موارد اشاره میکنیم:
تنظیمات نرمافزاری
CUDA Driver و Runtime
استفاده از آخرین نسخه CUDA Driver (حداقل 11.0) و CUDA Runtime برای بهرهمندی از جدیدترین بهینهسازیها ضروری است. همچنین تنظیم صحیح متغیرهای محیطی مانند CUDA_VISIBLE_DEVICES از اهمیت ویژهای برخوردار است.
استراتژیهای Deployment
برای استقرار موفق سیستمهای مبتنی بر T4، انتخاب استراتژی مناسب deployment بسیار مهم است. خدمات یکپارچهسازی سیستم سوان تک میتواند در این زمینه کمک شایانی به شما ارائه دهد.
سوالات متداول (FAQ)
آیا NVIDIA T4 برای training مدلهای یادگیری عمیق مناسب است؟
NVIDIA T4 به طور اصلی برای inference طراحی شده است. برای training مدلهای بزرگ، GPU های دیگری مانند A100 یا V100 توصیه میشود. اما برای training مدلهای کوچک تا متوسط، T4 میتواند مفید باشد.
چند کاربر میتوانند به طور همزمان از یک کارت T4 استفاده کنند؟
با استفاده از تکنولوژی NVIDIA MIG و vGPU، میتوان تا 8 کاربر را به طور همزمان بر روی یک کارت T4 اجرا کرد. این قابلیت برای محیطهای multi-tenant بسیار مفید است.
مصرف برق T4 در مقایسه با سایر GPU ها چگونه است؟
T4 با مصرف 70 وات، یکی از کممصرفترین GPU های حرفهای محسوب میشود. این مقدار در مقایسه با A100 (400W) یا V100 (300W) بسیار کمتر است و آن را برای data center های با محدودیت برق مناسب میکند.
آیا T4 از Docker و Kubernetes پشتیبانی میکند؟
بله، T4 به طور کامل از containerization با Docker و orchestration با Kubernetes پشتیبانی میکند. NVIDIA Container Runtime و NVIDIA Device Plugin برای Kubernetes امکان استفاده آسان از GPU در محیطهای containerized را فراهم میکند.
بهترین فریمورکهای یادگیری عمیق برای T4 کدامند؟
T4 از تمامی فریمورکهای محبوب شامل TensorFlow، PyTorch، ONNX Runtime، TensorRT و Rapids پشتیبانی میکند. TensorRT برای بهینهسازی inference و کاهش latency به شدت توصیه میشود.
T4 در برابر خرابی و مشکلات سختافزاری چه مقاومتی دارد؟
T4 با استانداردهای enterprise طراحی شده و دارای قابلیتهای ECC memory، thermal protection و error detection است. متوسط عمر مفید آن بیش از 5 سال در شرایط عادی کاری تخمین زده میشود.
آیا امکان upgrade از T4 به GPU های جدیدتر وجود دارد؟
بله، از آنجا که T4 از رابط استاندارد PCIe استفاده میکند، امکان upgrade به GPU های جدیدتر مانند L4 یا A100 (با توجه به محدودیتهای برق و فضا) وجود دارد. اما توصیه میشود قبل از upgrade، compatibility سرور را بررسی کنید.
آماده برای شروع با NVIDIA T4؟
تیم متخصص سوان تک آماده ارائه مشاوره تخصصی، طراحی راهحل مناسب و ارائه بهترین قیمت برای NVIDIA T4 و سایر محصولات GPU است. با بیش از 10 سال تجربه در حوزه راهحلهای محاسباتی پیشرفته، ما بهترین خدمات را به شما ارائه میدهیم.
نظرات کاربران:
۱. مهدی راد – مدیر فنی استارتاپ هوش مصنوعی “ما برای سرویس تبدیل متن به گفتارمون (TTS) اول رفتیم سراغ A100 ولی هزینهش برای اسکیل کردن وحشتناک بود. با مشاوره سوان تک سوییچ کردیم روی کلاستر T4. الان همون پرفورمنس رو داریم میگیریم ولی هزینهمون تقریبا یکسوم شده. برای Inference واقعا T4 هنوز پادشاهه.”
۲. سارا کیانی – محقق دیتاساینس “نکتهای که توی مقاله درباره Mixed Precision گفتید خیلی دقیقه. من روی پروژهی تشخیص چهره شرکتمون وقتی مدلم رو با TensorRT روی T4 بهینه کردم و بردم روی دقت INT8، سرعت پردازش تقریبا ۳ برابر شد بدون اینکه دقت مدل افت محسوسی کنه.”
۳. امیرحسین جلیلی – ادمین سرور “به عنوان کسی که توی دیتاسنتر کار میکنه، بزرگترین مزیت T4 برام مصرف برق و خنککنندگیش هست. اینکه نیاز به کابل برق جداگانه نداره و فقط از اسلات PCIe تغذیه میشه (۷۰ وات)، کار ما رو برای اضافه کردن کارت به سرورهای قدیمیتر خیلی راحت کرده.”