
مقالات و اخبار تکنولوژی
راهاندازی سرور هوش مصنوعی: از برق و سرمایش تا اجرای اولین مدل زبانی


خرید سرور هوش مصنوعی تمام شد، سرور رسید و حالا در اتاق سرور منتظر است. از اینجا به بعد، سؤال اصلی دیگر «چه بخریم» نیست، بلکه این است: «چطور این دستگاه چند میلیاردی را طوری راه بیندازیم که از هفتهٔ اول واقعاً کار کند؟» تجربهٔ ما در سوانتک نشان میدهد که خیلی از پروژهها نه بهخاطر سختافزار، بلکه بهخاطر یک برق ناپایدار، یک درایور ناسازگار یا مدلی که بهخاطر تحریم دانلود نمیشود، هفتهها عقب میافتند.
این راهنما مراحل راهاندازی سرور هوش مصنوعی را از آمادهسازی محل نصب تا بالا آوردن اولین مدل زبانی و سرویسدهی به کاربران، با در نظر گرفتن شرایط واقعی ایران توضیح میدهد. اگر هنوز در مرحلهٔ انتخاب سرور هستید، اول راهنمای جامع انتخاب سرور هوش مصنوعی را بخوانید.
مرحلهٔ ۱: آمادهسازی محل نصب، قبل از رسیدن سرور
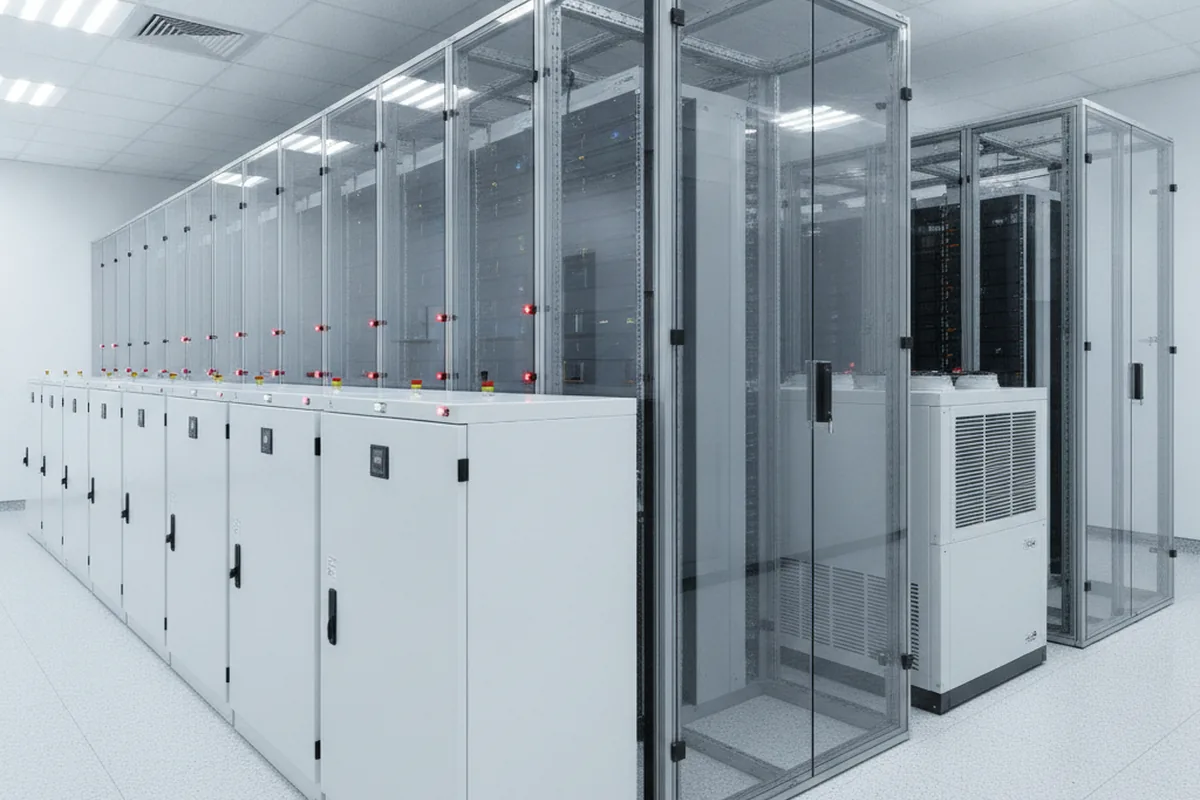
بیشترِ مشکلات روز تحویل، از هفتهها قبل قابل پیشبینی بودند. قبل از اینکه سرور برسد، این موارد را بررسی کنید:
برق
یک سرور با ۴ کارت H100 بین ۳ تا ۵ کیلووات و یک سرور HGX با ۸ GPU تا حدود ۱۰ کیلووات برق میکشد. این یعنی:
- رک باید PDU با ظرفیت کافی داشته باشد و سرور از دو مسیر برق جدا تغذیه شود تا با خرابی یک پاور یا یک مسیر، از کار نیفتد.
- UPS باید توان کامل سرور را حداقل برای چند دقیقه نگه دارد تا یا ژنراتور وارد مدار شود یا سرور بهشکل کنترلشده خاموش شود.
- با توجه به محدودیتها و قطعیهای برنامهریزیشدهٔ برق در تابستان، بهخصوص برای واحدهای صنعتی، ژنراتور یا قرارداد با دیتاسنتری که برق پشتیبان دارد تقریباً ضروری است. خاموشی ناگهانی وسط یک آموزش چندروزه، یعنی از دست رفتن روزها کار.
خنککاری
تقریباً همهٔ برقی که سرور مصرف میکند به گرما تبدیل میشود. ۱۰ کیلووات برق یعنی ۱۰ کیلووات گرما در یک رک. کولرهای گازی معمولی اتاق سرور برای این حجم طراحی نشدهاند. دمای هوای ورودی جلوی سرور را زیر ۲۷ درجه نگه دارید و راهروی سرد و گرم را از هم جدا کنید. اگر اتاق سرور شما برای سرورهای معمولی ساخته شده، احتمالاً برای سرور GPU نیاز به ارتقای سرمایش دارید.
فضا و وزن
سرورهای HGX ارتفاع ۶ تا ۸ یونیت دارند و وزنشان به ۷۰ تا ۱۳۰ کیلوگرم میرسد. ریل مناسب، عمق کافی رک و حتی ظرفیت تحمل کف اتاق را بررسی کنید.
اگر محل مناسب ندارید، هممکانی (Colocation) در یکی از دیتاسنترهای داخلی که برق پشتیبان و سرمایش استاندارد دارند، اغلب از ساختن اتاق سرور جدید ارزانتر و سریعتر است.
مرحلهٔ ۲: تحویل و بررسی سختافزار
روز تحویل، قبل از امضای صورتجلسه، این کارها را انجام دهید:
- بستهٔ سرور را از نظر آسیب حمل بررسی کنید و شمارهٔ سریالها را با پیشفاکتور تطبیق دهید.
- سرور را روشن کنید و وارد کنسول مدیریتی (iDRAC، iLO، XClarity یا BMC برند مربوط) شوید. همهٔ پاورها، فنها و دماها باید سالم نشان داده شوند.
- بعد از نصب درایور، با دستور
nvidia-smiتعداد، مدل دقیق و حافظهٔ هر GPU را ببینید. مدل باید دقیقاً همان چیزی باشد که در پیشفاکتور آمده؛ مثلاً H100 PCIe با ۸۰ گیگ، نه نسخهای دیگر. - یک تست فشار چندساعته (مثلاً با gpu-burn یا DCGM diagnostics) اجرا کنید تا مطمئن شوید هیچ کارتی زیر بار داغ نمیکند یا خطای حافظه نمیدهد. این تست را حتماً در دورهٔ گارانتی و ترجیحاً همان هفتهٔ اول انجام دهید.
مرحلهٔ ۳: سیستمعامل و درایور
برای سرورهای هوش مصنوعی، رایجترین انتخاب Ubuntu Server نسخهٔ LTS است، چون بیشترِ ابزارهای هوش مصنوعی اول روی آن تست میشوند. Rocky Linux یا RHEL هم برای سازمانهایی که استاندارد داخلیشان RedHat است گزینهٔ مناسبی است.
ترتیب نصب مهم است:
- نصب سیستمعامل و بهروزرسانی هستهٔ لینوکس.
- نصب درایور NVIDIA با نسخهای که با کارتهای شما و نسخهٔ CUDA مورد نیازتان سازگار باشد. نسخههای خیلی جدید درایور گاهی با ابزارهای قدیمیتر ناسازگارند و نسخههای خیلی قدیمی از کارتهای نسل جدید پشتیبانی نمیکنند.
- نصب CUDA Toolkit و cuDNN.
- برای سرورهای HGX و DGX، نصب Fabric Manager که ارتباط NVLink بین GPUها را مدیریت میکند. بدون این سرویس، کارتها روی سرورهای SXM درست با هم کار نمیکنند.
- نصب Docker و NVIDIA Container Toolkit تا بتوانید هر پروژه را در کانتینر جدا اجرا کنید.
مرحلهٔ ۴: دور زدن محدودیت دانلود، بخش ایرانی ماجرا
اینجا جایی است که راهاندازی سرور در ایران با هر جای دیگر دنیا فرق میکند. بسیاری از منابعی که برای راهاندازی لازم دارید، یا به آیپی ایران پاسخ نمیدهند یا با اینترنت بینالملل محدود، خیلی کند دانلود میشوند:
- مخزنهای Docker: Docker Hub و بعضی رجیستریهای دیگر برای آیپی ایران محدودیت دارند. تیمهای ایرانی معمولاً از آینههای داخلی رجیستری Docker استفاده میکنند که چند شرکت ابری و هاستینگ داخلی ارائه میدهند، یا یک رجیستری خصوصی (مثل Harbor) داخل سازمان راه میاندازند و ایمیجها را یکبار وارد آن میکنند.
- بستههای پایتون: برای pip هم آینههای داخلی وجود دارد. در شبکههای بستهتر، یک مخزن داخلی (مثلاً با Nexus یا devpi) ساخته میشود.
- مدلها: دانلود مدلهای دهها و صدها گیگابایتی از سرویسهای خارجی، بزرگترین گلوگاه است. راه عملی این است که مدلها یکبار از طریق مسیر مطمئن تهیه شوند و روی استوریج داخلی سازمان نگهداری شوند تا هر بار از بیرون دانلود نشوند.
- کاتالوگ NGC انویدیا: ایمیجهای بهینهشدهٔ NVIDIA هم برای کاربران ایرانی محدودیت دارد؛ نسخههای مورد نیاز را قبل از تحویل سرور آماده کنید.
یک توصیهٔ مهم: هیچوقت ایمیج یا مدلی را از منبع ناشناس، فقط چون «دانلودش راحت بود»، روی سرور سازمانی اجرا نکنید. ایمیجهای آلوده و مدلهای دستکاریشده ریسک امنیتی جدی دارند. در سوانتک، سرورها را با سیستمعامل، درایور، CUDA، Docker و ایمیجهای پایهٔ تستشده تحویل میدهیم تا تیم شما از روز اول درگیر این مسیر نشود.
مرحلهٔ ۵: بالا آوردن اولین مدل زبانی
رایجترین پروژهٔ اول در سازمانهای ایرانی، یک دستیار یا چتبات داخلی روی یک مدل متنباز است. انتخاب ابزار سرویسدهی به تعداد کاربر بستگی دارد:
- Ollama یا llama.cpp: سادهترین شروع برای آزمایش و تیمهای کوچک. نصب سریع، پشتیبانی خوب از مدلهای کوانتیزهشده و مصرف حافظهٔ کمتر.
- vLLM: انتخاب استاندارد برای سرویسدهی به دهها و صدها کاربر همزمان. مدیریت حافظهٔ بسیار بهتر و توان عملیاتی چند برابر.
- NVIDIA Triton و TensorRT-LLM: برای بیشترین کارایی روی کارتهای NVIDIA، با پیچیدگی راهاندازی بیشتر.
برای زبان فارسی، مدلهای چندزبانهٔ جدید مثل خانوادهٔ Qwen، Llama و Gemma عملکرد قابل قبولی دارند، ولی کیفیتشان روی متنهای تخصصی فارسی، مثل مکاتبات اداری یا اصطلاحات حقوقی، متفاوت است. قبل از انتخاب نهایی، چند مدل را روی نمونهٔ واقعی سؤالهای سازمان خودتان تست کنید، نه روی بنچمارکهای انگلیسی.
اگر میخواهید مصرف حافظه و برق را پایین نگه دارید، کوانتیزهسازی ۴ یا ۸ بیتی معمولاً بهترین تعادل بین کیفیت و هزینه را میدهد. برای مقایسهٔ عملی حافظهٔ کارتها روی مدلهای فارسی، مقالهٔ A100 40GB در برابر 80GB روی LLM فارسی را ببینید.
رابط کاربری برای کارمندان؛ مدل را قابل استفاده کنید
مدلی که فقط از طریق خط فرمان در دسترس باشد، به درد کارمندان سازمان نمیخورد. ابزارهای متنبازی مثل Open WebUI یک رابط چت شبیه ChatGPT روی سرور خودتان میسازند: ورود با حساب کاربری، تاریخچهی گفتوگو، بارگذاری فایل و انتخاب مدل. با اتصال این رابط به سرویس مدل (مثل Ollama یا vLLM) و به پایگاه دانش سازمان، کارمندان بدون هیچ دانش فنی میتوانند از دستیار هوش مصنوعی داخلی استفاده کنند، در حالی که هیچ دادهای از سازمان خارج نمیشود.
اتصال به اتوماسیون؛ از چت تا انجام کار
بعد از چتبات، قدم بعدی اتصال مدل به فرایندهای سازمان است. ابزارهای اتوماسیون گردش کار مثل n8n که روی سرور خودتان نصب میشوند، میتوانند مدل محلی را به ایمیل، فرمها، پیامرسانها، CRM و پایگاه داده وصل کنند؛ مثلاً خلاصه کردن خودکار ایمیلهای ورودی، دستهبندی درخواستهای مشتری، استخراج اطلاعات از فاکتورها یا تهیهی گزارش روزانه. ترکیب n8n با مدل محلی، یکی از محبوبترین راههای پیادهسازی هوش مصنوعی در سازمانهای ایرانی است، چون هم هزینهی اشتراک ماهانه ندارد و هم داده داخل سازمان میماند.
سرور هوش مصنوعی کوچک برای تیمها و دفترها
همهی پروژهها از ابتدا به سرور چند GPU نیاز ندارند. برای تیمهای کوچک، آزمایش ایده یا یک دستیار داخلی با تعداد کاربر محدود، یک ورکاستیشن با یک کارت ۴۸ یا ۹۶ گیگی، یا دستگاههای رومیزی جمعوجوری مثل NVIDIA DGX Spark، نقطهی شروع مناسبی است. همین مراحل راهاندازی، از نصب درایور تا Ollama و رابط کاربری، روی این سیستمها هم اجرا میشود و وقتی تقاضا بیشتر شد، میتوانید همان پیکربندی را روی سرور بزرگتر منتقل کنید.
مرحلهٔ ۶: اتصال به دادهٔ سازمان (RAG)
یک مدل زبانی خام دربارهٔ آییننامهها، محصولات و فرایندهای سازمان شما چیزی نمیداند. روش رایج برای حل این مشکل، RAG است: اسناد سازمان تکهتکه و به بردار تبدیل میشوند، در یک پایگاه دادهٔ برداری (مثل Qdrant، Milvus یا pgvector) ذخیره میشوند، و هر سؤال کاربر اول در این اسناد جستوجو میشود و بعد مدل با کمک همان تکهها جواب میدهد.
چند نکتهٔ عملی برای اسناد فارسی:
- اسناد اسکنشده را اول با OCR مناسب فارسی به متن تبدیل کنید؛ کیفیت OCR مستقیم روی کیفیت جوابها اثر دارد.
- ی و ک عربی و فارسی، نیمفاصله و اعداد فارسی و انگلیسی را قبل از ساخت بردارها یکسانسازی کنید. در غیر این صورت جستوجو بخشی از اسناد را پیدا نمیکند.
- مدل embedding را طوری انتخاب کنید که از فارسی پشتیبانی خوبی داشته باشد.
- سطح دسترسی را رعایت کنید: کاربری که به یک سند دسترسی ندارد، نباید از طریق چتبات به محتوای آن برسد.
مرحلهٔ ۷: امنیت و دسترسی
سرور هوش مصنوعی معمولاً به حساسترین دادههای سازمان دسترسی دارد. پس:
- سرور را در شبکهٔ داخلی نگه دارید و دسترسی مستقیم از اینترنت را ببندید.
- کنسول مدیریتی سرور (BMC) را در یک شبکهٔ مدیریتی جدا قرار دهید و رمز پیشفرض آن را عوض کنید.
- برای کاربران، احراز هویت مرکزی (مثلاً اتصال به Active Directory) و ثبت لاگ سؤالها را فعال کنید.
- بهروزرسانیهای امنیتی سیستمعامل و درایور را برنامهریزیشده انجام دهید، نه در وسط ساعت کاری.
مرحلهٔ ۸: پایش و نگهداری
سرور GPU را نمیشود راه انداخت و فراموش کرد. حداقل این موارد را پایش کنید:
- دما، توان مصرفی و میزان استفادهٔ هر GPU با NVIDIA DCGM و نمایش آن در Grafana و Prometheus.
- خطاهای حافظهٔ GPU (ECC) که میتواند نشانهٔ شروع خرابی یک کارت باشد.
- فضای دیسک، چون مدلها و لاگها خیلی سریع حجیم میشوند.
- زمان پاسخ و تعداد درخواستهای سرویس مدل.
میزان استفاده از GPU را جدی بگیرید. سروری که ۲۰ درصد وقت کار میکند، یعنی ۸۰ درصد سرمایهگذاری بلااستفاده است. اگر استفاده پایین است، میتوانید سرویسهای دیگر سازمان را هم روی همان سرور بیاورید یا با قابلیتهایی مثل MIG، کارت را بین چند تیم تقسیم کنید.
پشتیبانگیری و برنامهٔ خرابی
سرور هوش مصنوعی هم مثل هر سرور دیگری خراب میشود؛ فقط هزینهٔ خوابیدنش بیشتر است. در ایران که تعویض قطعه ممکن است هفتهها طول بکشد، برنامهٔ خرابی اهمیت دوچندان دارد:
- پیکربندی را کد کنید: نصب درایور، کانتینرها و تنظیمات سرویس را با اسکریپت یا ابزارهایی مثل Ansible ثبت کنید تا اگر سرور دوباره نصب شد، در چند ساعت به حالت قبل برگردد.
- از مدلها و دادهها نسخهٔ پشتیبان داشته باشید: مدلهای فاینتیونشده، پایگاه بردار و تنظیمات RAG حاصل هفتهها کار هستند. نسخهٔ پشتیبان را روی استوریج جدا نگه دارید.
- چکپوینتهای آموزش: در آموزشهای طولانی، هر چند ساعت چکپوینت ذخیره کنید تا با قطع برق یا خرابی یک کارت، فقط چند ساعت کار از دست برود، نه چند روز.
- کار با یک کارت کمتر: سرویسها را طوری تنظیم کنید که اگر یک GPU از کار افتاد، با ظرفیت کمتر ادامه بدهند و کل سرویس متوقف نشود.
- قطعهٔ یدک: برای قطعات پرخرابی مثل پاور، فن و دیسک، از تأمینکننده بپرسید چه قطعهای در ایران موجود دارد و زمان تعویض چقدر است.
زمانبندی واقعبینانه
اگر همهچیز آماده باشد، راهاندازی یک سرور هوش مصنوعی تا اولین سرویس قابل استفاده، این زمان را میگیرد:
| مرحله | زمان معمول |
|---|---|
| آمادهسازی برق، سرمایش و رک | ۱ تا ۴ هفته (قبل از تحویل) |
| تحویل، نصب در رک و تست سختافزار | ۱ تا ۳ روز |
| سیستمعامل، درایور، CUDA و Docker | ۱ روز (اگر منابع داخلی آماده باشد) |
| تهیه و انتقال مدلها | چند ساعت تا چند روز |
| راهاندازی سرویس مدل و RAG آزمایشی | ۱ تا ۲ هفته |
| امنیت، دسترسی و پایش | ۱ هفته |
بزرگترین متغیر این جدول در ایران، مرحلهٔ تهیهٔ نرمافزار و مدلهاست. وقتی سرور با نرمافزار آماده تحویل شود، این بخش از چند روز به چند ساعت میرسد.
اشتباهاتی که راهاندازی را هفتهها عقب میاندازند
- رسیدن سرور قبل از آماده شدن برق و سرمایش.
- نصب درایور ناسازگار با نسخهٔ CUDA مورد نیاز پروژه.
- فراموش کردن Fabric Manager روی سرورهای HGX.
- تکیه بر دانلود مستقیم از سرویسهای خارجی در روز راهاندازی.
- انتخاب مدل بر اساس بنچمارک انگلیسی و کشف ضعف آن در فارسی بعد از راهاندازی.
- باز گذاشتن سرور یا کنسول مدیریتی روی اینترنت.
سوالات متداول
راهاندازی سرور هوش مصنوعی چقدر طول میکشد؟
اگر برق و سرمایش آماده باشد و نرمافزارها از قبل تهیه شده باشند، سرور در چند روز آمادهٔ اجرای مدل است. با احتساب RAG، امنیت و پایش، یک سرویس سازمانی قابل اتکا معمولاً در ۲ تا ۴ هفته آماده میشود.
برای سرور هوش مصنوعی چه سیستمعاملی مناسب است؟
Ubuntu Server نسخهٔ LTS رایجترین انتخاب است، چون بیشترِ ابزارهای هوش مصنوعی اول روی آن پشتیبانی میشوند. Rocky Linux و RHEL هم برای سازمانهایی با استاندارد RedHat گزینهٔ مناسبیاند.
با تحریمها چطور مدلها و ایمیجها را دانلود کنیم؟
از آینههای داخلی Docker و pip استفاده کنید، یک رجیستری و مخزن داخلی در سازمان بسازید و مدلها را یکبار از مسیر مطمئن تهیه و روی استوریج داخلی نگه دارید. هرگز ایمیج یا مدل از منبع ناشناس اجرا نکنید.
چه مدل زبانی برای فارسی روی سرور سازمانی مناسب است؟
مدلهای چندزبانهٔ متنباز جدید مثل Qwen، Llama و Gemma پشتیبانی قابل قبولی از فارسی دارند. بهترین انتخاب را با تست روی سؤالهای واقعی سازمان خودتان پیدا کنید.
آیا برای سرور هوش مصنوعی UPS و ژنراتور لازم است؟
بله. با قطعیهای برنامهریزیشدهٔ برق، بهخصوص در تابستان، UPS برای جلوگیری از خاموشی ناگهانی و ژنراتور یا دیتاسنتر با برق پشتیبان برای کار مداوم تقریباً ضروری است.
جمعبندی
راهاندازی سرور هوش مصنوعی از روز تحویل شروع نمیشود؛ از چند هفته قبل با آمادهسازی برق و سرمایش شروع میشود. بعد از آن، ترتیب درست نصب نرمافزار، آماده کردن منابع در داخل سازمان بهجای دانلود از بیرون، انتخاب مدل با تست روی دادهٔ فارسی واقعی، و امنیت و پایش، تفاوت بین سروری که هفتهٔ اول کار میکند و سروری که ماهها در اتاق سرور خاک میخورد را رقم میزند. اگر برای راهاندازی سرور خود یا برآورد زیرساخت لازم کمک میخواهید، با کارشناسان سوانتک در تماس باشید. برای برآورد بودجه هم قیمت سرور GPU در ایران و هزینههای پنهان خرید سرور GPU را ببینید.