
مقالات و اخبار تکنولوژی
DDN EXAScaler: Parallel File System برای AI – راهکار نهایی ذخیرهسازی هوشمند در عصر یادگیری ماشین


نویسنده: تیم مهندسی زیرساخت داده سوان تک | بازبینی فنی: معمار ارشد سیستمهای ذخیرهسازی HPC
تاریخ بهروزرسانی: دی ماه 1404 زمان مطالعه: 10 دقیقه
پاسخ سریع: چرا DDN EXAScaler بهترین انتخاب برای کلاسترهای هوش مصنوعی است؟
در زیرساختهای هوش مصنوعی، کندی در خواندن دادهها میتواند باعث بیکاری (Idle) پردازندههای گرافیکی گرانقیمت شود. DDN EXAScaler با بهرهگیری از سیستم فایل موازی (Parallel File System) و معماری Lustre، این گلوگاه را از بین میبرد. این سیستم با قابلیتهایی مانند ادغام مستقیم با NVIDIA GPUDirect Storage، دادهها را مستقیماً و بدون درگیر کردن CPU به حافظه GPU میفرستد.
مزیت اصلی تجاری: استفاده از EXAScaler میتواند بهرهوری (Utilization) پردازندههای گرافیکی را تا ۱۵٪ افزایش دهد. در یک کلاستر بزرگ، این به معنای جلوگیری از هدررفت میلیونها دلار سرمایه و کاهش زمان آموزش مدلهای زبانی (LLM) از چند هفته به چند روز است. اگر با مدلهای چند میلیارد پارامتری یا دادههای حجیم سروکار دارید، EXAScaler تنها گزینهای است که همپای سرعت NVIDIA H100 حرکت میکند.
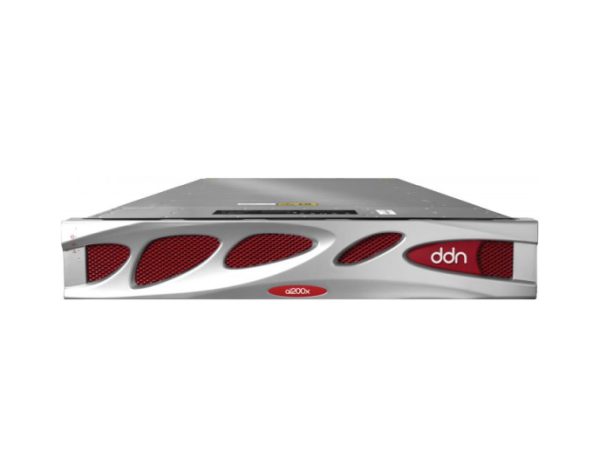
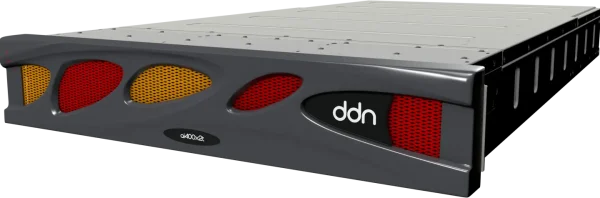
در عصر هوش مصنوعی که دادهها به سوخت اصلی نوآوری تبدیل شدهاند، سیستمهای ذخیرهسازی نقشی فراتر از صرف نگهداری اطلاعات ایفا میکنند. آنها باید به عنوان رگهای حیاتی زیرساخت محاسباتی عمل کنند و جریان پیوسته داده را به سمت پردازندههای گرافیکی (GPU) تضمین کنند. در این میان، DDN EXAScaler با معماری Parallel File System خود، به یکی از تأثیرگذارترین راهکارهای ذخیرهسازی برای بارهای کاری هوش مصنوعی و محاسبات با کارایی بالا (HPC) تبدیل شده است. این سیستم که توسط شرکت DataDirect Networks توسعه یافته، در حال حاضر قلب تپنده سوپرکامپیوترهای پیشرفته NVIDIA و مراکز تحقیقاتی برتر جهان است.
DDN EXAScaler Parallel File System
این مقاله به بررسی عمیق معماری، قابلیتها، مزایا و کاربردهای عملی DDN EXAScaler میپردازد تا تصویری روشن از این که چگونه این فناوری میتواند موتور محرک پروژههای هوش مصنوعی شما باشد، ارائه دهد.
چرا ذخیرهسازی در هوش مصنوعی اهمیت حیاتی دارد؟
گلوگاه پنهان در آموزش مدلهای بزرگ
وقتی صحبت از هوش مصنوعی میشود، اغلب تمرکز روی قدرت پردازشی GPUها قرار میگیرد. اما واقعیت این است که پردازندههای گرافیکی مدرن مانند NVIDIA H100 یا A100 میتوانند داده را با سرعت چندین ترابایت بر ثانیه مصرف کنند. اگر سیستم ذخیرهسازی قادر به تأمین این سرعت نباشد، گرانترین GPUهای جهان در حالت idle باقی میمانند و سرمایهگذاری میلیون دلاری شما هدر میرود.
تحقیقات نشان میدهند که در بسیاری از محیطهای آموزش AI، GPU Utilization کمتر از ۷۰٪ است، و دلیل اصلی آن تأخیرهای I/O در سیستم ذخیرهسازی است. به عبارت سادهتر: GPUها منتظر داده میمانند. در یک کلاستر ۵۱۲ GPU که هر دقیقه توقف حدود ۱۷۰ دلار هزینه دارد، یک checkpoint که ۱۰ دقیقه طول بکشد، به معنای اتلاف بیش از ۱,۷۰۰ دلار فقط در یک وقفه است.
چالشهای خاص بارهای کاری AI
بارهای کاری هوش مصنوعی الگوی I/O منحصربهفردی دارند که از سیستمهای ذخیرهسازی سنتی بسیار متفاوت است:
- خواندن ترتیبی بسیار بزرگ: جریان داده آموزشی با سرعت بالا به صدها یا هزاران GPU به صورت همزمان
- نوشتهای Checkpoint سنگین: ذخیره وضعیت مدلهای چند ترابایتی در بازههای زمانی منظم
- عملیات Metadata فشرده: مدیریت میلیونها فایل کوچک برای feature datasetها، وزنهای مدل و لاگها
- بارهای کاری موازی مختلط: همزمانی آموزش، پیشپردازش داده و استنتاج در یک پایپلاین تولیدی
DDN EXAScaler برای رویارویی با دقیقاً همین چالشها طراحی شده است.
معماری قدرتمند DDN EXAScaler: ترکیبی از نوآوری و تجربه
بنیان Lustre: یک استاندارد اثباتشده
DDN EXAScaler بر پایه سیستم فایل Lustre ساخته شده است، یک parallel file system با بیش از دو دهه سابقه در سوپرکامپیوترهای برتر جهان. Lustre معماری client-server توزیعشدهای دارد که metadata و data path را از هم جدا میکند – این جداسازی کلید عملکرد استثنایی آن است.
معماری Lustre شامل چهار جزء اصلی است:
1. Metadata Server (MDS): سرور متادیتا مسئول مدیریت namespace سیستم فایل است – شامل ساختار دایرکتوریها، نام فایلها، مجوزها و اطلاعات inode. MDS اطلاعات را روی Metadata Target (MDT) ذخیره میکند.
2. Object Storage Server (OSS): سرورهای ذخیرهسازی شیء که دادههای واقعی فایلها را نگهداری میکنند. هر OSS معمولاً بین ۲ تا ۸ Object Storage Target (OST) را سرویس میدهد.
3. Object Storage Target (OST): واحدهای ذخیرهسازی فیزیکی که محتوای فایلها را در قالب objectها نگهداری میکنند. هر فایل به یک یا چند object تقسیم میشود که روی OSTهای مختلف پخش میشوند – این همان قلب عملکرد موازی است.
4. Lustre Client: نودهای compute که به سیستم فایل Lustre متصل میشوند و میتوانند به طور مستقیم و موازی با OSTها ارتباط برقرار کنند.
تمایز EXAScaler: فراتر از Lustre استاندارد
اگرچه Lustre یک فناوری open-source است، اما DDN EXAScaler یک توزیع تجاری و production-hardened آن است که ویژگیهای پیشرفته و بهینهسازیهای اختصاصی را ارائه میدهد:
فشردهسازی سمت Client بدون کاهش عملکرد: یکی از نوآوریهای اخیر EXAScaler، قابلیت Client-Side Compression است که اندازه داده را بدون تأثیرگذاری روی throughput کاهش میدهد. این ویژگی به ویژه برای محیطهای ابری که پهنای باند شبکه هزینهبر است، ارزشمند است.
Multi-tenancy پیشرفته: پشتیبانی native از چندین application و کاربر در سراسر جهان با ایزولهسازی کامل و امنیت تضمینشده. این قابلیت برای ارائهدهندگان سرویس ابری و سازمانهای بزرگ با بخشهای مختلف حیاتی است.
ارتقای آنلاین: امکان upgrade سیستم بدون downtime – یک ویژگی کلیدی برای محیطهای تولیدی ۲۴/۷ که نمیتوانند وقفه داشته باشند.
مانیتورینگ و Health Reporting پیشرفته: ابزارهای جامع نظارتی که به مدیران سیستم دید real-time از عملکرد، سلامت و گلوگاههای احتمالی میدهند.
الگوریتمهای هوشمند بهینهسازی: EXAScaler از الگوریتمهای انعطافپذیر برای بهینهسازی رفتار filesystem استفاده میکند – از جمله load balancing هوشمند، تنظیم پویای stripe patternها و prefetching پیشبینانه.
تکنولوژیهای کلیدی که EXAScaler را متمایز میکنند
Data Striping و Parallel I/O
قلب عملکرد فوقالعاده EXAScaler در مکانیزم data striping آن نهفته است. به جای ذخیره یک فایل روی یک دیسک واحد، EXAScaler آن را به بخشهای کوچکتر (stripe) تقسیم کرده و روی چندین OST توزیع میکند. این بدان معناست که وقتی یک client فایل را میخواند، میتواند همزمان از چندین OSS داده را دریافت کند.
فرض کنید یک فایل ۱۰ گیگابایتی با stripe size ۴ مگابایت روی ۱۰ OST پخش شده است. یک client میتواند ۱۰ جریان I/O موازی داشته باشد، هر کدام حدود ۱ گیگابایت را میخوانند. اگر هر OSS توان ۲ گیگابایت بر ثانیه داشته باشد، throughput کل میتواند به ۲۰ گیگابایت بر ثانیه برسد – یک بهبود ۱۰ برابری نسبت به دسترسی تکرشتهای.
RDMA و InfiniBand Acceleration
EXAScaler برای دستیابی به کمترین latency ممکن، از شبکههای RDMA (Remote Direct Memory Access) بهره میبرد. این تکنولوژی اجازه میدهد داده مستقیماً بین حافظه سرور ذخیرهسازی و حافظه GPU منتقل شود، بدون دخالت CPU و کاهش overhead به حداقل.
در بسیاری از استقرارهای EXAScaler، از InfiniBand با پهنای باند ۲۰۰ یا ۴۰۰ گیگابیت بر ثانیه استفاده میشود. این اتصال فوق سریع تضمین میکند که حتی در بزرگترین کلاسترهای GPU، داده به موقع و بدون وقفه جریان مییابد.
NVLink و GPUDirect Storage Integration
یکی از قابلیتهای منحصربهفرد سیستمهای DDN، ادغام مستقیم با NVIDIA GPUDirect Storage است. این فناوری اجازه میدهد داده مستقیماً از سیستم ذخیرهسازی به حافظه GPU منتقل شود، بدون کپی میانی در حافظه سیستم (CPU RAM).
نتیجه؟ کاهش latency تا ۴۰٪ و افزایش throughput تا ۲ برابر در مقایسه با مسیرهای I/O سنتی. برای مدلهایی که میلیاردها پارامتر دارند و نیاز به بارگذاری مکرر checkpointها دارند، این بهبود میتواند هفتهها در زمان آموزش صرفهجویی کند.
عملکرد واقعی: بنچمارکها و مقایسههای رقابتی
تسلط بر IO500: شاهد عینی برتری
IO500 معتبرترین بنچمارک برای سیستمهای ذخیرهسازی HPC و AI است. در آخرین نتایج IO500 10-Node Production Rankings (ISC 2025)، DDN تسلط مطلق خود را به نمایش گذاشت:
- ۷ از ۱۰ رتبه برتر متعلق به سیستمهای مبتنی بر DDN است
- ۱۰ از ۲۴ رتبه اول در اختیار راهکارهای DDN
- هیچ فروشنده دیگری حتی نزدیک به این سطح از تسلط نیست
این عملکرد فقط یک آمار نیست – نشانه معماری متعادلی است که در هر دو بعد throughput خام و مدیریت metadata درخشش دارد. به عبارت دیگر، EXAScaler میتواند هم ترابایتها داده را در ثانیه منتقل کند و هم میلیونها عملیات فایل کوچک را پردازش کند – دقیقاً همان ترکیبی که محیطهای AI/HPC مدرن نیاز دارند.
مقایسه با رقبا در بارهای کاری واقعی AI:
| سیستم ذخیرهسازی | Throughput نسبی | Metadata Performance |
|---|---|---|
| DDN EXAScaler | 100% (baseline) | عالی |
| WekaFS | ~33% (۳ برابر کندتر) | خوب |
| VAST Data | ~10% (۱۰ برابر کندتر) | متوسط |
| Intel DAOS | بالا در سناریوهای خاص | عالی اما فاقد maturity تجاری |
رکوردشکنی در MLPerf Storage v2.0
MLPerf Storage بنچمارک استاندارد طلایی برای ارزیابی سیستمهای ذخیرهسازی در بارهای کاری AI است. DDN AI400X3 (مبتنی بر EXAScaler) در نسخه ۲.۰ این بنچمارک، رکوردهای تازهای ثبت کرد:
Single-Node Performance:
- پشتیبانی از ۶۴۰ GPU شبیهسازی شده (H100) در benchmark ResNet-50
- throughput پایدار بیش از ۱۱۰ گیگابایت بر ثانیه در حالت خواندن
- بهترین تراکم عملکرد در Cosmoflow و ResNet-50 training
کارایی بینظیر:
- ۱۰۰۰٪ کارایی بهتر در هر node نسبت به سایر راهکارهای موجود
- فشردگی و قدرت کمتر برای همان سطح عملکرد
این نتایج در دنیای واقعی به این معناست که شما میتوانید با کمترین زیرساخت ممکن، بیشترین GPUها را پشتیبانی کنید – یک مزیت رقابتی عظیم از نظر هزینه و فضای مرکز داده.
NVIDIA DGX SuperPOD: انتخاب رسمی غول هوش مصنوعی
شاید قاطعترین شاهد بر قدرت EXAScaler این باشد که NVIDIA، پیشرو بیچونوچرای صنعت GPU، از DDN به عنوان شریک ذخیرهسازی انحصاری خود برای DGX SuperPOD استفاده میکند. Manuvir Das، رئیس Enterprise Computing در NVIDIA، به وضوح اعلام کرده است:
“من یک جمله بسیار ساده برای شما دارم: NVIDIA از DDN استفاده میکند.”
DGX SuperPOD که قدرتمندترین پلتفرم AI تجاری جهان است، برای تغذیه هزاران GPU در کلاسترهای بزرگ به throughput و قابلیت اطمینان EXAScaler متکی است. این شراکت نه تنها یک تأیید فنی است، بلکه نشان میدهد که حتی سختافزارهای پیشرفتهترین دنیا تنها به اندازه سیستم ذخیرهسازیای که آنها را تغذیه میکند، مؤثر هستند.
تحلیل TCO و ارزش تجاری: چرا EXAScaler صرفهجویی واقعی ایجاد میکند
هزینه پنهان GPUهای idle
یک GPU NVIDIA H100 در بازار تقریباً ۳۰,۰۰۰ دلار قیمت دارد. در یک کلاستر ۱۰۰۰ GPU، سرمایهگذاری شما حدود ۳۰ میلیون دلار است. حالا فرض کنید به دلیل I/O کند، بهرهوری GPU شما فقط ۷۰٪ باشد. این یعنی ۹ میلیون دلار از سرمایه شما در حال idle ماندن است.
DDN مدعی است که مشتریان آن با حذف گلوگاه I/O، به طور متوسط ۱۵٪ بهبود در GPU utilization را تجربه میکنند. روی همان کلاستر ۱۰۰۰ GPU، این بهبود معادل به دست آوردن ۴.۵ میلیون دلار کار مفید بیشتر در سال است – فقط با نگهداشتن شتابدهندههای گرانقیمت مشغول.
مقایسه TCO در سه سال: DDN در برابر رقبا
در یک تحلیل مستقل TCO برای یک پروژه AI در مقیاس بزرگ، نتایج چشمگیر بودند:
برای رسیدن به همان سطح throughput:
| راهکار ذخیرهسازی | تعداد Client Process | هزینه TCO سهساله (تقریبی) |
|---|---|---|
| DDN Infinia | ~۱,۶۰۰ | ۱۵۴ میلیون دلار |
| WekaFS | ~۳,۴۰۰ (۲ برابر) | ۳۲۸ میلیون دلار |
| VAST Data | ~۷,۶۰۰ (۵ برابر) | ۷۴۳ میلیون دلار |
صرفهجویی قابل توجه: انتخاب DDN در برابر VAST Data میتواند تا ۵۸۹ میلیون دلار صرفهجویی در سه سال ایجاد کند. این سرمایه آزاد شده میتواند صرف خرید GPUهای بیشتر، استخدام استعدادهای برتر یا تسریع نوآوری شود.
سرعت بالاتر = زمان کمتر تا ارزشآفرینی
DDN Infinia و EXAScaler میتوانند زمان آموزش مدلهای AI را تا ۲۵٪ کاهش دهند. این به معنای یک مدل که معمولاً ۴ روز طول میکشد، اکنون در ۳ روز تمام میشود. در طول یک پروژه چند ماهه، این تسریع میتواند به معنای عرضه محصول به بازار ۲ تا ۳ ماه زودتر باشد.
در صنایع رقابتی مانند autonomous driving، fintech یا drug discovery، سه ماه زودتر بودن میتواند تفاوت بین رهبری بازار و دنبال کردن رقبا باشد – ارزشی که به راحتی دهها میلیون دلار یا بیشتر است.
کاربردهای عملی EXAScaler در صنایع مختلف
آموزش مدلهای زبانی بزرگ (LLM)
مدلهای زبانی مدرن مانند GPT-4، LLaMA و PaLM با صدها میلیارد پارامتر، نیازمند ذخیرهسازی فوقسریع هستند. در یک پروژه آموزش LLM با ۱۷۵ میلیارد پارامتر:
- Checkpoint Size: هر checkpoint میتواند ۳-۵ ترابایت باشد (وزنها + وضعیت optimizer)
- فرکانس Checkpoint: هر ۱-۲ ساعت برای محافظت در برابر خرابی
- Dataset Size: دهها تا صدها ترابایت داده آموزشی
EXAScaler با توانایی نوشتن checkpointهای چند ترابایتی در چند دقیقه (به جای چند ساعت)، downtime GPU را به حداقل میرساند. همچنین، streaming داده آموزشی با سرعت صدها گیگابایت بر ثانیه تضمین میکند که هیچ GPUای منتظر نماند.
شرکتهایی مانند Scaleway (یک NVIDIA Cloud Partner پیشرو در اروپا) از کلاسترهای DDN EXAScaler برای تغذیه خوشههای DGX H100 استفاده میکنند و خدمات AI ابری سریع، امن و کارآمد به بیش از ۲۵,۰۰۰ کسبوکار ارائه میدهند.
Autonomous Driving و Computer Vision
صنعت خودروهای خودران یکی از دادهمحورترین حوزههای AI است. یک شرکت خودروسازی ممکن است:
- صدها پتابایت ویدیو و داده سنسور جمعآوری کند
- میلیونها فریم تصویر را برای برچسبزنی پردازش کند
- مدلهای perception و planning را روی این datasetهای عظیم آموزش دهد
DDN EXAScaler با معماری مقیاسپذیر خود که میتواند به صدها پتابایت برسد و هزاران OSS را پشتیبانی کند، backbone ایدهآل برای چنین پروژههایی است. قابلیت مدیریت هم فایلهای بزرگ ویدیویی و هم میلیونها فایل کوچک feature، آن را منحصربهفرد میکند.
علوم زیستی و Genomics
در حوزه بیوانفورماتیک و drug discovery، محققان با دادههای توالی ژنوم کار میکنند که هم volume بالایی دارند و هم نیاز به پردازش metadata فشرده دارند. یک پروژه sequencing ژنوم میتواند:
- ترابایتها داده خام تولید کند
- میلیونها فایل میانی در مراحل پردازش ایجاد کند
- نیاز به دسترسی همزمان دهها محقق داشته باشد
EXAScaler با قابلیتهای multi-tenancy و عملکرد metadata برجستهاش، میتواند این workflows پیچیده را به روانی اداره کند. پژوهشگران میتوانند تحلیلهای عمیق را که ماهها طول میکشید، در چند هفته تمام کنند.
محاسبات علمی و شبیهسازی (HPC سنتی)
اگرچه تمرکز این مقاله روی AI است، اما ریشههای EXAScaler در HPC نادیده گرفتنی نیست. این سیستم هنوز هم برای:
- شبیهسازیهای دینامیک سیالات محاسباتی (CFD)
- مدلسازی آبوهوا و پیشبینیهای اقلیمی
- شبیهسازیهای مولکولی و نانو
- تحلیلهای مالی و ارزیابی ریسک
استفاده میشود. توانایی EXAScaler در ارائه عملکرد دقت بالا (FP64) و مقیاسپذیری چند پتابایتی، آن را به انتخابی ایدهآل برای مراکز تحقیقاتی و ابررایانهها تبدیل کرده است.
ادغام با اکوسیستم Cloud: EXAScaler Cloud
زیرساخت هیبریدی برای دنیای مدرن
در حالی که بسیاری از سازمانها همچنان سرورهای on-premise برای بارهای کاری حساس خود دارند، نیاز به انعطافپذیری ابری نیز در حال افزایش است. DDN EXAScaler Cloud یک توزیع بهینهشده از EXAScaler برای محیطهای ابری است که:
- در چند کلیک مستقر میشود: بر خلاف راهاندازی پیچیده راهکارهای on-premise، EXAScaler Cloud میتواند در چند دقیقه یک filesystem با کارایی بالا ایجاد کند.
- با Google Cloud Managed Lustre یکپارچه است: Google Cloud اخیراً Managed Lustre را که توسط DDN EXAScaler پشتیبانی میشود، به صورت عمومی عرضه کرده است. این سرویس چهار سطح عملکردی مختلف ارائه میدهد و برای بارهای کاری AI و HPC بهینه شده است.
- با Azure، AWS و سایر providerها سازگار است: EXAScaler Cloud در Microsoft Azure Marketplace و سایر پلتفرمها نیز موجود است.
کاربردهای هیبریدی: بسیاری از مشتریان از یک رویکرد ترکیبی استفاده میکنند:
- دادههای حساس و مدلهای اصلی را on-premise نگه میدارند
- از ظرفیت ابری برای burst workloadها، آزمایشهای سریع یا استنتاج در مقیاس بزرگ استفاده میکنند
- از EXAScaler برای ایجاد یک global namespace یکپارچه در هر دو محیط بهره میبرند
این انعطافپذیری به سازمانها اجازه میدهد استراتژی ذخیرهسازی خود را بر اساس نیازها، قوانین و بودجه تنظیم کنند.
مقایسه EXAScaler با سایر Parallel File Systems
EXAScaler vs BeeGFS
BeeGFS یک parallel file system محبوب open-source است که در بسیاری از محیطهای HPC استفاده میشود. تفاوتهای کلیدی:
| ویژگی | DDN EXAScaler | BeeGFS |
|---|---|---|
| Maturity تجاری | بسیار بالا، پشتیبانی سازمانی کامل | متوسط، بیشتر community-driven |
| عملکرد Metadata | عالی، بهینه برای میلیونها فایل | خوب، اما در مقیاس بسیار بزرگ محدودیت دارد |
| Throughput | استثنایی، رکورددار بنچمارکها | بالا، اما کمتر از EXAScaler |
| Enterprise Features | کامل (multi-tenancy، encryption، compliance) | محدود |
EXAScaler vs IBM Spectrum Scale (GPFS)
GPFS یکی از قدیمیترین و معتبرترین parallel file systemها است:
| ویژگی | DDN EXAScaler | IBM Spectrum Scale |
|---|---|---|
| معماری | مدرن، بهینه برای NVMe و flash | پخته، اما طراحی قدیمیتر |
| سازگاری با AI | بسیار بالا، ادغام GPUDirect | خوب، اما نیاز به tuning بیشتر |
| Licensing | سادهتر، بر پایه ظرفیت | پیچیده، بر پایه core |
| Cost-effectiveness | عملکرد بالاتر در هر دلار | بالا، اما نیاز به سرمایه اولیه بیشتر |
EXAScaler vs WekaFS
WekaFS یک راهکار نسبتاً جدید و مدرن است که مدعی عملکرد استثنایی در cloud است:
| ویژگی | DDN EXAScaler | WekaFS |
|---|---|---|
| عملکرد واقعی AI | ثابتشده، ۳ برابر سریعتر در benchmarkها | خوب، اما نیاز به منابع client بیشتر |
| مقیاسپذیری | تا صدها پتابایت، هزاران نود | محدودتر در مقیاس خیلی بزرگ |
| Track record | دههها سابقه در بزرگترین سوپرکامپیوترها | نسبتاً جدید، موردی کمتر |
| TCO | بهترین efficiency در هزینه | نیاز به زیرساخت بیشتر برای عملکرد مشابه |
بهترین شیوههای استقرار و پیکربندی
ملاحظات سختافزاری
برای دستیابی به بهترین عملکرد از EXAScaler، این نکات را در نظر بگیرید:
Storage Backend:
- NVMe Flash: برای بالاترین throughput و کمترین latency، از درایوهای NVMe استفاده کنید. DDN AI400X3 به طور خاص برای NVMe طراحی شده است.
- HDD برای Capacity: برای دادههای کمتر حساس به سرعت، میتوان از HDDs با ظرفیت بالا برای کاهش هزینه استفاده کرد.
- Hybrid Tiering: استفاده از flash برای hot data و HDD برای cold data، تعادل بهینه بین عملکرد و هزینه ایجاد میکند.
Networking:
- InfiniBand 200Gb/400Gb: برای کلاسترهای بزرگ AI، InfiniBand گزینه ایدهآل است.
- RDMA over Converged Ethernet (RoCE): یک جایگزین اقتصادیتر برای محیطهایی که InfiniBand ندارند.
- پهنای باند کافی: اطمینان حاصل کنید که پهنای باند شبکه از throughput کل OSTها پشتیبانی میکند.
بهینهسازیهای نرمافزاری
Stripe Pattern Tuning:
- برای فایلهای بزرگ (چند گیگابایت)، stripe count بالا (۸-۱۶) و stripe size بزرگتر (۴-۸ MB) را امتحان کنید.
- برای میلیونها فایل کوچک، stripe count پایینتر کافی است.
Client-side Caching:
- فعال کردن client-side read caching میتواند عملکرد را برای دادههای تکراری بهبود بخشد.
Monitoring و Tuning:
- از ابزارهای DDN مانند EXAScaler Health Monitoring استفاده کنید.
- به طور منظم metrics مانند OST utilization، network bandwidth و client IOPS را بررسی کنید.
آینده EXAScaler: نوآوریهای در راه
DDN به طور مداوم در حال تکامل EXAScaler برای پاسخگویی به نیازهای آینده AI است. روندهای آتی شامل:
ادغام عمیقتر با AI Frameworks: بهینهسازیهای خاص برای PyTorch، TensorFlow و JAX برای کاهش بیشتر overhead.
Tiering هوشمند مبتنی بر ML: استفاده از الگوریتمهای یادگیری ماشین برای پیشبینی الگوهای دسترسی و جابجایی خودکار داده بین tierهای مختلف.
پشتیبانی بهتر از Kubernetes: ادغام seamless با Kubernetes و containerized AI workflows.
Sustainability: بهینهسازیهای انرژی برای کاهش ردپای کربن مراکز داده AI.
پاسخ به پرسشهای متداول
۱. آیا DDN EXAScaler فقط برای سازمانهای بزرگ مناسب است؟
خیر. اگرچه EXAScaler در بزرگترین سوپرکامپیوترها استفاده میشود، اما راهکارهای DDN مقیاسپذیر هستند و میتوانند از چندده ترابایت شروع کرده و با نیازهای شما رشد کنند. شرکتهای متوسط و استارتاپهای AI نیز میتوانند بهرهمند شوند.
۲. چقدر زمان میبرد تا یک سیستم EXAScaler را راهاندازی کنیم؟
برای استقرار on-premise، بسته به مقیاس، میتواند از چند روز تا چند هفته طول بکشد. نسخه ابری (EXAScaler Cloud) میتواند در چند دقیقه مستقر شود. DDN همچنین خدمات نصب و پیکربندی حرفهای ارائه میدهد.
۳. آیا EXAScaler با GPUهای غیر NVIDIA سازگار است؟
بله، EXAScaler یک parallel file system عمومی است و با هر نوع compute node (شامل GPUهای AMD، Intel Xeon Phi و حتی CPUها) کار میکند. البته بهینهسازیهای خاص مانند GPUDirect Storage فقط با NVIDIA کار میکند.
۴. امنیت داده در EXAScaler چگونه است؟
EXAScaler ویژگیهای امنیتی enterprise-grade شامل:
- رمزنگاری end-to-end برای data at rest و in transit
- ادغام با LDAP/Active Directory برای مدیریت دسترسی
- Audit logging کامل برای compliance
- Multi-tenancy با ایزولهسازی کامل
۵. آیا میتوان از EXAScaler برای inference نیز استفاده کرد؟
قطعاً. در حالی که EXAScaler برای training بهینه شده است، عملکرد فوقالعاده آن در serving مدلها برای inference نیز بسیار مفید است – به خصوص برای مدلهای بزرگی که نمیتوانند کاملاً در حافظه GPU جا شوند.
۶. پشتیبانی فنی چگونه است؟
DDN پشتیبانی ۲۴/۷ با تیم متخصصان جهانی ارائه میدهد. SLAهای مختلف برای سطوح مختلف پشتیبانی وجود دارد، از جمله گزینههای premium برای سازمانهای mission-critical.
۷. آیا میتوان EXAScaler را برای بارهای کاری غیر AI استفاده کرد؟
بله، بسیاری از مشتریان از EXAScaler برای ترکیبی از بارهای کاری HPC سنتی، analytics، rendering رسانهای و حتی ذخیرهسازی عمومی enterprise استفاده میکنند. چندمنظوره بودن آن یک مزیت بزرگ است.
نتیجهگیری: EXAScaler به عنوان سنگ بنای زیرساخت AI
در عصری که هوش مصنوعی به رانشگر اصلی نوآوری تبدیل شده است، نمیتوان اهمیت یک سیستم ذخیرهسازی قدرتمند و قابل اعتماد را دست کم گرفت. DDN EXAScaler با ترکیبی از معماری اثباتشده Lustre، بهینهسازیهای پیشرفته برای بارهای کاری AI و track record درخشان در بزرگترین استقرارهای جهان، خود را به عنوان استاندارد طلایی برای parallel file systemهای AI تثبیت کرده است.
چه در حال آموزش مدلهای زبانی با تریلیونها پارامتر باشید، چه توسعه سیستمهای خودران، و چه انجام تحقیقات علمی پیشرفته، EXAScaler میتواند تضمین کند که داده هرگز گلوگاه شما نباشد. با سرمایهگذاری در راهکار ذخیرهسازی درست، نه تنها عملکرد فنی را بهبود میبخشید، بلکه ROI سرمایهگذاری GPU خود را چند برابر میکنید، زمان رسیدن به بازار را کاهش میدهید و مزیت رقابتی پایداری کسب میکنید.
در نهایت، انتخاب بین ذخیرهسازیهای مختلف فقط یک تصمیم فنی نیست – یک تصمیم استراتژیک است که میتواند موفقیت یا شکست پروژههای هوش مصنوعی شما را رقم بزند. با DDN EXAScaler، شما روی یک شریک اثباتشده سرمایهگذاری میکنید که از NVIDIA تا بزرگترین مراکز تحقیقاتی جهان، به آن اعتماد دارند.