
مقالات و اخبار تکنولوژی
زیرساخت شبکه برای هوش مصنوعی: راهنمای جامع طراحی و پیادهسازی Network Infrastructure


نویسنده: تیم مهندسی شبکه سوان تک | بازبینی فنی: مهندس ارشد دیتاسنتر و CCIE
تاریخ بهروزرسانی: آذر 1404 زمان مطالعه: 14 دقیقه
پاسخ سریع: InfiniBand یا RoCEv2؟ کدام برای کلاستر AI شما بهتر است؟
در کلاسترهای هوش مصنوعی، گلوگاه اصلی دیگر پردازنده نیست، بلکه شبکه است. برای انتخاب بین دو فناوری اصلی، این قانون کلی را در نظر بگیرید:
- انتخاب NVIDIA InfiniBand (Quantum-2): اگر بودجه نامحدود دارید و هدف شما آموزش مدلهای زبانی عظیم (LLM) با بیش از ۱۰۰ میلیارد پارامتر روی هزاران GPU است، InfiniBand با تأخیر زیر ۰.۵ میکروثانیه و قابلیت محاسبات درونشبکه (In-Network Computing)، بیرقیب است.
- انتخاب Ethernet RoCEv2 (مانند H3C S9855): برای ۹۰٪ سازمانها، RoCEv2 انتخاب هوشمندانهتری است. این فناوری با هزینهای حدود ۵۰٪ کمتر از InfiniBand، عملکردی بسیار نزدیک به آن (تأخیر ۲-۴ میکروثانیه) ارائه میدهد و با تیمهای فنی و زیرساخت فعلی دیتاسنتر شما سازگار است. شرکتهایی مانند متا (فیسبوک) کلاسترهای ۲۴,۰۰۰ کارتی خود را با همین فناوری ساختهاند.
نتیجهگیری: اگر به دنبال “عملکرد مطلق به هر قیمتی” هستید، InfiniBand بخرید. اما اگر به دنبال “بهترین نسبت عملکرد به قیمت” و انعطافپذیری هستید، RoCEv2 با تجهیزات ۴۰۰G استاندارد، برنده قطعی است.
در عصری که هوش مصنوعی به موتور محرک تحول دیجیتال سازمانها تبدیل شده است، زیرساخت شبکه نقشی حیاتی در موفقیت یا شکست پروژههای AI ایفا میکند. آموزش مدلهای یادگیری عمیق، پردازش دادههای عظیم و اجرای استنتاج در مقیاس بزرگ، همگی نیازمند معماری شبکهای هستند که فراتر از استانداردهای سنتی دیتاسنتر عمل کند. این مقاله به بررسی جامع تمامی جنبههای طراحی، انتخاب فناوری و پیادهسازی زیرساخت شبکه برای محیطهای هوش مصنوعی میپردازد.
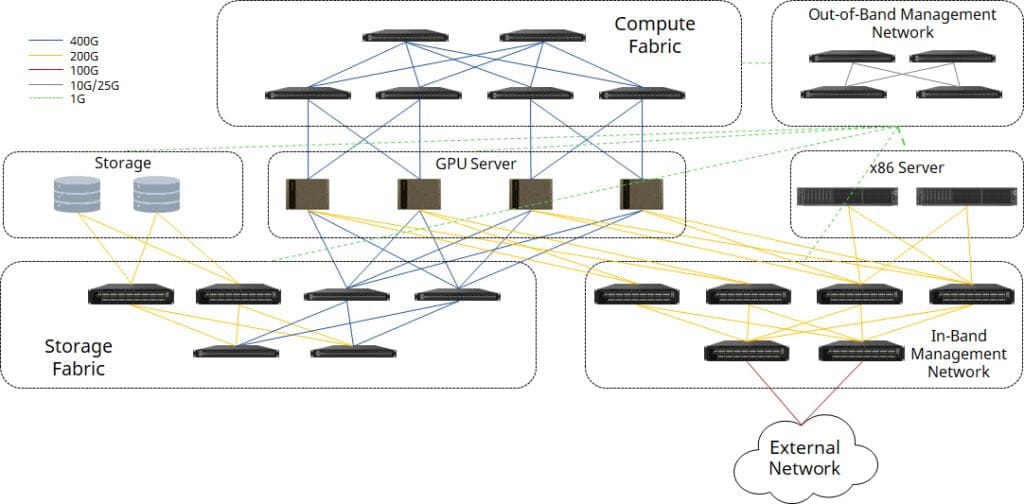
فهرست مطالب
- چالشهای شبکه در عصر هوش مصنوعی
- معماری شبکه برای کلاسترهای GPU
- فناوریهای کلیدی: InfiniBand، RoCEv2 و Ethernet
- طراحی توپولوژی Leaf-Spine برای AI
- پروتکلهای RDMA و اهمیت آنها
- مدیریت پهنای باند و کاهش تاخیر
- راهکارهای تجاری: NVIDIA Quantum-2 و H3C S9855
- بهینهسازی و مانیتورینگ شبکه AI
- TCO و تحلیل هزینه-فایده
- آینده شبکههای هوش مصنوعی
چرا زیرساخت شبکه برای AI متفاوت است؟
یکی از بزرگترین اشتباهاتی که سازمانها در راهاندازی زیرساخت هوش مصنوعی مرتکب میشوند، استفاده از معماری شبکه سنتی دیتاسنتر است. شبکههای معمولی برای الگوهای ترافیکی شمال-جنوب (North-South) طراحی شدهاند که در آنها دادهها از سرورها به اینترنت یا کاربران نهایی منتقل میشوند. اما در محیطهای هوش مصنوعی، الگوی غالب ترافیک، شرق-غرب (East-West) است که در آن سرورها و پردازندههای گرافیکی به طور مداوم و فشرده با یکدیگر ارتباط برقرار میکنند.
وقتی صدها یا هزاران GPU در حال آموزش یک مدل یادگیری عمیق هستند، هر چند ثانیه یکبار باید گرادیانهای محاسبه شده را با یکدیگر همگامسازی کنند. این فرآیند که به عملیات All-Reduce معروف است، حجم عظیمی از داده را بین تمام نودها جابجا میکند. حتی تاخیر چند میلیثانیهای در این فرآیند میتواند باعث بیکار ماندن پردازندههای گرانقیمت شود و زمان آموزش مدل را از روزها به هفتهها افزایش دهد. تحقیقات نشان میدهد که در کلاسترهای بزرگ AI، تا 60 درصد از زمان اجرا صرف عملیات شبکه میشود.
علاوه بر الگوهای ترافیکی خاص، محیطهای هوش مصنوعی با ترافیکهای انفجاری (Burst Traffic) مواجه هستند. در لحظاتی که عملیات همگامسازی آغاز میشود، ممکن است چندین ترابیت داده به طور ناگهانی در شبکه ظاهر شوند. شبکههای سنتی که برای ترافیکهای پیوسته طراحی شدهاند، در مواجهه با چنین الگوهایی دچار تراکم شده و بستهها را از دست میدهند. از دست رفتن حتی یک بسته در پروتکلهای حساس مانند RDMA میتواند کل عملیات را مختل کند و نیاز به ارسال مجدد داشته باشد.
یکی دیگر از ویژگیهای بارهای کاری AI، نیاز به شبکه بدون اتلاف (Lossless Network) است. بر خلاف برنامههای وب که میتوانند کمی تاخیر یا از دست رفتن بسته را تحمل کنند، الگوریتمهای یادگیری ماشین نیاز دارند که تمام دادهها با دقت کامل و بدون هیچ گونه خطایی منتقل شوند. این نیاز، استفاده از فناوریهای پیشرفتهای مانند Priority Flow Control و Explicit Congestion Notification را ضروری میسازد.
معماری توپولوژی Leaf-Spine: استاندارد طلایی برای AI
برای پاسخگویی به نیازهای خاص بارهای کاری هوش مصنوعی، معماری Leaf-Spine به عنوان استاندارد شناخته شده است. این توپولوژی که ریشه در تکامل شبکههای دیتاسنتر مدرن دارد، مزایای بینظیری برای کلاسترهای GPU ارائه میدهد. در این معماری، شبکه به دو لایه تقسیم میشود: سوئیچهای Leaf که مستقیماً به سرورها متصل هستند و سوئیچهای Spine که نقش هسته شبکه را ایفا میکنند.
ویژگی کلیدی این معماری، اتصال کامل (Full-Mesh) بین لایههای Leaf و Spine است. هر سوئیچ Leaf به تمام سوئیچهای Spine متصل است و این اتصال تضمین میکند که مسیرهای متعددی برای رسیدن از هر نقطه به نقطه دیگر وجود دارد. این طراحی دو مزیت حیاتی ارائه میدهد: اول، پهنای باند یکنواخت بین تمام نودها که به این معنی است هیچ گلوگاهی در شبکه وجود ندارد. دوم، افزونگی بالا که در صورت خرابی هر سوئیچ یا لینک، ترافیک به طور خودکار از مسیرهای دیگر عبور میکند.
در طراحی عملی یک کلاستر AI، انتخاب نسبت Oversubscription بسیار مهم است. در یک شبکه Non-blocking کامل، هر سرور باید پهنای باندی معادل تمام پورتهای خود را به سمت Spine داشته باشد. به عنوان مثال، اگر هر سرور دارای 8 کارت شبکه 100G است، سوئیچ Leaf باید 8x100G آپلینک به Spine داشته باشد. این طراحی هرچند گران است، اما برای بارهای کاری حساس AI ضروری است. برخی پیادهسازیها با نسبت 2:1 یا 3:1 Oversubscription طراحی میشوند که هزینه را کاهش میدهد اما ممکن است در سناریوهای All-to-All communication با گلوگاه مواجه شوند.
مقیاسپذیری یکی دیگر از مزایای معماری Leaf-Spine است. برای افزایش ظرفیت، میتوان به سادگی سوئیچهای Spine یا Leaf جدید اضافه کرد. یک کلاستر 256 GPU معمولاً با 8 سوئیچ Leaf و 4 سوئیچ Spine پیادهسازی میشود، در حالی که برای مقیاسهای بزرگتر مانند 10000 GPU، ممکن است به معماری سه لایهای (با افزودن لایه Super-Spine) نیاز باشد. سوان تک با تجربه طراحی و پیادهسازی چنین شبکههایی، میتواند راهنمای کاملی برای انتخاب بهترین توپولوژی بر اساس نیازهای شما ارائه دهد.
مقایسه فناوریهای شبکه: InfiniBand در مقابل RoCEv2
یکی از مهمترین تصمیمات در طراحی زیرساخت شبکه AI، انتخاب بین InfiniBand و RoCEv2 است. این دو فناوری رقیب اصلی در حوزه شبکههای با کارایی بالا هستند و هر کدام مزایا و معایب خاص خود را دارند.
InfiniBand: قدرت خالص برای عملکرد حداکثری
InfiniBand یک پروتکل اختصاصی است که از ابتدا برای محاسبات با کارایی بالا طراحی شده است. بزرگترین مزیت InfiniBand، تاخیر فوقالعاده پایین آن است که میتواند به کمتر از 0.5 میکروثانیه برسد. این مقدار برای عملیات همگامسازی دقیق در کلاسترهای بزرگ بسیار حیاتی است. NVIDIA Quantum-2 با ارائه پهنای باند 400 گیگابیت بر ثانیه در هر پورت و قابلیتهای پیشرفته SHARP v3، نسل جدید این فناوری را نمایندگی میکند.
فناوری SHARP (Scalable Hierarchical Aggregation and Reduction Protocol) که در InfiniBand پیادهسازی شده است، یک نوآوری انقلابی است. این قابلیت عملیات جمعآوری و کاهش دادهها (مانند میانگینگیری گرادیانها در یادگیری عمیق) را از روی GPU برداشته و مستقیماً در سوئیچهای شبکه انجام میدهد. نتیجه این است که ترافیک شبکه تا 32 برابر کاهش مییابد و زمان آموزش مدلهای بزرگ به طور چشمگیری بهبود پیدا میکند. مدلهای زبانی بزرگی مانند GPT-4 و Claude در کلاسترهای InfiniBand آموزش دیدهاند.
با این حال، InfiniBand معایبی نیز دارد. هزینه بسیار بالا، وابستگی به تأمینکننده واحد (عمدتاً NVIDIA Mellanox) و نیاز به تخصص فنی عمیق برای مدیریت آن، از جمله چالشهای اصلی هستند. برای یک کلاستر 256 نودی، هزینه زیرساخت InfiniBand میتواند 2 تا 3 برابر معادل Ethernet باشد.
RoCEv2: انعطافپذیری و مقرونبهصرفه بودن
RDMA over Converged Ethernet نسخه 2 یا RoCEv2 رویکردی متفاوت را دنبال میکند. این فناوری قابلیتهای RDMA را بر روی شبکههای Ethernet استاندارد پیادهسازی میکند. مزیت اصلی RoCEv2، سازگاری با اکوسیستم گسترده Ethernet و کاهش قابل توجه هزینهها است. سوئیچ H3C S9855 با پشتیبانی کامل از RoCEv2 و پورتهای 400G، نمونهای از راهکارهای پیشرفته در این زمینه است.
RoCEv2 برای دستیابی به شبکه بدون اتلاف، از مکانیزمهای پیچیدهای استفاده میکند. Priority Flow Control (PFC) از افت بسته در کلاسهای خاص ترافیک جلوگیری میکند. Explicit Congestion Notification (ECN) زمانی که ازدحام در حال شکلگیری است، بستهها را علامتگذاری میکند. Data Center Quantized Congestion Notification (DCQCN) یک الگوریتم هوشمند است که ECN و محدودسازی نرخ را ترکیب میکند تا تراکم را به صورت پیشگیرانه کنترل کند.
شرکتهایی مانند Meta از RoCEv2 برای کلاسترهای 24000 نودی خود استفاده میکنند. تحقیقات Meta نشان میدهد که با تنظیمات صحیح، RoCEv2 میتواند تاخیر 2-4 میکروثانیه را ارائه دهد که برای اکثر بارهای کاری AI کافی است. مقایسه جامع این دو فناوری در مقاله InfiniBand vs RoCEv2 آمده است.
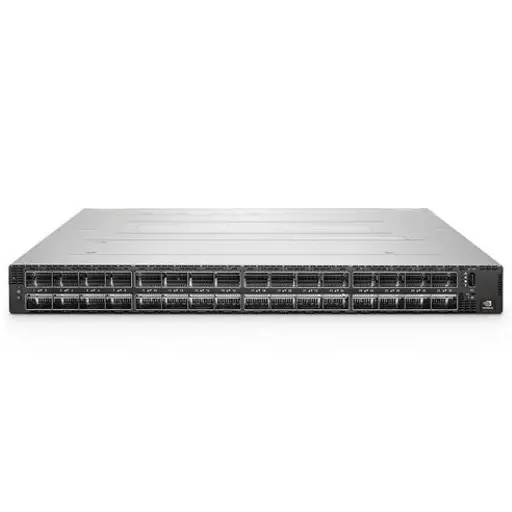

جدول مقایسه جامع
| معیار | InfiniBand (NVIDIA Quantum-2) | RoCEv2 (H3C S9855) |
|---|---|---|
| تاخیر | کمتر از 0.5 میکروثانیه | 2-4 میکروثانیه |
| پهنای باند | تا 400 گیگابیت بر ثانیه | تا 400 گیگابیت بر ثانیه |
| RDMA | بومی و بهینه شده | نیازمند تنظیم دقیق |
| In-Network Computing | SHARP v3 | محدود |
| هزینه سرمایهگذاری | بسیار بالا | متوسط تا بالا |
| TCO (5 ساله) | بالا | 40-55% کمتر |
| مقیاسپذیری | عالی تا 64000 نود | بسیار بالا (نامحدود) |
| اکوسیستم | محدود (NVIDIA) | گسترده (چند تأمینکننده) |
| پیچیدگی مدیریت | نیاز به تخصص عمیق | متوسط (آشنا برای تیمهای Ethernet) |
| بهترین کاربرد | کلاسترهای حیاتی بزرگ AI/HPC | کلاسترهای مقیاسپذیر و هوشمند |
پروتکل RDMA: قلب تپنده شبکههای AI
Remote Direct Memory Access یا RDMA فناوریای است که انقلابی در نحوه انتقال داده بین سرورها ایجاد کرده است. برای درک اهمیت RDMA، باید به نحوه کار شبکههای سنتی نگاهی بیندازیم. در پروتکل TCP/IP معمولی، وقتی دادهای از یک سرور به سرور دیگر منتقل میشود، پردازنده مرکزی (CPU) باید چندین بار در این فرآیند دخالت کند: یکبار برای کپی داده از حافظه برنامه به بافر شبکه، یکبار برای پردازش پشته پروتکل و بار دیگر در سمت گیرنده. این کپیهای مکرر هم زمانبر هستند و هم بخش قابل توجهی از توان CPU را مصرف میکنند.
RDMA این فرآیند را کاملاً متحول میکند. با استفاده از RDMA، کارت شبکه میتواند مستقیماً داده را از حافظه برنامه در یک سرور به حافظه برنامه در سرور دیگر منتقل کند بدون هیچ دخالتی از CPU یا سیستم عامل. این عملیات که به Zero-Copy معروف است، تاخیر را از چند میلیثانیه به چند میکروثانیه کاهش میدهد و CPU را کاملاً آزاد میکند تا تمام توان خود را صرف محاسبات اصلی کند.
در محیطهای یادگیری عمیق، عملیاتی به نام AllReduce وجود دارد که در آن همه GPUها باید گرادیانهای محاسبه شده خود را با یکدیگر به اشتراک بگذارند و میانگین بگیرند. این عملیات در هر ایتریشن آموزش انجام میشود و میتواند تا 60 درصد از زمان کل اجرا را شامل شود. RDMA با حذف سربار CPU و کاهش تاخیر، این عملیات را به طور چشمگیری تسریع میکند. مطالعات نشان میدهد که استفاده از RDMA میتواند زمان آموزش مدلهای بزرگ را تا 40 درصد کاهش دهد.
پیادهسازی RDMA: چالشها و راهکارها
پیادهسازی موفق RDMA نیازمند توجه به جزئیات فنی زیادی است. برای RoCEv2، تنظیم صحیح PFC و ECN بسیار حیاتی است. PFC باید برای صفهای خاصی که ترافیک RDMA را حمل میکنند فعال شود (معمولاً Priority 3 یا 4). اگر PFC برای همه کلاسهای ترافیک فعال شود، ممکن است با پدیده Head-of-Line Blocking مواجه شوید که عملکرد کل شبکه را تخریب میکند.
ECN نیز باید با دقت تنظیم شود. Threshold های ECN تعیین میکنند که چه زمانی سوئیچ شروع به علامتگذاری بستهها میکند. اگر این مقادیر خیلی پایین باشند، سوئیچ زودتر از موعد سیگنال تراکم میدهد و پهنای باند استفاده نمیشود. اگر خیلی بالا باشند، ممکن است تا زمانی که سیگنال داده شود، بافرها پر شده باشند. تجربه نشان میدهد که تنظیم ECN Threshold بین 30 تا 50 درصد ظرفیت بافر برای اکثر بارهای کاری AI مناسب است.
یکی دیگر از چالشها، انتخاب و پیکربندی NICs (Network Interface Cards) است. کارتهای شبکه باید از RDMA پشتیبانی کنند و درایورهای مناسب نصب شده باشند. کارتهای NVIDIA ConnectX-6 و جدیدتر یا Broadcom Thor از گزینههای محبوب هستند. همچنین باید اطمینان حاصل کرد که نرمافزار برنامهنویسی (مانند PyTorch یا TensorFlow) به درستی برای استفاده از RDMA پیکربندی شده است. کتابخانههایی مانند NVIDIA NCCL (NVIDIA Collective Communications Library) به طور خودکار از RDMA استفاده میکنند و باید در محیط فعال باشند.
راهکارهای تجاری پیشنهادی برای زیرساخت شبکه AI
NVIDIA Quantum-2: قدرت مطلق برای کلاسترهای حیاتی
پلتفرم NVIDIA Quantum-2 InfiniBand NDR 400G برای سازمانهایی طراحی شده که عملکرد مطلق را در اولویت قرار میدهند. این پلتفرم شامل سوئیچهای QM9700 و QM9790 است که هر کدام 64 پورت 400 گیگابیت بر ثانیه را در یک شاسی 1U ارائه میدهند. ظرفیت کل سوئیچینگ این دستگاهها به 25.6 ترابیت بر ثانیه میرسد.
ویژگی SHARP v3 در Quantum-2 یک نوآوری واقعی است. این فناوری عملیات AllReduce را که معمولاً روی GPUها انجام میشود، به داخل سوئیچ منتقل میکند. نتیجه این است که ترافیک شبکه به طور چشمگیری کاهش مییابد و زمان آموزش مدلهای بزرگ تا 40 درصد بهبود پیدا میکند. همچنین، Adaptive Routing هوشمند این پلتفرم به صورت لحظهای بهترین مسیر را برای هر بسته انتخاب میکند و از تراکم جلوگیری میکند.
Quantum-2 برای محیطهایی مناسب است که:
- آموزش مدلهای زبانی با بیش از 100 میلیارد پارامتر
- محاسبات علمی HPC با نیاز به تاخیر زیر یک میکروثانیه
- سیستمهای معاملاتی مالی با فرکانس بالا
- کلاسترهای تحقیقاتی دانشگاهی پیشرفته
H3C S9855: انعطافپذیری و مقرونبهصرفه بودن
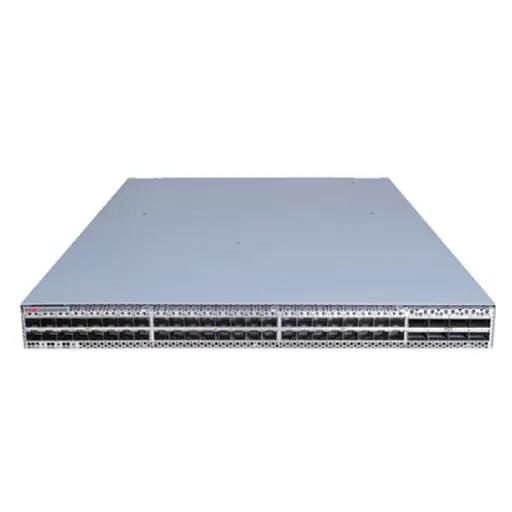
در مقابل، سوئیچ H3C S9855 راهکاری منعطفتر و مقرونبهصرفهتر برای سازمانهایی است که میخواهند از مزایای RDMA بدون هزینههای سنگین InfiniBand بهرهمند شوند. این سری شامل مدلهای مختلفی است:
S9855-32D: با 32 پورت 400GE، ایدهآل برای لایه Spine در کلاسترهای بزرگ. ظرفیت سوئیچینگ 25.6 Tbps و پشتیبانی کامل از RoCEv2، PFC و ECN.
S9855-48CD8D: ترکیبی از 48 پورت 100GE و 8 پورت 400GE، مناسب برای لایه Leaf. این مدل میتواند تا 48 سرور با NIC 100G را به طور مستقیم اتصال دهد.
S9855-40B: دارای 40 پورت 200GE که تعادل خوبی بین تراکم پورت و پهنای باند ارائه میدهد.
مزیت اصلی H3C S9855 علاوه بر قیمت، سازگاری با اکوسیستم گسترده Ethernet است. میتوانید از NICهای مختلف تأمینکنندگان مانند NVIDIA، Broadcom یا Intel استفاده کنید. همچنین تیمهای شبکه شما نیازی به آموزشهای تخصصی ندارند زیرا مدیریت این سوئیچها مشابه سایر تجهیزات Ethernet است.
این سوئیچها برای محیطهایی مناسب است که:
- کلاسترهای AI در مقیاس متوسط تا بزرگ (256 تا 10000 GPU)
- دیتاسنترهای ابری و محیطهای چند مستأجره
- سازمانهایی با بودجه محدود اما نیاز به عملکرد بالا
- پروژههایی که نیاز به یکپارچگی با زیرساخت Ethernet موجود دارند
بهینهسازی و مانیتورینگ: کلید موفقیت
داشتن تجهیزات پیشرفته کافی نیست؛ باید بتوانید عملکرد شبکه را به طور مداوم مانیتور و بهینه کنید. در محیطهای AI، حتی کوچکترین مشکلات شبکه میتوانند تأثیرات بزرگی داشته باشند.
معیارهای کلیدی برای مانیتورینگ
Latency: تاخیر باید به صورت مداوم اندازهگیری شود. در شبکههای InfiniBand، تاخیر باید زیر یک میکروثانیه باقی بماند. برای RoCEv2، هدف کمتر از 5 میکروثانیه است. ابزارهایی مانند iperf3 با پارامترهای RDMA میتوانند برای تست تاخیر استفاده شوند.
Packet Loss: در شبکههای lossless برای AI، نرخ از دست رفتن بسته باید نزدیک به صفر باشد. حتی 0.1 درصد packet loss میتواند عملکرد را تا 50 درصد کاهش دهد. باید counters مربوط به PFC Pause Frames را به دقت مانیتور کرد.
Bandwidth Utilization: در حالت ایدهآل، باید بتوانید از 90-95 درصد پهنای باند لینکها استفاده کنید. اگر utilization پایین است، ممکن است مشکلی در پیکربندی RDMA یا برنامه وجود داشته باشد.
Congestion Events: تعداد رویدادهای ECN marking و PFC pause باید مانیتور شود. افزایش ناگهانی این رویدادها نشاندهنده تراکم در شبکه است.
ابزارهای مانیتورینگ پیشرفته
INT (In-band Network Telemetry): این فناوری اطلاعات دقیق از مسیر عبور بستهها، طول صف بافرها و تاخیر در هر سوئیچ را ارائه میدهد. سوئیچهای مدرن مانند H3C S9855 از INT پشتیبانی میکنند.
NVIDIA UFM (Unified Fabric Manager): برای شبکههای InfiniBand، UFM یک ابزار قدرتمند برای مانیتورینگ، تشخیص عیب و بهینهسازی است. میتواند به طور خودکار مشکلات فیزیکی مانند کابلهای معیوب را شناسایی کند.
Prometheus + Grafana: برای مانیتورینگ متریکهای سطح بالا و ایجاد داشبوردهای سفارشی، ترکیب Prometheus و Grafana بسیار مؤثر است.
تحلیل TCO و بازگشت سرمایه
تصمیمگیری بین InfiniBand و RoCEv2 نباید تنها بر اساس قیمت اولیه باشد، بلکه باید هزینه کل مالکیت (Total Cost of Ownership) در نظر گرفته شود.
مقایسه هزینهای برای کلاستر 256 نودی GPU
| جزء هزینه | InfiniBand (Quantum-2) | RoCEv2 (H3C S9855) |
|---|---|---|
| سوئیچ شبکه | 2.5 میلیون دلار | 1.2 میلیون دلار |
| NIC/HCA | 800 هزار دلار | 600 هزار دلار |
| کابل و ماژول نوری | 400 هزار دلار | 250 هزار دلار |
| پشتیبانی سالانه | 300 هزار دلار/سال | 150 هزار دلار/سال |
| هزینه نیروی انسانی | 200 هزار دلار/سال | 100 هزار دلار/سال |
| TCO 5 ساله | 6.2 میلیون دلار | 3.2 میلیون دلار |
با این حال، InfiniBand مزایای عملکردی دارد که ممکن است این هزینه اضافی را توجیه کند. اگر شبکه بتواند زمان آموزش را 30 درصد کاهش دهد، این به معنای استفاده بهتر از GPUهای گرانقیمت و امکان انجام پروژههای بیشتر در همان بازه زمانی است. برای سازمانهایی که روی GPUهای H100 با قیمت 30000 دلار سرمایهگذاری کردهاند، صرفهجویی 30 درصد در زمان میتواند در کمتر از 18 ماه هزینههای شبکه را جبران کند.
آینده زیرساخت شبکه های هوش مصنوعی
صنعت به سرعت در حال تکامل است. استانداردهای 800G و 1.6T در حال توسعه هستند. NVIDIA اخیراً ConnectX-9 را با پشتیبانی از 800G معرفی کرده است. در سمت Ethernet، کنسرسیوم Ultra Ethernet Consortium در حال کار بر روی استانداردهای جدیدی است که قصد دارد مزایای InfiniBand را به Ethernet بیاورد.
یکی از روندهای مهم، استفاده از هوش مصنوعی برای بهینهسازی خود شبکه است. الگوریتمهای ML میتوانند الگوهای ترافیک را پیشبینی کرده و به صورت پیشگیرانه مسیریابی را تنظیم کنند. همچنین، SmartNICs که قابلیتهای پردازشی را با کارت شبکه ترکیب میکنند، در حال محبوب شدن هستند.
سوالات متداول
1. تفاوت اصلی بین شبکه AI و شبکه سنتی دیتاسنتر چیست؟
شبکههای AI با الگوهای ترافیکی کاملاً متفاوتی مواجه هستند. در دیتاسنترهای سنتی، ترافیک عمدتاً شمال-جنوب است (از سرور به کاربران)، اما در محیطهای AI، ترافیک غالباً شرق-غرب است (بین سرورها). همچنین، بارهای کاری AI نیاز به شبکه lossless با تاخیر بسیار پایین دارند که برای همگامسازی هزاران GPU ضروری است.
2. آیا میتوان شبکه موجود را برای AI ارتقا داد؟
بستگی به معماری موجود دارد. اگر توپولوژی Leaf-Spine دارید، میتوانید با ارتقای سوئیچها به مدلهای پشتیبانیکننده RoCEv2 مانند H3C S9855 و نصب NICهای RDMA، شبکه را برای AI آماده کنید. اما اگر معماری قدیمی Three-Tier دارید، بهتر است شبکه را از ابتدا طراحی مجدد کنید.
3. چگونه میتوان بین InfiniBand و RoCEv2 انتخاب کرد؟
اگر بودجه نامحدود دارید و عملکرد مطلق برایتان حیاتی است، InfiniBand بهترین انتخاب است. اما اگر نیاز به مقیاسپذیری بالا، کاهش هزینه و انعطافپذیری دارید، RoCEv2 گزینه بهتری است. برای اکثر سازمانها، RoCEv2 تعادل خوبی بین عملکرد و هزینه ارائه میدهد.
4. چرا RDMA برای AI اهمیت دارد؟
RDMA با حذف سربار CPU و کاهش تاخیر، عملیات همگامسازی بین GPUها را که قلب یادگیری توزیعشده است، تسریع میکند. بدون RDMA، CPU باید برای هر انتقال داده دخالت کند که هم زمانبر است و هم منابع محاسباتی را هدر میدهد.
5. چه مهارتهایی برای مدیریت شبکه AI نیاز است؟
برای InfiniBand، نیاز به دانش عمیق در مدیریت Subnet Manager، تنظیم Quality of Service و تشخیص عیب در محیطهای اختصاصی دارید. برای RoCEv2، باید با مفاهیم PFC، ECN، DCQCN و تنظیمات lossless Ethernet آشنا باشید. سوان تک خدمات مشاوره و آموزش در این زمینه ارائه میدهد.
6. چگونه عملکرد شبکه AI را مانیتور کنیم؟
باید معیارهای کلیدی مانند تاخیر (Latency)، از دست رفتن بسته (Packet Loss)، رویدادهای PFC Pause و utilization پهنای باند را به طور مداوم پایش کنید. ابزارهایی مانند NVIDIA UFM برای InfiniBand و INT (In-band Network Telemetry) برای Ethernet بسیار مفید هستند.
7. آیا میتوان InfiniBand و RoCEv2 را در یک شبکه ترکیب کرد؟
بله، برخی سازمانها از معماری هیبرید استفاده میکنند. InfiniBand برای اتصال داخل بلوکهای محاسباتی حساس و RoCEv2 برای اتصال بین بلوکها. این کار نیاز به گیتویهای مناسب دارد اما میتواند بهترین از دو دنیا را ارائه دهد.
8. هزینه تقریبی راهاندازی یک کلاستر 256 GPU چقدر است؟
برای شبکه InfiniBand، حدود 3.5-4 میلیون دلار و برای RoCEv2، حدود 2-2.5 میلیون دلار. البته این ارقام بدون هزینه GPUها است و تنها شامل تجهیزات شبکه میشود.
9. چه زمانی باید به 800G ارتقا داد؟
وقتی که GPUهای شما (مانند H200 یا B100 NVIDIA) از NIC 800G پشتیبانی میکنند و بارهای کاری شما به پهنای باند بیشتری نیاز دارند. فعلاً 400G برای اکثر کلاسترها کافی است، اما با رشد اندازه مدلها، 800G ضروری خواهد شد.
10. آیا Ethernet میتواند جایگزین کامل InfiniBand شود؟
در آینده نزدیک، خیر. InfiniBand همچنان در تاخیر مطلق و قابلیتهای In-Network Computing برتر است. اما با ظهور Ultra Ethernet و بهبود RoCEv2، فاصله در حال کاهش است و برای بسیاری از کاربردها، Ethernet مدرن کافی خواهد بود.
جمعبندی و توصیههای نهایی
طراحی زیرساخت شبکه برای هوش مصنوعی یک تصمیم استراتژیک است که تأثیر بلندمدت بر موفقیت پروژههای AI شما خواهد داشت. هیچ راهکار یکاندازه برای همه وجود ندارد و انتخاب بهترین فناوری به نیازهای خاص، بودجه و برنامههای آینده شما بستگی دارد.
برای سازمانهایی که در حال راهاندازی کلاسترهای کوچک تا متوسط (تا 1000 GPU) هستند و به دنبال تعادل بین عملکرد و هزینه میگردند، سوئیچ H3C S9855 با RoCEv2 توصیه میشود. این راهکار با هزینهای منطقی، عملکرد بسیار خوبی ارائه میدهد و با زیرساخت Ethernet موجود سازگار است.
برای مؤسسات تحقیقاتی، شرکتهای بزرگ فناوری و سازمانهایی که بر روی مدلهای زبانی با صدها میلیارد پارامتر کار میکنند، NVIDIA Quantum-2 InfiniBand سرمایهگذاری ارزشمندی است. عملکرد برتر و قابلیتهای SHARP v3 میتوانند زمان آموزش را به طور چشمگیری کاهش دهند و بازگشت سرمایه را تسریع کنند.
بدون توجه به انتخاب شما، کلید موفقیت در طراحی دقیق، پیادهسازی حرفهای و مانیتورینگ مداوم است. سوان تک با سالها تجربه در طراحی و پیادهسازی زیرساختهای AI، میتواند شریک قابل اعتمادی در این مسیر باشد. از مشاوره اولیه تا راهاندازی نهایی و پشتیبانی 24/7، تیم متخصصان ما آماده همراهی با شما هستند.
لینکهای داخلی مرتبط
برای اطلاعات بیشتر درباره مقایسه جامع دو فناوری اصلی شبکه AI، مقاله InfiniBand vs RoCEv2 را مطالعه کنید.
جزئیات فنی و مشخصات کامل پلتفرم NVIDIA Quantum-2 InfiniBand NDR 400G در صفحه محصول موجود است.
برای آشنایی با ویژگیها و قابلیتهای سوئیچ H3C S9855 برای کلاسترهای AI، به صفحه اختصاصی مراجعه نمایید.
محصولات شبکه و زیرساخت AI سوان تک را مشاهده کنید.
برای مشاوره رایگان و دریافت پیشنهاد قیمت سفارشی، با تیم فروش سوان تک تماس بگیرید.
منابع خارجی معتبر
مقاله جامع NVIDIA درباره Networking for Data Centers and the Era of AI اطلاعات ارزشمندی ارائه میدهد.
گزارش تحقیقاتی Juniper Networks با عنوان Designing Data Centers for AI Clusters راهنمای عملی طراحی است.
تجربه Meta در استفاده از RoCE که در مقاله RoCE networks for distributed AI training at scale به اشتراک گذاشته شده، بسیار آموزنده است.