



توضیحات
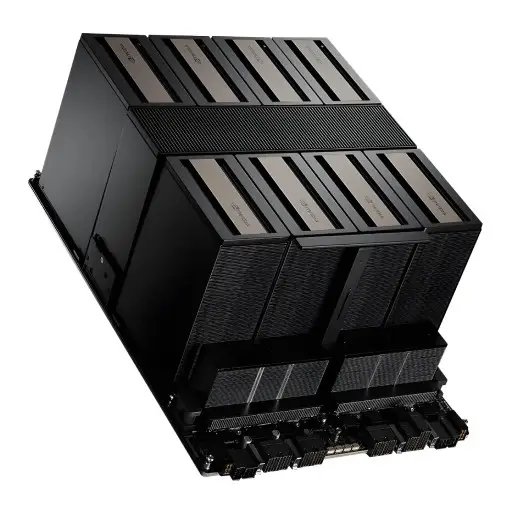
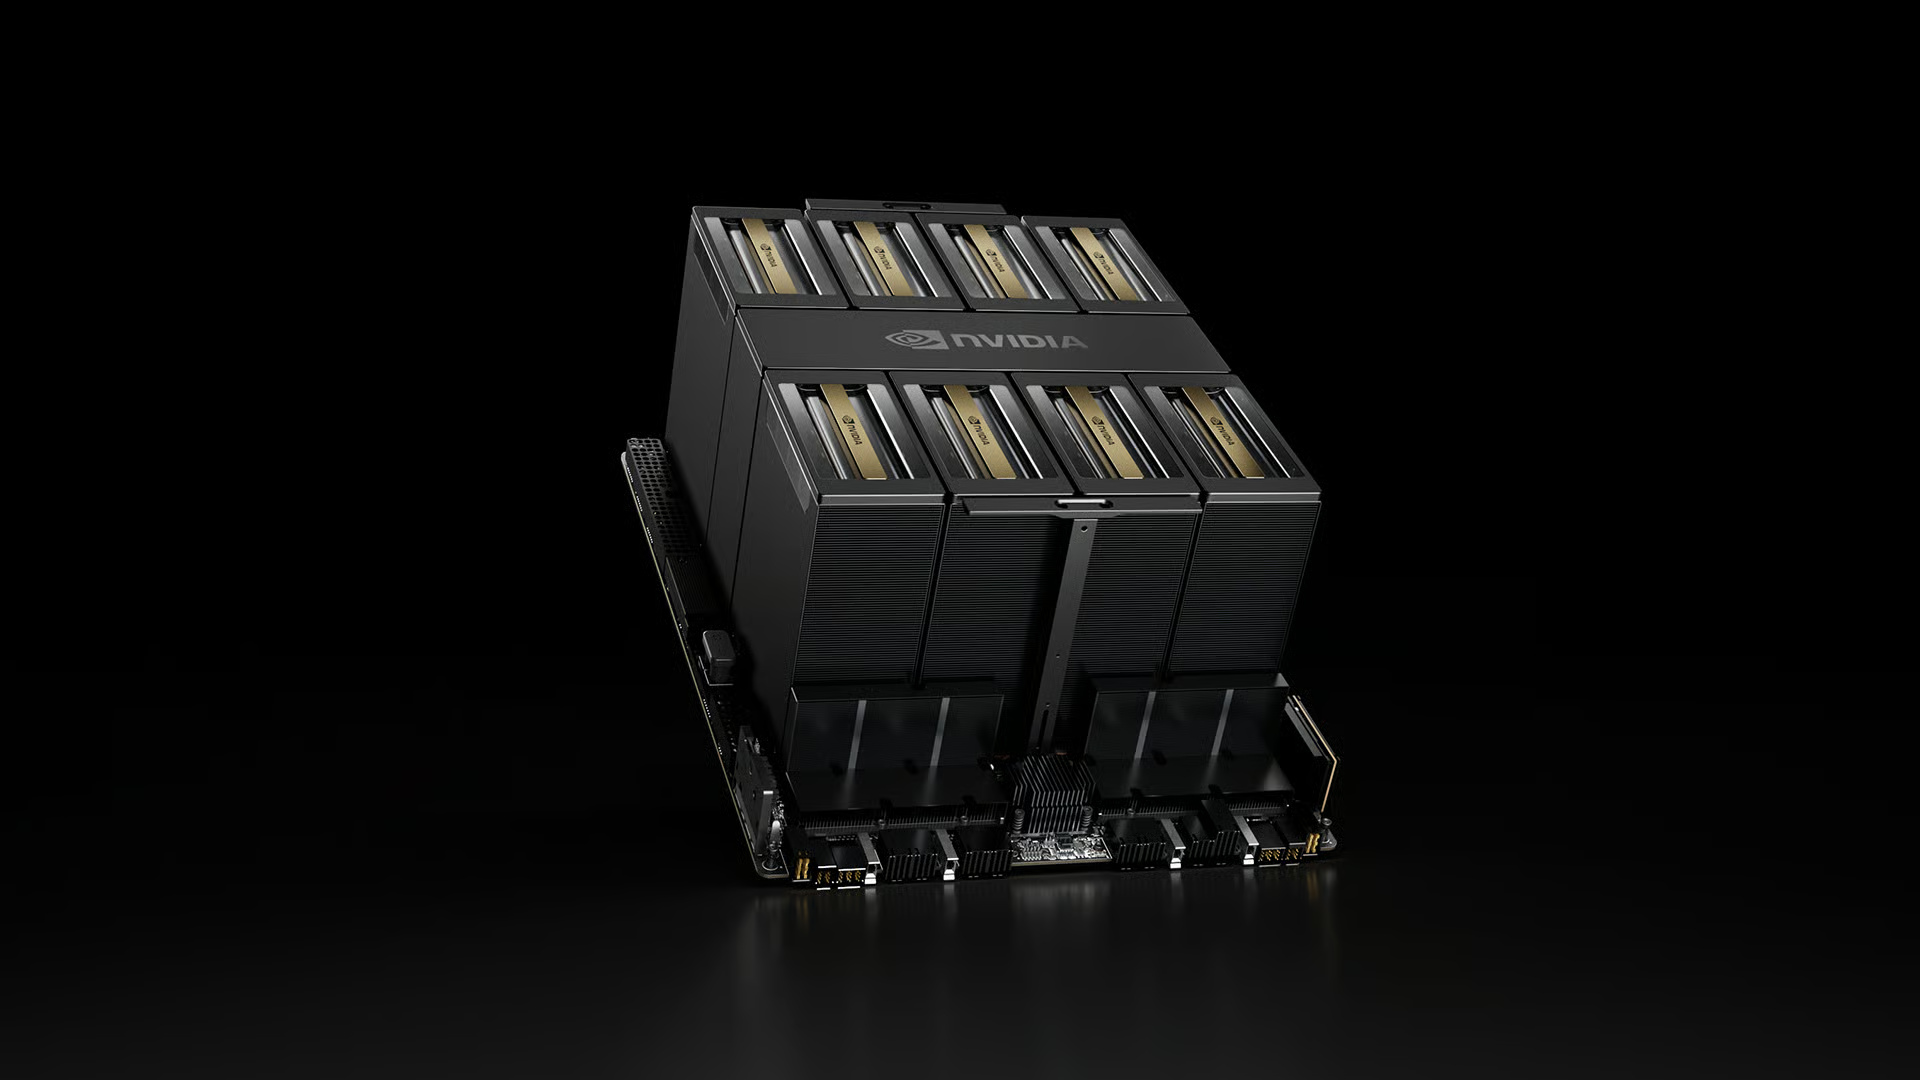
در دنیای امروز که هوش مصنوعی به رکن اصلی نوآوری تکنولوژیکی تبدیل شده، نیاز به زیرساختهای محاسباتی با قدرت، کارایی و مقیاسپذیری بیسابقه بیش از پیش احساس میشود. پلتفرم NVIDIA HGX B200 با 8 پردازنده گرافیکی Blackwell، نماینده نسل جدیدی از سیستمهای محاسباتی است که برای پاسخ به نیازهای فزاینده آموزش و استنتاج مدلهای عظیم هوش مصنوعی طراحی شدهاند.
این پلتفرم با ارائه 144 پتافلاپس قدرت محاسباتی FP4 برای استنتاج و 72 پتافلاپس برای آموزش، عملکردی تا 15 برابر سریعتر در استنتاج زمان واقعی و 3 برابر سریعتر در آموزش مدلها نسبت به نسل قبلی (H100) ارائه میدهد. HGX B200 نه تنها پرسرعتترین، بلکه کارآمدترین پلتفرم هوش مصنوعی موجود در بازار است که با کاهش 93 درصدی مصرف انرژی برای بار کاریهای یکسان، آینده محاسبات سبز را نیز تضمین میکند.

ویژگیهای برجسته پلتفرم NVIDIA HGX B200
معماری انقلابی Blackwell
پلتفرم HGX B200 بر پایه معماری پیشرفته Blackwell ساخته شده که با 208 میلیارد ترانزیستور، بزرگترین تراشه ساختهشده در فرآیند 4 نانومتر TSMC است. هر پردازنده گرافیکی B200 در واقع از دو تراشه محدود به اندازه رتیکل (Reticle-Limited Dies) تشکیل شده که با یک اتصال دهنده 10 ترابایت بر ثانیه به یک واحد یکپارچه تبدیل شدهاند.
این طراحی منحصربهفرد امکان عبور بدون افت سیگنال بین دو تراشه را فراهم میکند و بهطور موثر محدودیتهای فیزیکی ساخت را دور میزند. در نتیجه، B200 قدرت محاسباتی دو برابری نسبت به تراشههای سنتی در همان فضا ارائه میدهد.
8 پردازنده گرافیکی Blackwell B200
پلتفرم HGX B200 مجهز به 8 پردازنده گرافیکی Blackwell B200 است که هر کدام دارای مشخصات زیر هستند:
- حافظه: 180 گیگابایت HBM3e با پهنای باند 8 ترابایت بر ثانیه
- قدرت محاسباتی FP4: 18 پتافلاپس (در کل پلتفرم: 144 پتافلاپس)
- قدرت محاسباتی FP8: 9 پتافلاپس (در کل پلتفرم: 72 پتافلاپس)
- مصرف برق: 1000 وات (TGP)
- اتصال: NVLink نسل پنجم با پهنای باند 1.8 ترابایت بر ثانیه
مجموع حافظه پلتفرم به 1,440 گیگابایت (1.44 ترابایت) میرسد که امکان بارگذاری بزرگترین مدلهای زبانی و هوش مصنوعی را فراهم میکند.

NVLink نسل پنجم و NVSwitch
یکی از مهمترین نوآوریهای HGX B200، استفاده از NVLink نسل پنجم است که پهنای باند GPU-به-GPU را به 1.8 ترابایت بر ثانیه میرساند. این تکنولوژی با استفاده از دو واحد NVSwitch نسل سوم، یک دامنه اتصال یکپارچه برای تمامی 8 پردازنده گرافیکی ایجاد میکند.
پهنای باند کل NVLink در این پلتفرم به 14.4 ترابایت بر ثانیه میرسد که امکان همکاری بدون اصطکاک بین GPU ها را برای آموزش و استنتاج مدلهای عظیم فراهم میکند. این معماری اتصال، تاخیر را به حداقل میرساند و کارایی پردازش موازی را به حداکثر میرساند.
موتور Transformer نسل دوم
پلتفرم HGX B200 مجهز به موتور Transformer نسل دوم است که با پشتیبانی از فرمتهای دقت جدید شامل FP4، FP6 و FP8، انعطافپذیری بیسابقهای در انتخاب تعادل بین دقت و عملکرد ارائه میدهد.
این موتور با استفاده از الگوریتمهای مدیریت محدوده دینامیک پیشرفته و تکنیکهای مقیاسبندی ریز (Micro-Tensor Scaling)، قادر است دقت بالایی را حفظ کرده و در عین حال سرعت آموزش را تا 4 برابر افزایش دهد.
مشخصات فنی جامع
جدول مشخصات پلتفرم HGX B200
| پارامتر | مقدار |
|---|---|
| تعداد GPU | 8 × NVIDIA Blackwell B200 |
| حافظه کل GPU | 1,440 GB (1.44 TB) HBM3e |
| پهنای باند حافظه کل | 64 TB/s |
| قدرت محاسباتی FP4 | 144 پتافلاپس (استنتاج) |
| قدرت محاسباتی FP8 | 72 پتافلاپس (آموزش و استنتاج) |
| قدرت محاسباتی FP16 | 36 پتافلاپس |
| قدرت محاسباتی TF32 | 18 پتافلاپس |
| NVLink GPU-to-GPU | 1.8 TB/s |
| پهنای باند کل NVLink | 14.4 TB/s |
| پهنای باند شبکه | 1.6 TB/s (با ConnectX-7) |
| تعداد NVSwitch | 2 × نسل سوم |
| سازگاری پردازنده | Intel Xeon Scalable نسل 5/4 |
| سازگاری حافظه | DDR5 RDIMM (32 اسلات) |
| واسط GPU | SXM5 |
| مصرف برق کل | ~8,000W (8 GPU × 1,000W) |
جدول قابلیتهای Tensor Core
| فرمت دقت | عملکرد هر GPU | عملکرد کل پلتفرم | بهینه برای |
|---|---|---|---|
| FP4 | 18 PFLOPS | 144 PFLOPS | استنتاج مدلهای بزرگ |
| FP6 | 9 PFLOPS | 72 PFLOPS | استنتاج با دقت متوسط |
| FP8 | 9 PFLOPS | 72 PFLOPS | آموزش و استنتاج عمومی |
| FP16 | 4.5 PFLOPS | 36 PFLOPS | آموزش با دقت بالا |
| TF32 | 2.25 PFLOPS | 18 PFLOPS | آموزش علمی |
| FP64 | ~1 PFLOPS | ~8 PFLOPS | محاسبات علمی HPC |
پشتیبانی از فرمتهای Microscaling
یکی از نوآوریهای کلیدی معماری Blackwell، پشتیبانی از فرمتهای Microscaling جدید است که توسط جامعه علمی تعریف شدهاند:
- MXFP4: دقت 4 بیتی با مدیریت دینامیک محدوده
- MXFP6: دقت 6 بیتی برای تعادل بین کارایی و دقت
- MXFP8: دقت 8 بیتی با پشتیبانی گسترده
این فرمتها با استفاده از تکنیکهای مقیاسبندی ریز، دقت بالاتری نسبت به فرمتهای استاندارد با همان تعداد بیت ارائه میدهند و جایگزینی آسانتری برای مدلهای با دقت بالاتر فراهم میکنند.
عملکرد فوقالعاده در آموزش و استنتاج
مقایسه عملکرد با نسل قبلی
پلتفرم HGX B200 در مقایسه با HGX H100 (نسل قبلی)، پیشرفتهای چشمگیری ارائه میدهد:
| معیار | HGX H100 | HGX B200 | بهبود |
|---|---|---|---|
| سرعت آموزش LLM | 1× (مبنا) | 3× | 3 برابر سریعتر |
| سرعت استنتاج زمان واقعی | 1× (مبنا) | 15× | 15 برابر سریعتر |
| پهنای باند حافظه GPU | 3.35 TB/s | 8 TB/s | 2.4 برابر بیشتر |
| ظرفیت حافظه GPU | 96 GB | 180 GB | 87.5% افزایش |
| کارایی انرژی (استنتاج) | 1× (مبنا) | 15× | 93% کاهش مصرف |
| پهنای باند NVLink | 900 GB/s | 1,800 GB/s | 2 برابر سریعتر |
عملکرد در سناریوهای واقعی
بر اساس آزمونهای MLPerf Inference v5.0، سیستمهای مجهز به HGX B200 عملکرد رهبری در بنچمارکهای هوش مصنوعی کسب کردهاند:
- مدلهای زبانی بزرگ (LLM): سرعت استنتاج تا 15 برابر سریعتر
- مدلهای بینایی ماشین: سرعت پردازش تصویر تا 10 برابر بیشتر
- سیستمهای توصیهگر: پردازش همزمان میلیونها کاربر
- مدلهای چندوجهی: پردازش ترکیبی متن، تصویر و صدا
کاهش چشمگیر هزینههای عملیاتی
استفاده از HGX B200 منجر به کاهش قابلتوجه هزینههای عملیاتی میشود:
- 12 برابر کاهش هزینه TCO (Total Cost of Ownership) برای بار کاریهای استنتاج
- 12 برابر کاهش مصرف انرژی برای همان بار کاری نسبت به H100
- کاهش تعداد سرورهای مورد نیاز برای همان ظرفیت محاسباتی
- صرفهجویی در فضای مرکز داده و هزینههای خنکسازی
کاربردهای پیشرفته پلتفرم HGX B200
آموزش مدلهای زبانی تریلیونپارامتری
پلتفرم HGX B200 بهطور خاص برای آموزش مدلهای زبانی با تریلیونها پارامتر طراحی شده است. با حافظه کل 1.44 ترابایت و پهنای باند NVLink فوقسریع، این پلتفرم میتواند:
- مدلهای GPT-4 کلاس و بزرگتر را آموزش دهد
- زمان آموزش را از ماهها به هفتهها کاهش دهد
- آموزش توزیعشده را در مقیاس چندین رک پشتیبانی کند
- از تکنیکهای موازیسازی مدل، داده و Pipeline استفاده کند
استنتاج زمان واقعی برای خدمات هوش مصنوعی
برای سرویسهای هوش مصنوعی که نیاز به پاسخهای آنی دارند، HGX B200 گزینه ایدهآل است:
- چتباتهای پیشرفته با زمان پاسخ زیر 100 میلیثانیه
- سیستمهای کمک هوشمند برنامهنویسی (AI Coding Assistants)
- دستیارهای صوتی با درک زبان طبیعی پیشرفته
- سیستمهای ترجمه همزمان
- موتورهای جستجوی هوشمند
تولید محتوای چندوجهی
HGX B200 برای تولید انواع محتوا با کیفیت بالا مناسب است:
- تولید تصاویر با کیفیت فتورئالیستیک
- تولید ویدئوهای هوش مصنوعی
- ساخت موسیقی و صدا
- تولید مدلهای سهبعدی
- ایجاد محتوای متنی خلاقانه
محاسبات علمی و تحقیقات پیشرفته
در حوزه محاسبات علمی با کارایی بالا (HPC)، HGX B200 کاربردهای متنوعی دارد:
- شبیهسازیهای دینامیک سیالات محاسباتی (CFD)
- مدلسازی آب و هوا و پیشبینی
- کشف دارو و طراحی مولکولی
- ژنومیک و بیوانفورماتیک
- فیزیک ذرات و نجوم
سیستمهای توصیهگر مقیاس بزرگ
برای پلتفرمهای دیجیتال با میلیونها کاربر:
- سیستمهای توصیه محصول (تجارت الکترونیک)
- توصیه محتوای ویدئویی (پلتفرمهای استریمینگ)
- شخصیسازی تبلیغات
- توصیه موسیقی و پادکست
- شبکههای اجتماعی
زیرساخت شبکه و اتصال
پشتیبانی از ConnectX-7 و BlueField-3
پلتفرم HGX B200 با کارتهای شبکه پیشرفته NVIDIA سازگار است:
- ConnectX-7: کارتهای شبکه 400Gb/s Ethernet یا InfiniBand NDR
- BlueField-3 DPU: واحدهای پردازش داده با قابلیتهای امنیتی پیشرفته
- پهنای باند شبکه کل: تا 1.6 ترابایت بر ثانیه
این سطح از پهنای باند شبکه امکان ساخت خوشههای بزرگ با صدها یا هزاران GPU را فراهم میکند که برای آموزش مدلهای فوقبزرگ ضروری است.
معماری مقیاسپذیر برای رکهای متعدد
HGX B200 میتواند در معماریهای مقیاسپذیر استفاده شود:
- خوشههای چند رکی با صدها GPU
- شبکه Spine-Leaf با پهنای باند بالا
- طراحی Fat-Tree برای ارتباطات کمتأخیر
- اتصال بین مراکز داده برای بار کاریهای توزیعشده جغرافیایی
نوآوریهای سختافزاری و معماری
طراحی دو-دایی (Dual-Die Design)
یکی از نوآوریهای کلیدی B200، استفاده از دو تراشه متصل شده با اتصال دهنده 10TB/s است. این طراحی:
- محدودیت اندازه رتیکل را دور میزند
- تعداد ترانزیستورها را دو برابر میکند
- بدون افت عملکرد در ارتباط بین تراشهها
- امکان تولید GPU های بزرگتر را فراهم میکند
حافظه HBM3e نسل جدید
B200 از جدیدترین نسل حافظه با پهنای باند بالا استفاده میکند:
- ظرفیت: 180GB HBM3e در هر GPU (24GB × 8 استک)
- پهنای باند: 8TB/s در هر GPU
- کارایی انرژی: بهتر از HBM3 و HBM2e
- تاخیر: کمتر برای دسترسی به داده
قابلیت Multi-Instance GPU (MIG)
هر GPU B200 میتواند به 7 نمونه مجزا تقسیم شود، که به اشتراکگذاری امن منابع GPU بین کاربران و برنامههای مختلف کمک میکند:
- هر نمونه MIG: حداکثر 23GB حافظه
- ایزولهسازی کامل بین نمونهها
- مناسب برای محیطهای ابری چندکاربره
- بهرهوری بهینه از منابع GPU
پشتیبانی نرمافزاری جامع
NVIDIA AI Enterprise
پلتفرم HGX B200 بهطور کامل توسط نرمافزار NVIDIA AI Enterprise پشتیبانی میشود:
- کتابخانههای بهینهشده برای Blackwell
- فریمورکهای یادگیری عمیق پیشپیکربندیشده
- ابزارهای مدیریت و نظارت
- پشتیبانی فنی سطح Enterprise
CUDA 12 و بالاتر
پلتفرم با آخرین نسخههای CUDA سازگار است:
- بهینهسازیهای اختصاصی برای معماری Blackwell
- پشتیبانی کامل از فرمتهای دقت جدید
- کتابخانههای cuDNN، cuBLAS و TensorRT
- سازگاری با کدهای موجود
TensorRT-LLM
برای بهینهسازی استنتاج مدلهای زبانی:
- فشردهسازی خودکار مدل
- کوانتیزاسیون هوشمند به FP4/FP6/FP8
- بهینهسازی برای معماری Blackwell
- کاهش زمان استنتاج تا 10 برابر
NeMo Framework
برای آموزش و تنظیم دقیق مدلهای بزرگ:
- قالبهای از پیش آماده برای LLM
- پشتیبانی از موازیسازی مدل
- ابزارهای مدیریت داده
- یکپارچگی با Transformer Engine
راهکارهای خنکسازی
خنکسازی هوایی پیشرفته
سیستمهای مجهز به HGX B200 با خنکسازی هوایی، دارای معماری خنکسازی بهبودیافته هستند:
- طراحی جریان هوای بهینه
- فنهای پرسرعت با کنترل هوشمند
- هیتسینکهای بزرگ با سطح تماس افزایشیافته
- سنسورهای دما در نقاط کلیدی
خنکسازی مایع (Liquid Cooling)
برای تراکم بالا و کارایی بیشتر، گزینه خنکسازی مایع نیز موجود است:
- کاهش 30-40 درصدی مصرف برق خنکسازی
- امکان تراکم بالاتر GPU در هر رک
- کاهش سر و صدا در مرکز داده
- افزایش طول عمر قطعات
صرفهجویی انرژی و پایداری محیطی
کاهش ردپای کربن
HGX B200 با طراحی کارآمد انرژی، به کاهش انتشار کربن کمک میکند:
- 93% کاهش مصرف انرژی برای بار کاریهای استنتاج نسبت به H100
- کاهش شدت انتشار کربن جاسازیشده در مقایسه با نسل قبلی
- کارایی PUE بهتر در مراکز داده
- طول عمر بیشتر و نیاز کمتر به تعویض سختافزار
گزارش کربن محصول (PCF)
NVIDIA برای HGX B200 گزارش جامع ردپای کربن محصول ارائه میدهد که شامل:
- انتشار کربن در تولید
- مصرف انرژی در طول عمر
- بازیافتپذیری قطعات
- راهکارهای کاهش اثرات زیستمحیطی
مقایسه با رقبا و نسلهای قبلی
HGX B200 در مقابل سایر پلتفرمها
| ویژگی | HGX H100 | HGX H200 | HGX B200 | HGX B300 |
|---|---|---|---|---|
| حافظه GPU (کل) | 640GB | 1,128GB | 1,440GB | ~2,304GB |
| پهنای باند حافظه | 26.8TB/s | 35TB/s | 64TB/s | ~96TB/s |
| عملکرد FP8 (کل) | 32 PFLOPS | 32 PFLOPS | 72 PFLOPS | >144 PFLOPS |
| عملکرد FP4 (کل) | – | – | 144 PFLOPS | >288 PFLOPS |
| پهنای باند NVLink | 900GB/s | 900GB/s | 1,800GB/s | 1,800GB/s |
| معماری | Hopper | Hopper | Blackwell | Blackwell Ultra |
| فرآیند ساخت | TSMC 4N | TSMC 4N | TSMC 4NP | TSMC 3N |
مزایای ارتقاء از H100 به B200
سازمانهایی که از H100 به B200 ارتقاء میدهند، مزایای زیر را دریافت میکنند:
- 57% سرعت بیشتر در آموزش مدل
- 15 برابر سرعت بیشتر در استنتاج
- 87.5% حافظه بیشتر برای مدلهای بزرگتر
- 2 برابر پهنای باند بین GPU ها
- 10 برابر صرفهجویی در هزینه برای استقرار خودمیزبانی
راهنمای انتخاب و خرید
چه سازمانهایی باید HGX B200 را انتخاب کنند؟
این پلتفرم برای سازمانهای زیر ایدهآل است:
- شرکتهای فناوری بزرگ که به آموزش LLM های پیشرفته میپردازند
- ارائهدهندگان خدمات ابری که نیاز به بالاترین عملکرد دارند
- مراکز تحقیقاتی و دانشگاهی با پروژههای HPC
- استارتاپهای هوش مصنوعی که به سرعت رشد میکنند
- سازمانهایی با نیاز به استنتاج زمان واقعی مقیاس بزرگ
چه موقع باید از گزینههای دیگر استفاده کرد؟
- بودجه محدود: A100 یا A2 مناسبتر است
- بار کاری متوسط: HGX H100 یا H200 گزینه بهتری است
- استنتاج ساده: GPU های سری A کافی هستند
- محیط Edge: از راهکارهای تخصصی Edge استفاده کنید
نکات مهم قبل از خرید
- نیازهای زیرساخت: مطمئن شوید مرکز داده شما ظرفیت برق و خنکسازی کافی دارد (حدود 10kW per rack)
- سازگاری شبکه: برای عملکرد بهینه، از شبکه InfiniBand NDR یا Ethernet 400GbE استفاده کنید
- نرمافزار: اطمینان حاصل کنید فریمورکهای شما از Blackwell پشتیبانی میکنند
- تیم فنی: داشتن متخصصان DevOps و MLOps ضروری است
چرا از سوان تک خرید کنیم؟
سوان تک بهعنوان تامینکننده معتبر زیرساختهای هوش مصنوعی و IT در ایران:
- مشاوره تخصصی: تیم مهندسی با تجربه برای طراحی زیرساخت
- پشتیبانی 24/7: خدمات فنی و نگهداری در تمام ساعات
- گارانتی معتبر: پوشش کامل و خدمات پس از فروش
- راهکارهای یکپارچه: طراحی کامل سرور، شبکه و ذخیرهسازی
برای دریافت مشاوره رایگان، قیمت و زمان تحویل، با تیم فروش سوان تک تماس بگیرید.
سؤالات متداول
آیا HGX B200 با نرمافزارهای موجود سازگار است؟
بله، HGX B200 با بیشتر فریمورکهای یادگیری عمیق از جمله PyTorch، TensorFlow، JAX و MXNet سازگار است. NVIDIA درایورهای بهینهشده و کتابخانههای CUDA برای Blackwell ارائه میدهد. با این حال، برای استفاده بهینه از قابلیتهای جدید مانند FP4 و موتور Transformer نسل دوم، ممکن است بهروزرسانی کدها لازم باشد.
مصرف برق یک پلتفرم HGX B200 چقدر است؟
یک پلتفرم کامل HGX B200 با 8 GPU حدود 8,000 وات (8kW) برق مصرف میکند. با احتساب سیستمهای خنکسازی و سایر اجزا، یک رک کامل ممکن است تا 12-15kW برق نیاز داشته باشد. برای مراکز داده، طراحی مناسب سیستم توزیع برق و خنکسازی ضروری است.
تفاوت اصلی B200 با GB200 چیست؟
B200 یک پردازنده گرافیکی مستقل است که در پلتفرمهای HGX استفاده میشود. GB200 (Grace Blackwell) یک سوپرچیپ است که یک پردازنده CPU Grace ARM را با دو GPU Blackwell ترکیب میکند. GB200 برای بار کاریهای خاصی که به قدرت CPU بالا نیز نیاز دارند، بهینه است.
چقدر طول میکشد تا HGX B200 تحویل داده شود؟
زمان تحویل بستگی به موجودی و حجم سفارش دارد. بهطور معمول برای سفارشهای استاندارد، زمان تحویل بین 4 تا 12 هفته است. برای سفارشهای سازمانی با حجم بالا، زمان بیشتری ممکن است لازم باشد. سوان تک تلاش میکند سریعترین زمان تحویل ممکن را فراهم کند.
آیا میتوان از HGX B200 برای بار کاریهای غیر هوش مصنوعی استفاده کرد؟
بله، HGX B200 برای انواع بار کاریهای محاسباتی با کارایی بالا (HPC) مناسب است، از جمله شبیهسازیهای علمی، پردازش دادههای بزرگ، تحلیلهای مالی و رندرینگ. با این حال، برای بار کاریهای گرافیکی حرفهای، GPU های سری RTX مناسبتر هستند.
چگونه میتوان از قابلیت MIG استفاده کرد؟
قابلیت Multi-Instance GPU از طریق درایورهای NVIDIA و ابزارهای مدیریت قابل پیکربندی است. میتوانید هر GPU B200 را به حداکثر 7 نمونه مجزا تقسیم کنید، هر کدام با حافظه و محاسبات ایزوله. این قابلیت برای محیطهای ابری، اشتراکگذاری منابع بین تیمها و محیطهای آموزشی بسیار مفید است.
چه فرقی بین معماری Hopper و Blackwell است؟
Blackwell نسل بعدی Hopper است با بهبودهای عمده شامل:
- دو برابر تعداد ترانزیستورها با طراحی دو-دایی
- موتور Transformer نسل دوم با پشتیبانی FP4/FP6
- پهنای باند NVLink دو برابر
- کارایی انرژی 15 برابر بهتر برای استنتاج
- حافظه 87.5% بیشتر
- فرمتهای Microscaling جدید
آیا نیاز به تغییر زیرساخت مرکز داده برای استفاده از B200 است؟
بستگی به وضعیت فعلی دارد. اگر مرکز داده شما از H100 پشتیبانی میکند، تغییرات جزئی لازم است. نکات کلیدی:
- ظرفیت برق کافی (حداقل 15kW per rack)
- سیستم خنکسازی قوی (مایع یا هوایی پیشرفته)
- شبکه با پهنای باند بالا (InfiniBand NDR یا 400GbE)
- سیستم مدیریت حرارت و رطوبت
جمعبندی
پلتفرم NVIDIA HGX B200 با 8 پردازنده گرافیکی Blackwell، نماینده قله فناوری محاسبات هوش مصنوعی در زمان حاضر است. این پلتفرم با ارائه 144 پتافلاپس قدرت محاسباتی FP4، 1.44 ترابایت حافظه HBM3e، و معماری NVLink نسل پنجم، توانایی آموزش و استنتاج مدلهای هوش مصنوعی تریلیونپارامتری را فراهم میکند.
با عملکرد 15 برابر سریعتر در استنتاج زمان واقعی و 3 برابر سریعتر در آموزش نسبت به نسل قبلی، همراه با 93% کاهش مصرف انرژی، HGX B200 نه تنها قدرتمندترین بلکه کارآمدترین پلتفرم هوش مصنوعی موجود است. این ویژگیها آن را برای سازمانهایی که به دنبال ساخت کارخانههای هوش مصنوعی هستند، گزینهای ایدهآل میسازد.
خرید HGX B200 از سوان تک، دسترسی به محصولی اورجینال با گارانتی معتبر، مشاوره تخصصی برای طراحی زیرساخت، و پشتیبانی جامع 24/7 را تضمین میکند. برای آغاز سفر خود به سوی آینده هوش مصنوعی، امروز با تیم سوان تک تماس بگیرید.
محصولات مرتبط


نقد و بررسیها
پاککردن فیلترهاهنوز بررسیای ثبت نشده است.