

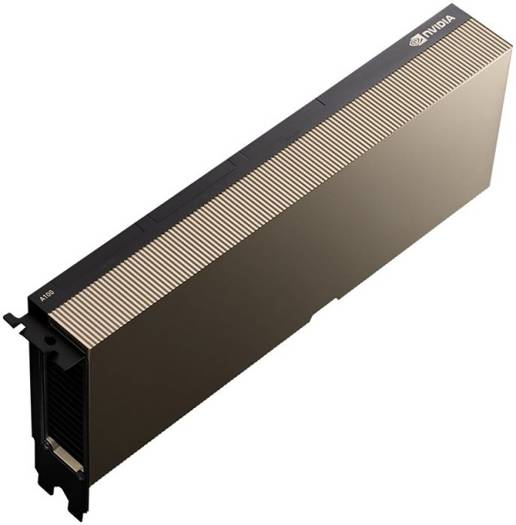
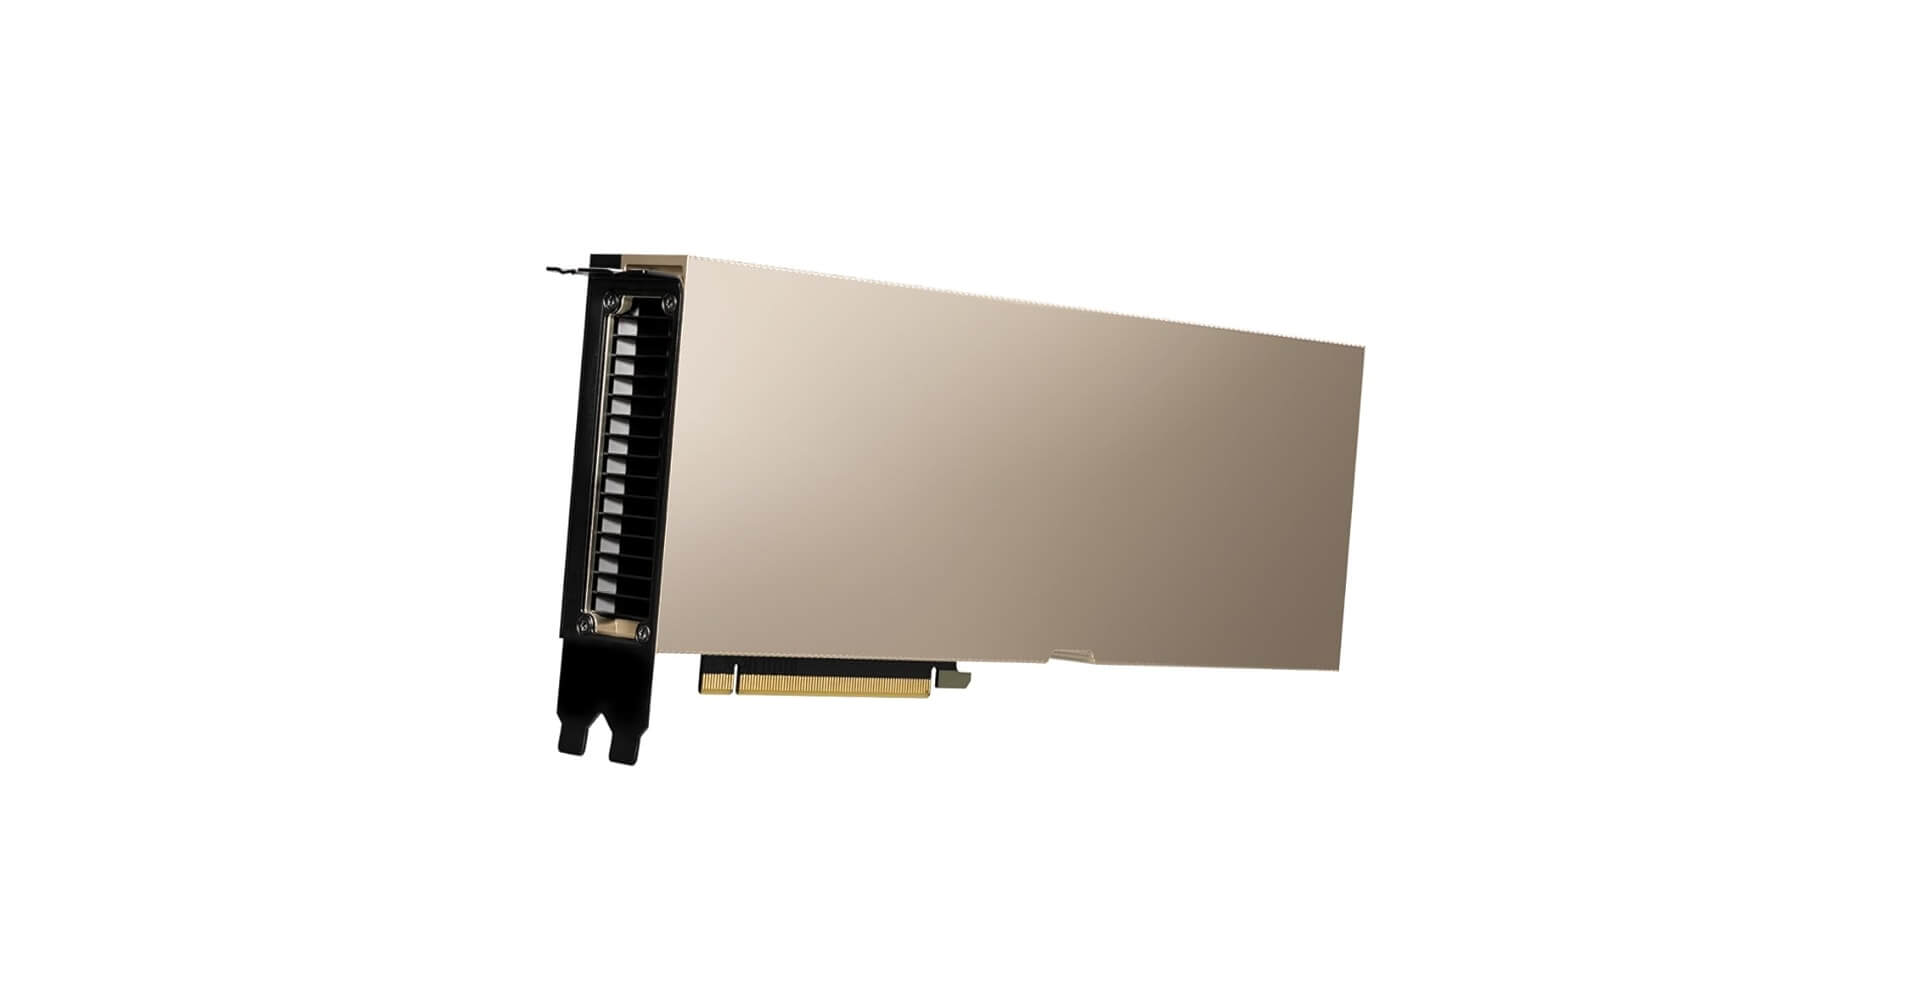
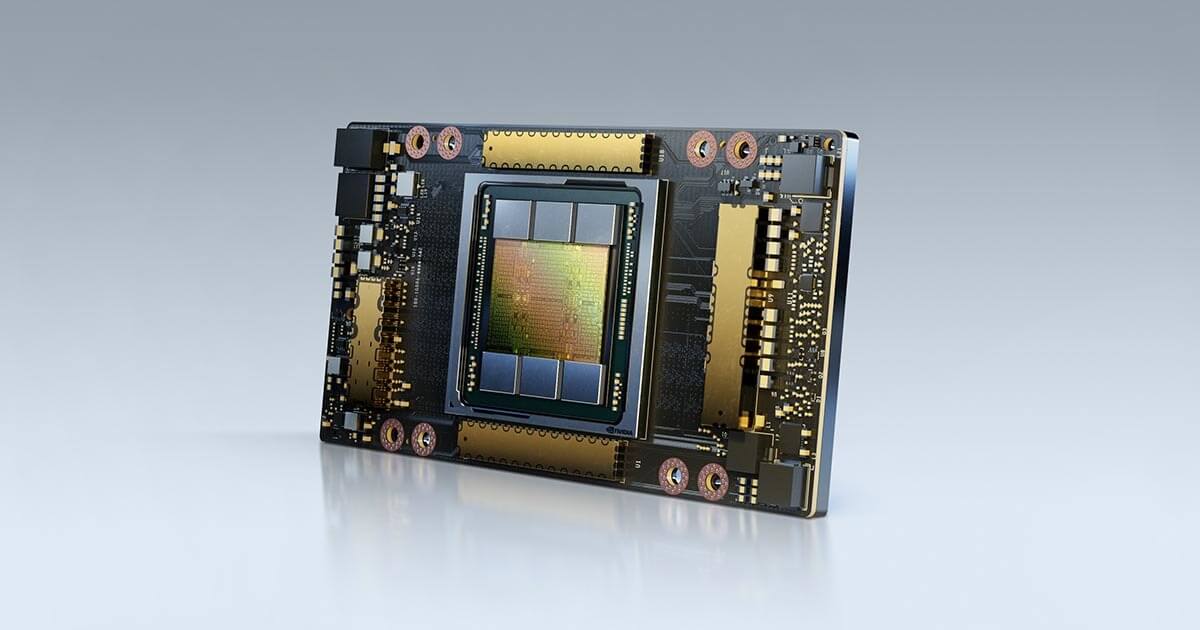
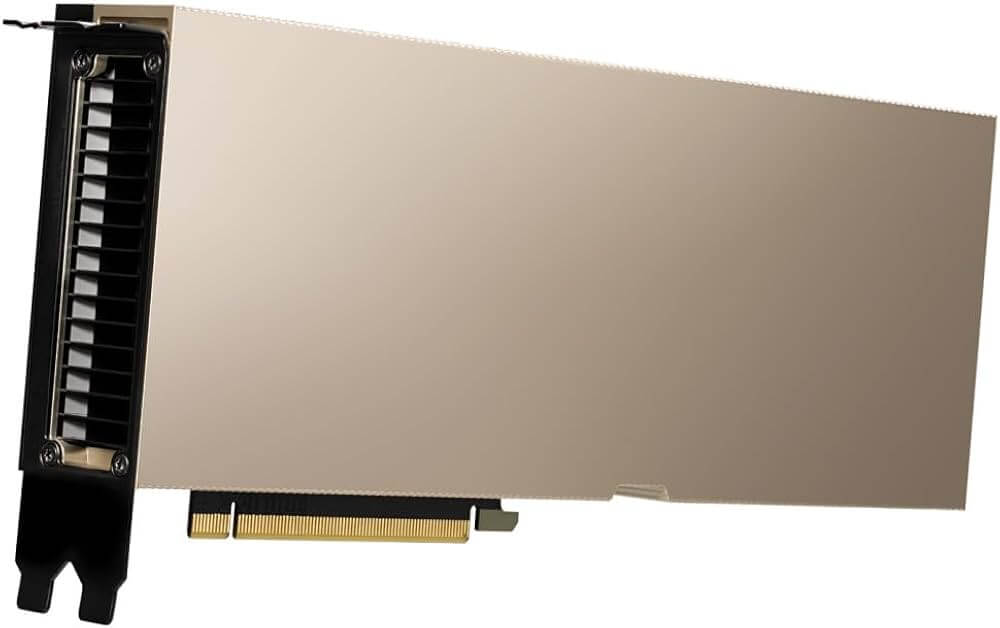


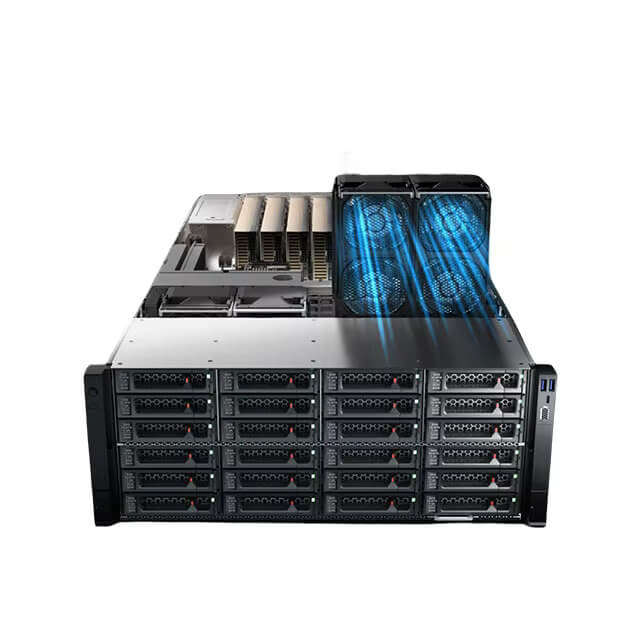
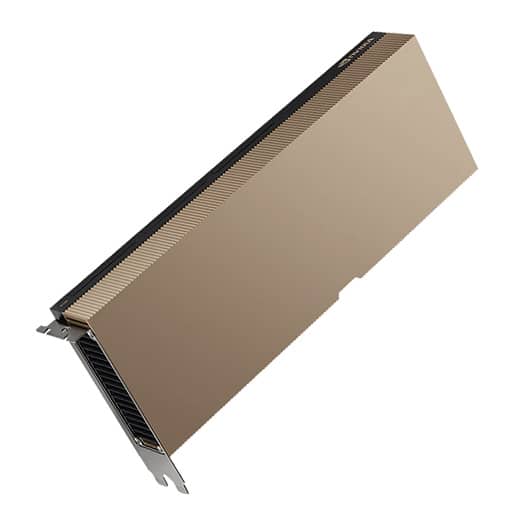
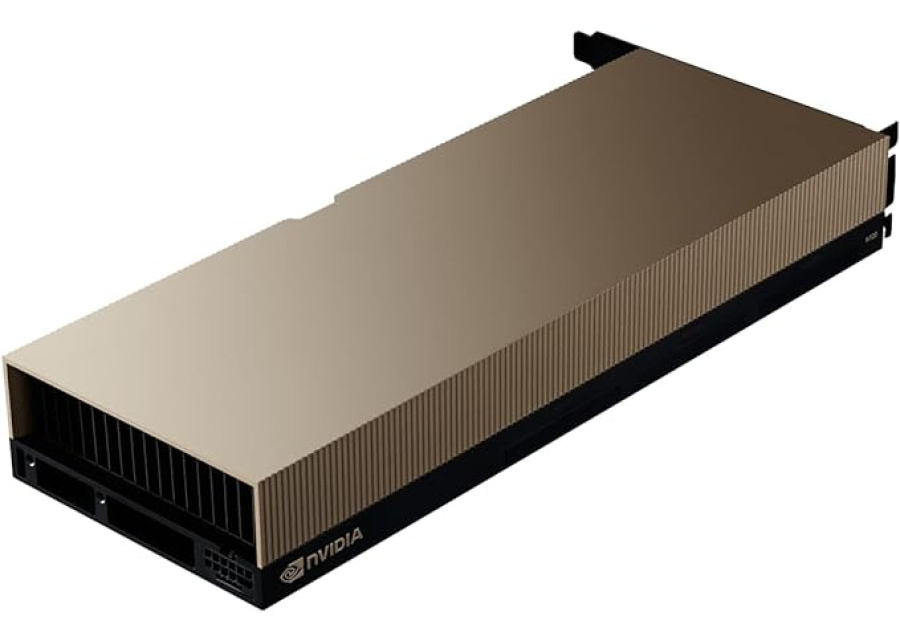
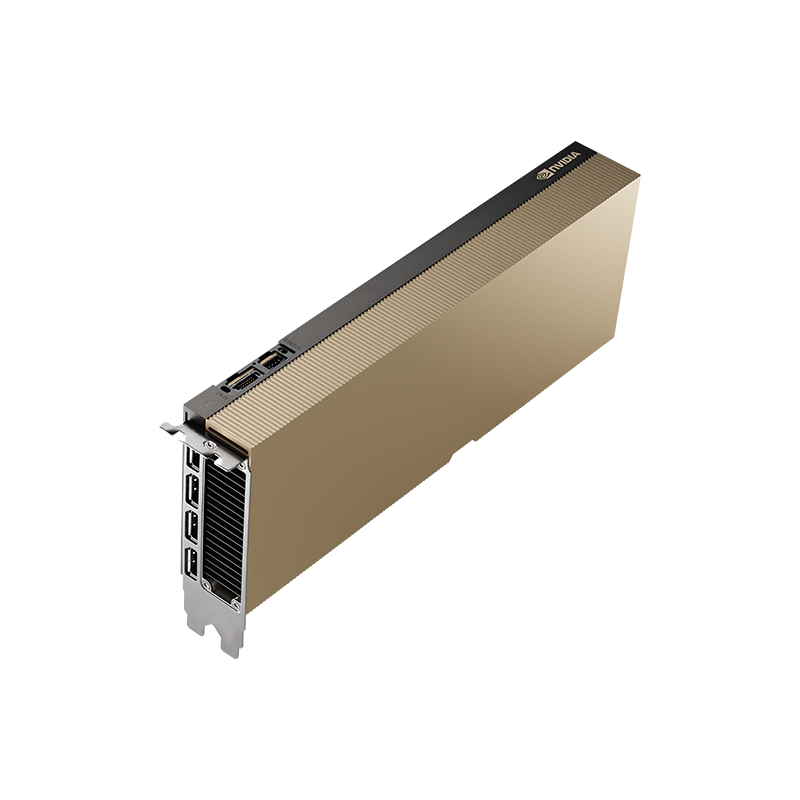
کارت گرافیک انویدیا مدل A100 ظرفیت ۸۰ گیگابایت PCIe
معماری
GPU
NVIDIA Ampere
تراشه
GPU
GA100
فرآیند ساخت
۷ نانومتر TSMC
تعداد ترانزیستور
۵۴.۲ میلیارد
اندازه تراشه
۸۲۶ میلیمتر مربع
قابلیت محاسباتی CUDA
۸.۰
قیمت :
3,587,500,000 تومان
گفتگو با پشتییان (پشتیبان آنلاین است)
قیمتها بر اساس نرخ دلار متغیر می باشد.
برای اطلاع از نحوه تحویل کالا تماس بگیرید.
توضیحات
NVIDIA A100 80GB Tensor Core GPU انویدیا A100 – قدرتمندترین پردازنده گرافیک مرکز داده جهان
معرفی محصول
NVIDIA A100 80GB Tensor Core GPU در راس پیشرفتهترین پردازندههای گرافیکی مراکز داده قرار دارد و شتابدهی بیسابقهای را برای هوش مصنوعی، یادگیری ماشین، تحلیل داده و محاسبات با کارایی بالا فراهم میکند. این محصول بر پایه معماری انقلابی NVIDIA Ampere ساخته شده و نسبت به نسل قبلی تا ۲۰ برابر عملکرد بهتر ارائه میدهد. همچنین سریعترین پهنای باند حافظه در دنیا را با بیش از ۲ ترابایت بر ثانیه در اختیار شما قرار میدهد.
با ۸۰ گیگابایت حافظه HBM2e، هستههای تنسور نسل سوم و فناوری پیشگامانه Multi-Instance GPU (MIG) که امکان تقسیمبندی به ۷ نمونه مستقل GPU را میدهد، A100 80GB برای سنگینترین مدلهای هوش مصنوعی، عظیمترین مجموعه دادهها و پیچیدهترین شبیهسازیهای علمی طراحی شده است.
چه در حال آموزش مدلهای زبانی بزرگ باشید، چه استنتاج هوش مصنوعی لحظهای انجام دهید، چه شبیهسازیهای دینامیک مولکولی داشته باشید یا تحلیل داده در مقیاس پتابایت انجام دهید، A100 80GB عملکردی استثنایی ارائه میدهد که زمان تحقیقات و استقرار محصولات را متحول میکند.
ویژگیهای کلیدی و فناوریهای پیشرفته
۱. معماری NVIDIA Ampere
انویدیا A100 با معماری Ampere انویدیا که جهشی بزرگ در محاسبات GPU محسوب میشود، کار میکند:
- هستههای تنسور نسل سوم: ارائه ۳۱۲ ترافلاپس با دقت TF32 و تا ۶۲۴ ترافلاپس با FP16
- عملکرد پیشرفته FP64: معرفی هستههای تنسور دقت دوگانه برای بارهای کاری HPC
- پشتیبانی از Structural Sparsity: افزایش عملکرد تا ۲ برابر برای مدلهای پراکنده هوش مصنوعی
- محاسبات چند دقتی: پشتیبانی از FP64، FP32، TF32، FP16، BF16 و INT8 در یک شتابدهنده
۲. حافظه عظیم و پهنای باند
- ۸۰ گیگابایت حافظه HBM2e: دو برابر ظرفیت نسخه ۴۰ گیگابایتی برای بزرگترین مدلهای هوش مصنوعی
- پهنای باند ۲,۰۳۹ گیگابایت بر ثانیه (SXM4): سریعترین پهنای باند حافظه GPU در جهان
- رابط حافظه ۵۱۲۰ بیتی: گذرگاه فوقالعاده پهن برای حداکثر انتقال داده
- بازده استفاده از DRAM ۹۵ درصد: کارآمدترین حافظه در صنعت
- پهنای باند ۱.۷ برابر بالاتر از نسل قبلی V100
۳. فناوری Multi-Instance GPU (MIG)
قابلیتی انقلابی که استفاده از GPU را به حداکثر میرساند:
- تقسیم به ۷ نمونه مستقل GPU: هر کدام با منابع اختصاصی
- جداسازی سختافزاری کامل: حافظه، کش و هستههای محاسباتی جداگانه برای هر نمونه
- ۱۰ گیگابایت در هر نمونه MIG: دو برابر نسخه ۴۰ گیگابایتی A100 (۵ گیگابایت در هر نمونه)
- بهرهوری ۷ برابر بیشتر: بهینهسازی استفاده از زیرساخت در بارهای کاری مختلف
- تضمین کیفیت سرویس (QoS): عملکرد قابل پیشبینی برای هر برنامه
- پشتیبانی از Kubernetes، کانتینرها و مجازیسازی: آماده برای استقرار سازمانی
۴. اتصالدهندههای نسل جدید
- NVLink نسل سوم: پهنای باند دوطرفه ۶۰۰ گیگابایت بر ثانیه (۲ برابر سریعتر از نسل قبل)
- PCIe Gen 4: توان عبور ۶۴ گیگابایت بر ثانیه برای سازگاری گسترده
- پشتیبانی از NVSwitch: اتصال تا ۱۶ GPU A100 با ۶۰۰ گیگابایت بر ثانیه برای مقیاسپذیری عظیم
- NVLink Bridge: اتصال ۲ GPU PCIe برای عملکرد بهتر
- NVIDIA Magnum IO SDK: عملیات I/O بهینهشده برای بارهای کاری دادهمحور
۵. تواناییهای محاسباتی پیشرفته
- ۶,۹۱۲ هسته CUDA: قدرت پردازش موازی عظیم
- ۴۳۲ هسته تنسور نسل سوم: شتابدهی تخصصی هوش مصنوعی
- تا ۱,۲۴۸ عملیات تراپس INT8: عملکرد پیشتاز در استنتاج
- ۱۹.۵ ترافلاپس هسته تنسور FP64: انقلابی برای کاربردهای HPC
- شتابدهی Sparsity: افزایش خودکار عملکرد تا ۲ برابر برای مدلهای سازگار
مشخصات فنی کامل
معماری و پردازنده
| مشخصات | جزئیات |
|---|---|
| معماری GPU | NVIDIA Ampere |
| تراشه GPU | GA100 |
| فرآیند ساخت | ۷ نانومتر TSMC |
| تعداد ترانزیستور | ۵۴.۲ میلیارد |
| اندازه تراشه | ۸۲۶ میلیمتر مربع |
| قابلیت محاسباتی CUDA | ۸.۰ |
عملکرد محاسباتی
| دقت محاسباتی | A100 80GB SXM | A100 80GB PCIe |
|---|---|---|
| FP64 | ۹.۷ ترافلاپس | ۹.۷ ترافلاپس |
| هسته تنسور FP64 | ۱۹.۵ ترافلاپس | ۱۹.۵ ترافلاپس |
| FP32 | ۱۹.۵ ترافلاپس | ۱۹.۵ ترافلاپس |
| هسته تنسور TF32 | ۱۵۶ / ۳۱۲* ترافلاپس | ۱۵۶ / ۳۱۲* ترافلاپس |
| هسته تنسور BFLOAT16 | ۳۱۲ / ۶۲۴* ترافلاپس | ۳۱۲ / ۶۲۴* ترافلاپس |
| هسته تنسور FP16 | ۳۱۲ / ۶۲۴* ترافلاپس | ۳۱۲ / ۶۲۴* ترافلاپس |
| هسته تنسور INT8 | ۶۲۴ / ۱,۲۴۸* تراپس | ۶۲۴ / ۱,۲۴۸* تراپس |
| هسته تنسور INT4 | ۱,۲۴۸ / ۲,۴۹۶* تراپس | ۱,۲۴۸ / ۲,۴۹۶* تراپس |
*با Structural Sparsity
مشخصات حافظه
| ویژگی | مشخصات |
|---|---|
| ظرفیت حافظه | ۸۰ گیگابایت HBM2e |
| رابط حافظه | ۵۱۲۰ بیت |
| پهنای باند حافظه (SXM) | ۲,۰۳۹ گیگابایت بر ثانیه |
| پهنای باند حافظه (PCIe) | ۱,۹۳۵ گیگابایت بر ثانیه |
| فرکانس حافظه | ۱۵۹۳ مگاهرتز (۳۱۸۶ مگاهرتز موثر) |
| پشتیبانی ECC | بله (همیشه فعال) |
| کش L2 | ۴۰ مگابایت |
مشخصات هستهها
| جزء | تعداد |
|---|---|
| هستههای CUDA | ۶,۹۱۲ |
| هستههای تنسور (نسل ۳) | ۴۳۲ |
| پردازندههای جریانی (SM) | ۱۰۸ |
| واحدهای نگاشت بافت | ۴۳۲ |
| واحدهای خروجی رندر | ۱۶۰ |
| هستههای Ray Tracing | ندارد (متمرکز بر محاسبات) |
فرکانسهای ساعت
- فرکانس پایه: ۱,۰۶۵ مگاهرتز
- فرکانس Boost: ۱,۴۱۰ مگاهرتز
- فرکانس حافظه: ۱,۵۹۳ مگاهرتز
اتصالات و ورودی/خروجی
| رابط | مشخصات |
|---|---|
| نسل PCIe | نسل ۴ x16 |
| پهنای باند PCIe | ۶۴ گیگابایت بر ثانیه (دوطرفه) |
| نسخه NVLink | نسل سوم |
| پهنای باند NVLink | ۶۰۰ گیگابایت بر ثانیه (۱۲ لینک) |
| لینکهای NVLink | ۱۲ |
| خروجی تصویر | ندارد (GPU محاسباتی) |
توان و حرارت
| مشخصات | PCIe | SXM4 |
|---|---|---|
| TDP | ۳۰۰ وات | ۴۰۰ وات*** |
| حداکثر توان مصرفی | ۳۰۰ وات | ۵۰۰ وات (پیکربندی CTS) |
| کانکتور برق | ۸ پین EPS | ماژول SXM |
| خنککننده | هوایی (دو اسلات) یا مایع (تک اسلات) | خنککننده فعال لازم |
| دمای کارکرد | ۰ تا ۵۰ درجه سانتیگراد | ۰ تا ۵۰ درجه سانتیگراد |
***TDP استاندارد ۴۰۰ وات؛ نسخه CTS تا ۵۰۰ وات را پشتیبانی میکند
ابعاد فیزیکی
| فرم فکتور | ابعاد | پهنای اسلات |
|---|---|---|
| PCIe خنککاری هوایی | ۲۶۷ × ۱۱۲ میلیمتر | دو اسلاته |
| PCIe خنککاری مایع | ۲۶۷ × ۱۱۲ میلیمتر | تک اسلاته |
| ماژول SXM4 | ماژول اختصاصی | – (برد سرور) |
| وزن (PCIe) | حدود ۲ کیلوگرم | – |
پروفایلهای Multi-Instance GPU (MIG)
A100 80GB از پیکربندیهای مختلف MIG پشتیبانی میکند:
| پروفایل | نمونههای GPU | حافظه هر نمونه | محاسبات هر نمونه |
|---|---|---|---|
| ۷ عدد ۱g.10gb | ۷ | ۱۰ گیگابایت | ۱/۷ GPU |
| ۴ عدد ۲g.20gb | ۴ | ۲۰ گیگابایت | ۲/۷ GPU |
| ۲ عدد ۳g.40gb | ۲ | ۴۰ گیگابایت | ۳/۷ GPU |
| ۱ عدد ۷g.80gb | ۱ | ۸۰ گیگابایت | GPU کامل |
| پیکربندیهای ترکیبی | سفارشی | متغیر | متغیر |
عملکرد واقعی و بنچمارکها
عملکرد آموزش یادگیری عمیق
تا ۳ برابر سریعتر در آموزش بزرگترین مدلها
- مدل DLRM (توصیهگر یادگیری عمیق):
- V100 با ۳۲ گیگابایت (FP16، بچ ۳۲): مبنا
- A100 با ۴۰ گیگابایت (FP16، بچ ۳۲): ۲ برابر سریعتر
- A100 با ۸۰ گیگابایت (FP16، بچ ۴۸): ۳ برابر سریعتر
عملکرد استثنایی در مدلهای زبانی
- Fine-Tuning مدل BERT-Large: ۲۰ برابر سریعتر از V100
- مدلهای سبک GPT-3: تا ۳ برابر توان عملیاتی بیشتر از A100 با ۴۰ گیگابایت
- ترنسفورمرهای بینایی: بهبود ۲.۵ برابری نسبت به نسل قبل
عملکرد استنتاج هوش مصنوعی
تا ۲۴۹ برابر سریعتر از CPU
- استنتاج BERT-Large:
- دو عدد Xeon Gold 6240 با فرکانس ۲.۶ گیگاهرتز (FP32، بچ ۱۲۸): مبنا
- V100 (INT8، بچ ۲۵۶، TensorRT): ۲۰۰ برابر سریعتر
- A100 با ۴۰ گیگابایت (INT8 + Sparsity، بچ ۲۵۶): ۲۴۵ برابر سریعتر
- A100 با ۸۰ گیگابایت (INT8 + Sparsity، بچ ۲۵۶): ۲۴۹ برابر سریعتر
برتری در استنتاج لحظهای
- تشخیص گفتار RNN-T: ۱.۲۵ برابر سریعتر از A100 با ۴۰ گیگابایت
- بینایی کامپیوتری: تا ۷ برابر توان عملیاتی با MIG
- پردازش زبان طبیعی: تاخیر زیر یک میلیثانیه برای بسیاری از مدلها
محاسبات با کارایی بالا (HPC)
جهش ۱۱ برابری عملکرد در ۴ سال
میانگین هندسی افزایش سرعت برنامهها (از P100 به A100):
- دینامیک مولکولی (AMBER، NAMD): ۸ تا ۱۰ برابر سریعتر
- شیمی محاسباتی (Quantum Espresso، VASP): ۹ تا ۱۲ برابر سریعتر
- دینامیک سیالات محاسباتی (GROMACS): ۱۱ برابر سریعتر
- شبیهسازی آبوهوا (WRF): ۷ برابر سریعتر
A100 با ۸۰ گیگابایت در برابر ۴۰ گیگابایت برای HPC
- Quantum Espresso: تا ۱.۸ برابر سریعتر با مجموعه دادههای بزرگتر
- علم مواد: ۱.۵ تا ۲ برابر بهبود توان عملیاتی
- تصویربرداری لرزهای: ۱.۶ برابر پردازش سریعتر
عملکرد تحلیل داده
۲ برابر سریعتر در تحلیل داده کلان
- بنچمارک GPU-BDB (۳۰ کوئری تحلیلی روی ۱۰ ترابایت داده):
- V100 با ۳۲ گیگابایت: مبنا
- A100 با ۴۰ گیگابایت: ۱.۷ برابر سریعتر
- A100 با ۸۰ گیگابایت: ۲ برابر سریعتر
- شتابدهنده RAPIDS برای Apache Spark: ۵ تا ۱۰ برابر سریعتر از خوشههای CPU
رهبری در بنچمارک MLPerf
NVIDIA A100 بهطور مداوم بالاترین رتبهها را در MLPerf کسب میکند:
- آموزش: عملکرد رکوردشکن در تمام بنچمارکها
- استنتاج: توان عملیاتی و تاخیر پیشتاز در صنعت
- Edge: عملکرد به ازای وات استثنایی
کاربردهای واقعی و موارد استفاده صنعتی
هوش مصنوعی و یادگیری ماشین
مدلهای زبانی بزرگ (LLM)
- آموزش مدلهای سبک GPT: رسیدگی به مدلهایی با صدها میلیارد پارامتر
- BERT و انواع ترنسفورمرها: تنظیم دقیق و آموزش تسریعشده
- هوش مصنوعی مولد: قدرتدهنده به مدلهای GPT-4، Claude، Llama و Mistral
- نمونه واقعی: OpenAI از A100 برای توسعه ChatGPT و DALL-E استفاده میکند
بینایی کامپیوتری
- تشخیص و بخشبندی اشیا: پردازش لحظهای در مقیاس بزرگ
- طبقهبندی تصویر: پردازش میلیونها تصویر در ساعت
- خودروهای خودران: آموزش مدلهای ادراک و تصمیمگیری
- تصویربرداری پزشکی: تشخیص سرطان، بخشبندی اندام، کمک تشخیصی
پردازش زبان طبیعی
- ترجمه ماشینی: ترجمه چندزبانه لحظهای
- تحلیل احساسات: پردازش دادههای رسانههای اجتماعی در مقیاس عظیم
- سیستمهای پرسش و پاسخ: قدرتدهنده به چتباتهای هوشمند و دستیارها
- تولید متن: ساخت محتوای شبیه انسان برای کاربردهای مختلف
سیستمهای پیشنهاددهنده
- تجارت الکترونیک: پیشنهادهای شخصیسازیشده محصول
- پلتفرمهای استریمینگ: پیشنهاد محتوا (نتفلیکس، اسپاتیفای)
- رسانههای اجتماعی: پیشنهاد دوست و انتخاب محتوا
- نمونه واقعی: متا از A100 برای مدلهای پیشنهاددهنده فیسبوک/اینستاگرام استفاده میکند
تحقیقات علمی و محاسبات با کارایی بالا
علوم زیستی و کشف دارو
- دینامیک مولکولی: شبیهسازی تاخوردگی پروتئین و تعامل دارو
- ژنومیکس: تسریع توالییابی و تحلیل DNA
- کشف دارو: غربالگری مجازی میلیونها ترکیب
- تحقیقات کووید-۱۹: توسعه واکسن و تحلیل واریانتها
- نمونه واقعی: فایزر از GPUهای A100 برای توسعه داروی کووید-۱۹ استفاده کرد
علم مواد
- شیمی کوانتومی: محاسبات DFT برای مواد جدید
- نانومواد: طراحی باتریها و نیمههادیهای نسل بعدی
- شبیهسازی مواد: پیشبینی خواص قبل از نمونهسازی فیزیکی
علوم اقلیمی و پیشبینی آبوهوا
- مدلسازی آبوهوا: پیشبینی الگوهای بلندمدت اقلیمی
- پیشبینی هوا: پیشبینیهای با وضوح بالا و دقت بهتر
- شبیهسازی اقیانوس: مدلسازی جریانهای اقیانوسی و اکوسیستمهای دریایی
- نمونه واقعی: NOAA از A100 برای مدلهای پیشبینی طوفان استفاده میکند
اخترفیزیک و کیهانشناسی
- تشکیل کهکشان: شبیهسازی میلیاردها سال تکامل کیهانی
- تشخیص امواج گرانشی: پردازش داده از رصدخانههای LIGO
- کشف سیاره فراخورشیدی: تحلیل دادههای تلسکوپ برای تشخیص سیاره
- نمونه واقعی: سرن از A100 برای شبیهسازیهای فیزیک ذرات استفاده میکند
سازمانی و رایانش ابری
ارائهدهندگان سرویس ابری
- GPU بهصورت سرویس: AWS، Azure، Google Cloud نمونههای A100 ارائه میدهند
- محیطهای چندمستاجر: MIG امکان اشتراکگذاری کارآمد منابع را فراهم میکند
- بارهای کاری کانتینری: هماهنگی GPU بومی Kubernetes
- مثال: نمونههای AWS EC2 P4d با A100 80GB کار میکنند
خدمات مالی
- معامله الگوریتمی: تحلیل و پیشبینی لحظهای بازار
- مدیریت ریسک: شبیهسازیهای مونت کارلو برای بهینهسازی پرتفو
- تشخیص تقلب: نظارت لحظهای تراکنشها با هوش مصنوعی
- امتیازدهی اعتباری: مدلهای یادگیری ماشین پیشرفته برای تصمیمگیری وام
مخابرات
- بهینهسازی شبکه ۵G: مدیریت شبکه مبتنی بر هوش مصنوعی
- پردازش سیگنال: تحلیل لحظهای سیگنالهای RF
- نگهداری پیشبینانه: جلوگیری از قطعیهای شبکه با یادگیری ماشین
رسانه و سرگرمی
جلوههای ویژه و انیمیشن
- رندرینگ Ray Tracing: CGI فوقواقعگرایانه برای فیلمها
- انیمیشن کاراکتر: حرکتنمایی با کمک هوش مصنوعی
- تولید مجازی: رندرینگ لحظهای برای صحنههای LED
- نمونه واقعی: Industrial Light & Magic از A100 برای جلوههای ویژه جنگ ستارگان استفاده میکند
پردازش ویدیو
- ارتقای تصویر با هوش مصنوعی: بهبود کیفیت ویدیو از SD/HD به ۴K/۸K
- نظارت بر محتوا: تشخیص خودکار محتوای نامناسب
- کدگذاری ویدیو: رمزنگاری شتابدهندهشده سختافزاری
بهداشت و درمان و بیوتکنولوژی
تصویربرداری پزشکی
- تحلیل MRI/CT Scan: تشخیص خودکار و شناسایی ناهنجاری
- هوش مصنوعی رادیولوژی: کمک به رادیولوژیستها برای تشخیصهای سریعتر و دقیقتر
- آسیبشناسی: تحلیل اسلاید دیجیتال برای تشخیص سرطان
- نمونه واقعی: کلینیک مایو از A100 برای تشخیص مبتنی بر هوش مصنوعی استفاده میکند
پزشکی دقیق
- درمان شخصیسازیشده: تنظیم درمان بر اساس پروفایل ژنتیکی
- بهینهسازی آزمایش بالینی: شناسایی سریعتر نامزدهای مناسب
- کشف بیومارکر: یافتن اهداف تشخیصی و درمانی جدید
خودروهای خودران و رباتیک
خودروهای خودران
- ادراک: تشخیص اشیا و درک صحنه لحظهای
- برنامهریزی مسیر: محاسبه مسیرهای بهینه در محیطهای پیچیده
- شبیهسازی: آموزش مدلها در محیطهای مجازی قبل از آزمایش جادهای
- نمونه واقعی: تسلا و Waymo از A100 برای آموزش سیستمهای خودران استفاده میکنند
رباتیک صنعتی
- دستکاری رباتیک: آموزش رباتها برای کارهای مونتاژ پیچیده
- اتوماسیون انبار: بهینهسازی عملیات انتخاب و مرتبسازی
- بازرسی کیفیت: تشخیص نقص با هوش مصنوعی در تولید
امنیت سایبری
- تشخیص تهدید: تحلیل لحظهای ترافیک شبکه
- تحلیل بدافزار: شناسایی و طبقهبندی کد مخرب
- تشخیص ناهنجاری: شناسایی الگوهای غیرعادی در رفتار سیستم
- رمزنگاری: تسریع عملیات رمزگذاری/رمزگشایی
زبان طبیعی و هوش مصنوعی مکالمهای
- دستیارهای مجازی: قدرتدهنده به بکاند Alexa، Siri، Google Assistant
- رباتهای خدمات مشتری: مدیریت میلیونها مکالمه همزمان
- ترجمه لحظهای: از بین بردن موانع زبانی در ارتباطات
- تولید محتوا: نوشتن خودکار برای اخبار، بازاریابی، گزارشها
مقایسه تفصیلی: A100 با ۸۰ گیگابایت در برابر ۴۰ گیگابایت
| ویژگی | A100 40GB | A100 80GB | بهبود |
|---|---|---|---|
| حافظه GPU | ۴۰ گیگابایت HBM2e | ۸۰ گیگابایت HBM2e | +۱۰۰٪ |
| پهنای باند حافظه (SXM) | ۱,۵۵۵ گیگابایت بر ثانیه | ۲,۰۳۹ گیگابایت بر ثانیه | +۳۱٪ |
| پهنای باند حافظه (PCIe) | ۱,۵۵۵ گیگابایت بر ثانیه | ۱,۹۳۵ گیگابایت بر ثانیه | +۲۴٪ |
| اندازه نمونه MIG | تا ۵ گیگابایت | تا ۱۰ گیگابایت | +۱۰۰٪ |
| آموزش DLRM | مبنا | ۳ برابر سریعتر | +۲۰۰٪ |
| استنتاج RNN-T | مبنا | ۱.۲۵ برابر سریعتر | +۲۵٪ |
| Quantum Espresso در HPC | مبنا | ۱.۸ برابر سریعتر | +۸۰٪ |
| تحلیل داده کلان | مبنا | ۲ برابر سریعتر | +۱۰۰٪ |
| حافظه یکپارچه در هر نود | تا ۶۴۰ گیگابایت (۸ GPU) | تا ۱.۳ ترابایت (۸ GPU) | +۱۰۳٪ |
| حداکثر اندازه مدل | حدود ۳۵-۳۸ میلیارد پارامتر | حدود ۷۰-۷۵ میلیارد پارامتر | حدود ۲ برابر |
| قیمت تقریبی | ۱۰ تا ۱۲ هزار دلار | ۱۵ تا ۱۷ هزار دلار | +۴۰ تا ۵۰٪ |
چه زمانی A100 با ۸۰ گیگابایت را انتخاب کنیم:
- آموزش مدلهای بزرگتر از ۴۰ میلیارد پارامتر
- پردازش مجموعه دادههایی که در ۴۰ گیگابایت جا نمیشوند
- اجرای چند مدل بزرگ با MIG (نمونههای ۱۰ گیگابایتی)
- شبیهسازیهای HPC که نیاز به حافظه عظیم دارند
- تحلیل داده کلان روی مجموعه دادههای چند ترابایتی
- آیندهنگری برای مدلهایی که رو به رشد هستند
چه زمانی A100 با ۴۰ گیگابایت کافی است:
- مدلهای زیر ۳۵ میلیارد پارامتر
- بارهای کاری استنتاج با حافظه کمتر
- استقرارهای با محدودیت بودجه
- چند مدل کوچکتر با MIG (نمونههای ۵ گیگابایتی)
- آموزش با اندازه بچ کوچکتر
مقایسه فرم فکتور PCIe در برابر SXM
| ویژگی | A100 80GB PCIe | A100 80GB SXM4 |
|---|---|---|
| فرم فکتور | کارت استاندارد PCIe | ماژول SXM |
| نصب | سرورهای استاندارد | سیستمهای HGX/DGX |
| TDP | ۳۰۰ وات | ۴۰۰ وات (۵۰۰ وات CTS) |
| پهنای باند حافظه | ۱,۹۳۵ گیگابایت بر ثانیه | ۲,۰۳۹ گیگابایت بر ثانیه |
| NVLink | ۲ GPU از طریق بریج | تا ۱۶ GPU |
| پهنای باند NVLink | ۶۰۰ گیگابایت بر ثانیه | ۶۰۰ گیگابایت بر ثانیه |
| خنککننده | هوایی یا مایع | فعال/مایع |
| انعطافپذیری | بالا (سرورهای استاندارد) | محدود (پلتفرمهای خاص) |
| عملکرد | عالی | حداکثری |
| مناسب برای | استقرارهای انعطافپذیر | بالاترین عملکرد |
| حداکثر GPU در هر سرور | ۸ تا ۱۰ | ۱۶ |
پشتیبانی نرمافزار و اکوسیستم
چارچوبهای یادگیری عمیق
- TensorFlow – بهینهسازی کامل برای معماری Ampere
- PyTorch – پشتیبانی بومی CUDA و هسته تنسور
- MXNet – بهینهشده برای آموزش توزیعشده
- JAX – تفاضل خودکار شتابدهندهشده سختافزاری
- ONNX Runtime – استنتاج میان چارچوبی
- Keras – API سطح بالا با شتابدهی A100
- PaddlePaddle – چارچوب بایدو با پشتیبانی GPU
- Caffe2 – چارچوب یادگیری ماشین فیسبوک
برنامههای HPC (بیش از ۲,۰۰۰ برنامه شتابدهندهشده GPU)
- دینامیک مولکولی: AMBER، GROMACS، NAMD، LAMMPS
- شیمی محاسباتی: Quantum Espresso، VASP، Gaussian
- CFD: ANSYS Fluent، OpenFOAM، Altair AcuSolve
- تحلیل ساختاری: ANSYS Mechanical، DS SIMULIA Abaqus
- آبوهوا/اقلیم: WRF، CESM، NEMO
- علم مواد: LAMMPS، VASP، CP2K
علم داده و تحلیل
- RAPIDS: کتابخانههای علم داده شتابدهندهشده GPU
- cuDF (دیتافریمهای شبیه Pandas)
- cuML (یادگیری ماشین شبیه Scikit-learn)
- cuGraph (گرافهای شبیه NetworkX)
- Apache Spark: شتابدهنده RAPIDS برای Spark
- Dask: محاسبات توزیعشده با پشتیبانی GPU
- BlazingSQL: موتور SQL شتابدهندهشده GPU
ابزارهای توسعه
- CUDA Toolkit نسخه ۱۱.۰ به بعد
- cuDNN نسخه ۸.۰ به بعد (کتابخانه شبکه عصبی عمیق)
- TensorRT نسخه ۷.۰ به بعد (بهینهساز استنتاج)
- NCCL (ارتباطات چند GPU)
- Nsight Systems (پروفایلینگ و دیباگ)
- NGC Containers (محیطهای پیشپیکربندیشده)
مجازیسازی و هماهنگی
- NVIDIA vGPU – نرمافزار GPU مجازی
- MIG – تقسیمبندی Multi-Instance GPU
- Kubernetes – افزونه دستگاه GPU
- Docker – ابزار کانتینر NVIDIA
- VMware vSphere – GPU Passthrough
- OpenShift – توزیع Kubernetes ردهت
پلتفرمهای ابری
- Amazon Web Services (AWS): نمونههای EC2 P4d
- Microsoft Azure: سری NDv4
- Google Cloud Platform: خانواده نمونه A2
- Oracle Cloud: نمونههای GPU
- Alibaba Cloud: نمونههای GN7
- IBM Cloud: نمونههای فعال GPU
نیازمندیهای سیستم و توصیهها
حداقل نیازمندیها (نسخه PCIe)
مادربرد
- اسلات PCIe 4.0 x16 (سازگار با PCIe 3.0)
- فضای فیزیکی کافی برای کارت دو اسلاته
- اسلات PCIe با کیفیت بالا (توصیه میشود سرور-گرید)
منبع تغذیه
- یک GPU: ۱,۲۰۰ وات (۸۰ پلاس گلد یا بهتر)
- دو GPU: حداقل ۱,۶۰۰ وات
- چهار GPU: ۲,۵۰۰ وات به بالا با افزونگی
- کانکتور اختصاصی PCIe ۸ پین EPS برای هر GPU
پردازنده
- پردازنده کلاس سرور (Xeon، EPYC)
- حداقل: Intel Xeon Gold/Platinum یا AMD EPYC نسل ۷۰۰۲/۷۰۰۳
- توصیه میشود: آخرین نسل برای بهترین پشتیبانی PCIe 4.0
حافظه
- حداقل: ۱۲۸ گیگابایت رم DDR4/DDR5
- توصیه شده: ۲۵۶ گیگابایت به بالا برای بارهای کاری هوش مصنوعی
- بهینه: ۵۱۲ گیگابایت تا ۱ ترابایت برای آموزش مقیاس بزرگ
ذخیرهساز
- SSDهای NVMe برای ذخیره مجموعه داده (PCIe 4.0 توصیه میشود)
- حداقل ۲ ترابایت برای سیستمعامل و مجموعه دادههای کاری
- پیکربندی RAID برای افزونگی داده
خنککننده
- راهحل خنککننده درجه مرکز داده
- نصب رک با جریان هوای مناسب
- دمای محیط: ۲۰ تا ۲۵ درجه سانتیگراد توصیه میشود
سیستمعامل
- لینوکس: اوبونتو ۲۰.۰۴/۲۲.۰۴، CentOS 7/8، RHEL 7/8/9
- ویندوز: ویندوز سرور ۲۰۱۹/۲۰۲۲
- درایور NVIDIA نسخه ۴۵۰.۵۱ یا جدیدتر
پیکربندیهای پیشنهادی سیستم
ایستگاه کاری هوش مصنوعی سطح ورودی (۱ عدد A100 80GB PCIe)
- پردازنده: Intel Xeon W-3375 یا AMD EPYC 7443P
- رم: ۲۵۶ گیگابایت DDR4-3200
- ذخیرهساز: ۲ عدد ۲ ترابایت NVMe PCIe 4.0 در RAID 0
- منبع تغذیه: ۱,۶۰۰ وات ۸۰ پلاس پلاتینیوم
- کاربرد: توسعه مدل، آموزش مقیاس کوچک
سرور هوش مصنوعی حرفهای (۲ تا ۴ عدد A100 80GB PCIe)
- پردازنده: دو عدد Intel Xeon Gold 6338 یا AMD EPYC 7543
- رم: ۵۱۲ گیگابایت تا ۱ ترابایت DDR4-3200
- ذخیرهساز: ۴ عدد ۴ ترابایت NVMe PCIe 4.0 در RAID 10
- شبکه: دو کارت شبکه ۱۰۰ گیگابیتی
- منبع تغذیه: ۲,۵۰۰ وات ۸۰ پلاس پلاتینیوم (افزونه)
- کاربرد: آموزش هوش مصنوعی سازمانی، تنظیم دقیق مدلهای بزرگ
خوشه HPC سازمانی (۸ عدد A100 80GB SXM)
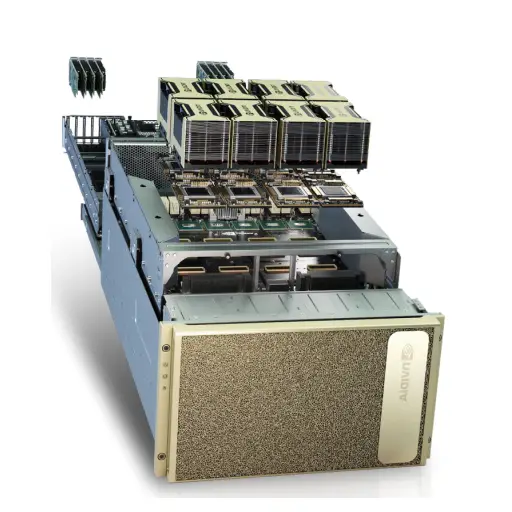
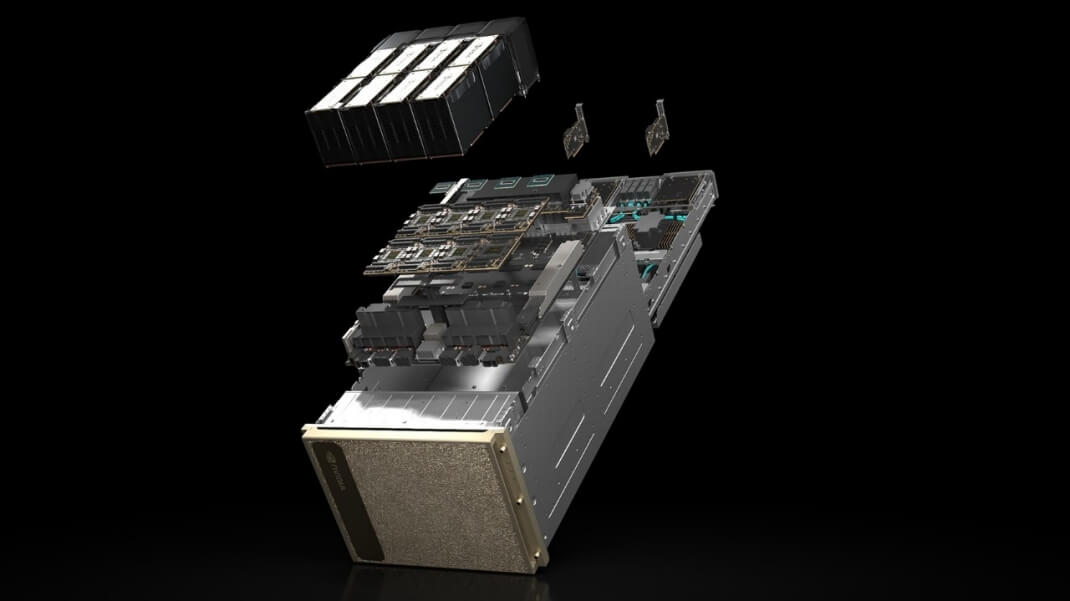
- پلتفرم: سیستم NVIDIA DGX A100 یا HGX A100
- پردازنده: دو عدد AMD EPYC 7742 (۱۲۸ هسته)
- رم: ۱ یا ۲ ترابایت DDR4-3200
- ذخیرهساز: ۱۵ ترابایت NVMe (پیکربندی RAID)
- شبکه: ۸ عدد ۲۰۰ گیگابیت بر ثانیه InfiniBand HDR
- NVSwitch: اتصال GPU به GPU با ۶۰۰ گیگابایت بر ثانیه
- کاربرد: آموزش هوش مصنوعی مقیاس بزرگ، شبیهسازیهای HPC
مرکز داده مقیاس ابری (۱۶ عدد A100 80GB SXM)
- پلتفرم: NVIDIA HGX A100 با ۱۶ GPU
- پردازنده: دو عدد AMD EPYC 7763 (۱۲۸ هسته)
- رم: ۲ ترابایت DDR4-3200
- ذخیرهساز: ۳۰ ترابایت NVMe و ذخیرهساز شبکه پتابایتی
- شبکه: InfiniBand HDR با GPUDirect RDMA
- کاربرد: آموزش مدلهای بنیادی، هوش مصنوعی ابرمقیاس
پرسشهای متداول
تفاوت انویدیا A100 با ۸۰ گیگابایت و ۴۰ گیگابایت چیست؟
پاسخ: A100 با ۸۰ گیگابایت دارای حافظه دو برابری (۸۰ گیگابایت در برابر ۴۰ گیگابایت)، پهنای باند بالاتر (۲ ترابایت بر ثانیه در مقابل ۱.۵۵ ترابایت بر ثانیه در SXM)، و اندازه نمونه MIG دو برابر (۱۰ گیگابایت در مقابل ۵ گیگابایت در هر نمونه) است. این به معنای آموزش تا ۳ برابر سریعتر برای مدلهای بزرگ، تحلیل داده ۲ برابر سریعتر، و توانایی رسیدگی به مدلهایی تا ۷۰ میلیارد پارامتر به بالا در مقابل حدود ۳۵ میلیارد برای نسخه ۴۰ گیگابایتی است.
Multi-Instance GPU (MIG) چیست و چرا مهم است؟
پاسخ: MIG به یک A100 اجازه میدهد تا به ۷ نمونه مستقل GPU تقسیم شود که هر کدام حافظه اختصاصی (۱۰ گیگابایت در مدل ۸۰ گیگابایتی)، کش و منابع محاسباتی جداگانه دارند. این امکان بهرهوری ۷ برابری برای بارهای کاری استنتاج، چندمستاجری امن با جداسازی سختافزاری، تضمین کیفیت سرویس (QoS)، و تخصیص انعطافپذیر منابع برای اندازههای مختلف بار کاری را فراهم میکند. برای ارائهدهندگان ابری و مراکز داده سازمانی عالی است.
PCIe در برابر SXM: کدام فرم فکتور را انتخاب کنیم؟
پاسخ:
- PCIe را انتخاب کنید اگر نیاز دارید: انعطافپذیری برای استفاده از سرورهای استاندارد، ارتقا و نگهداری آسانتر، پیکربندی ۱ تا ۸ GPU، مصرف برق کمتر (۳۰۰ وات)، استقرار مقرونبهصرفه.
- SXM را انتخاب کنید اگر نیاز دارید: حداکثر عملکرد (TDP ۴۰۰ وات)، بالاترین پهنای باند حافظه (۲,۰۳۹ گیگابایت بر ثانیه)، مقیاسپذیری ۸ تا ۱۶ GPU با NVSwitch، استقرارهای متراکم مرکز داده، بهترین عملکرد به ازای واحد رک.
آیا انویدیا A100 با ۸۰ گیگابایت میتواند تمام چارچوبهای اصلی هوش مصنوعی را اجرا کند؟
پاسخ: بله. A100 با تمام چارچوبهای اصلی هوش مصنوعی/یادگیری ماشین از جمله TensorFlow، PyTorch، MXNet، JAX، ONNX، Keras، PaddlePaddle و بیش از ۲,۰۰۰ برنامه شتابدهندهشده GPU که در کاتالوگ NVIDIA NGC موجود است، سازگار است.
چند عدد GPU انویدیا A100 میتوان به هم وصل کرد؟
پاسخ:
- نسخه PCIe: تا ۲ GPU از طریق NVLink Bridge، تا ۸ تا ۱۰ در هر سرور
- نسخه SXM: تا ۱۶ GPU به هم متصل شده از طریق NVSwitch با ۶۰۰ گیگابایت بر ثانیه به ازای هر GPU
- مقیاسپذیری چند نودی: نامحدود با شبکه InfiniBand
A100 با ۸۰ گیگابایت چه اندازه مدلهای هوش مصنوعی را میتواند آموزش دهد؟
پاسخ: A100 با ۸۰ گیگابایت میتواند آموزش دهد:
- تک GPU: مدلها تا حدود ۷۰ تا ۷۵ میلیارد پارامتر (بسته به بهینهسازی)
- ۸ GPU: مدلها تا ۵۰۰ تا ۶۰۰ میلیارد پارامتر
- چند نود: مدلهای تریلیون پارامتری به بالا (مثل GPT-3، GPT-4)
- با تکنیکهای کارآمد حافظه (gradient checkpointing، بهینهسازی ZeRO)، مدلهای حتی بزرگتر ممکن است
آیا انویدیا A100 برای بازی یا استفاده مصرفکننده مناسب است؟
پاسخ: خیر. A100 یک GPU محاسباتی مرکز داده بدون خروجی نمایشگر است که برای بارهای کاری سازمانی ۲۴/۷، آموزش/استنتاج هوش مصنوعی و HPC طراحی شده. برای بازی بهینه نشده است. برای بازی و ایستگاههای کاری مصرفکننده، سری GPUهای GeForce RTX را در نظر بگیرید.
طول عمر و قابلیت اطمینان معمول GPUهای A100 چقدر است؟
پاسخ: GPUهای A100 برای عملکرد ۲۴/۷ در مراکز داده طراحی شدهاند با میانگین زمان بین خرابیها (MTBF) معمولاً ۵ تا ۷ سال، حافظه ECC که در برابر فساد داده محافظت میکند، اجزای درجه سازمانی ساختهشده برای قابلیت اطمینان، و طراحی حرارتی بهینهشده برای بارهای کاری پایدار. بسیاری از مراکز داده برای چرخههای تازهسازی ۳ تا ۵ ساله برنامهریزی میکنند.
انویدیا A100 در مقایسه با H100/H200 جدیدتر چطور است؟
پاسخ:
- H100: برای برخی بارهای کاری هوش مصنوعی ۲ تا ۳ برابر سریعتر، حافظه HBM3، قیمت بالاتر
- H200: H100 با ۱۴۱ گیگابایت HBM3e، بهینهشده برای LLMها
- مزایای A100: اکوسیستم بالغتر، در دسترس بودن بیشتر، عملکرد به قیمت بهتر برای بسیاری بارهای کاری، هنوز برای اکثر کاربردها بسیار رقابتی
- توصیه: A100 با ۸۰ گیگابایت همچنان ارزش عالی برای بیشتر بارهای کاری هوش مصنوعی/HPC در سال ۲۰۲۵ است
نیازمندیهای برق و خنککننده انویدیا A100 چیست؟
پاسخ:
- PCIe: TDP ۳۰۰ وات، نیاز به برق اختصاصی ۸ پین PCIe، خنککاری هوایی استاندارد در رکهای با تهویه خوب
- SXM: TDP ۴۰۰ وات (۵۰۰ وات CTS)، نیاز به خنککاری مایع فعال در سیستمهای HGX/DGX
- خنککاری مرکز داده: حفظ دمای محیط ۲۰ تا ۲۵ درجه سانتیگراد برای عملکرد بهینه
- تامین برق: اطمینان از برق تمیز و پایدار با پشتیبان UPS
آیا میتوان از A100 برای استخراج ارز دیجیتال استفاده کرد؟
پاسخ: در حالی که از نظر فنی ممکن است، توصیه نمیشود و مقرونبهصرفه نیست. A100 برای بارهای کاری هوش مصنوعی/HPC بهینهشده است، نه الگوریتمهای استخراج. GPUهای GeForce عملکرد استخراج به قیمت بهتری ارائه میدهند. استفاده از A100 برای استخراج اتلاف قابل توجهی از قابلیتهای شتابدهی پیشرفته هوش مصنوعی آن خواهد بود.
A100 با چه گارانتی و پشتیبانیای عرضه میشود؟
پاسخ: NVIDIA A100 معمولاً شامل گارانتی استاندارد ۳ ساله (بسته به فروشنده متفاوت است)، گزینههای پشتیبانی سازمانی NVIDIA در دسترس، بهروزرسانیهای منظم درایور و وصلههای امنیتی، دسترسی به کانتینرهای NGC و نرمافزار بهینهشده، و گارانتیهای تمدیدشده از طریق شرکای NVIDIA است.
آیا A100 هنوز در سال ۲۰۲۵ مرتبط است؟
پاسخ: کاملاً بله. علیرغم نسلهای جدیدتر (H100/H200)، A100 همچنان زیرساخت اصلی برای شرکتهای بزرگ هوش مصنوعی، عملکرد عالی برای بیشتر بارهای کاری هوش مصنوعی، در دسترس بودن بهتر از نسلهای جدیدتر، نسبت عملکرد به قیمت برتر، قابلیت اطمینان اثباتشده و مجموعه نرمافزاری بالغ است و برای چندین سال آینده مرتبط خواهد ماند.
محتویات بسته
- ۱ عدد NVIDIA A100 80GB Tensor Core GPU (کارت PCIe یا ماژول SXM)
- راهنمای نصب و مستندات شروع سریع
- کارت گارانتی
- سختافزار نصب (براکت PCIe برای نسخه PCIe)
توجه: کابلهای برق، براکتهای اضافی و راهحلهای خنککننده ممکن است بسته به پیکربندی سیستم شما نیاز به خرید جداگانه داشته باشند.
چرا سوان تک را انتخاب کنیم؟
- محصولات اصل با گارانتی کامل سازنده
- پشتیبانی جدیدترین درایور و نرمافزار
مشاوره تخصصی متخصص
- مشاوره رایگان قبل از فروش برای تعیین نیازهای شما
- توصیههای پیکربندی سیستم
- راهنمایی بهینهسازی عملکرد
- پشتیبانی فنی ۲۴/۷
تحویل سریع و امن
- حمل و نقل سریع در دسترس
- بستهبندی ایمن برای سختافزار ارزشمند
- پوشش بیمه برای تمام محمولهها
- پیگیری سفارش بهصورت لحظهای
قیمتگذاری رقابتی
- بهترین قیمتهای بازار
- گزینههای پرداخت انعطافپذیر
- تخفیفهای حجمی برای چند واحد
- قیمتگذاری ویژه برای مشتریان سازمانی
خدمات حرفهای
- کمک در نصب و راهاندازی
- خدمات یکپارچهسازی سیستم
- پشتیبانی استقرار خوشه
- آموزش و کارگاههای آموزشی
برتری پس از فروش
- پشتیبانی فنی مداوم
- بهروزرسانیهای منظم فریمور و درایور
خلاصه عملکرد
عملکرد آموزش
- تا ۳ برابر سریعتر از A100 با ۴۰ گیگابایت برای مدلهای بزرگ
- ۲۰ برابر سریعتر از NVIDIA V100
- عملکرد ۳۱۲ ترافلاپس هسته تنسور FP16
- ۱۵۶ ترافلاپس TF32 برای شتابدهی خودکار
عملکرد استنتاج
- تا ۲۴۹ برابر سریعتر از سیستمهای فقط CPU
- ۱.۲۵ برابر سریعتر از A100 با ۴۰ گیگابایت برای مدلهای محدود به بچ
- ۶۲۴ عملیات تراپس INT8 با Structural Sparsity (۱,۲۴۸ تراپس)
- تاخیر زیر یک میلیثانیه برای بسیاری از برنامههای لحظهای
عملکرد HPC
- بهبود ۱۱ برابری نسبت به نسل P100
- ۱۹.۵ ترافلاپس هسته تنسور FP64 (انقلابی برای HPC)
- ۱.۸ برابر سریعتر از A100 با ۴۰ گیگابایت برای شبیهسازیهای حافظهمحور
- بازده استفاده از DRAM ۹۵ درصد
تحلیل داده
- ۲ برابر سریعتر از A100 با ۴۰ گیگابایت در بنچمارکهای داده کلان
- سرعت ۵ تا ۱۰ برابری با شتابدهنده RAPIDS برای Spark
- پردازش مجموعه دادههای در مقیاس ترابایت در چند دقیقه
جمعبندی
NVIDIA A100 80GB Tensor Core GPU استاندارد طلایی در محاسبات مرکز داده است و عملکرد، انعطافپذیری و مقیاسپذیری بیسابقهای را برای سختگیرترین بارهای کاری هوش مصنوعی، یادگیری ماشین، تحلیل داده و محاسبات علمی ارائه میدهد. با ویژگیهای انقلابی مانند ۸۰ گیگابایت حافظه فوقسریع HBM2e، هستههای تنسور نسل سوم، فناوری Multi-Instance GPU، و اتصال NVLink با ۶۰۰ گیگابایت بر ثانیه، A100 با ۸۰ گیگابایت آنچه در محاسبات مدرن ممکن است را متحول میکند.
چه در حال آموزش نسل بعدی مدلهای زبانی بزرگ باشید، تحقیقات علمی پیشگام انجام دهید، مجموعه دادههای عظیم را تحلیل کنید، یا سرویسهای هوش مصنوعی تولیدی را در مقیاس بزرگ مستقر کنید، A100 با ۸۰ گیگابایت عملکرد، قابلیت اطمینان و ویژگیهای سازمانی موردنیاز برای ماندن در صدر نوآوری را فراهم میکند.
در A100 با ۸۰ گیگابایت سرمایهگذاری کنید و پتانسیل کامل ابتکارات هوش مصنوعی و HPC خود را باز کنید. آینده محاسبات اینجاست و با NVIDIA Ampere قدرت میگیرد.



نقد و بررسیها
پاککردن فیلترهاهنوز بررسیای ثبت نشده است.